الإجابات · الأساسيات
هل يستطيع الذكاء الاصطناعي صنع فيديوهات؟
تم التحديث في 17 نوفمبر 2026

ما الذي يستطيع فيديو الذكاء الاصطناعي فعله الآن
يأخذ نموذج الفيديو وصفًا، أي ما في الإطار وما الذي يتحرك وما الذي تفعله الكاميرا، ويعيد لقطات. والنماذج الأفضل تأخذ أيضًا صورًا مرجعية، فيمكن عرض شخصية أو غرفة بدلًا من وصفها فقط. وفي SceneMixer يتراوح المقطع المولّد الواحد عادة بين بضع ثوانٍ وخمس عشرة، وحتى ثلاثين على بعض الفئات، بدقات من 480P حتى فئة 2K، ويخرج بصوته المدمج فيه: وقع الخطوات، والمطر، وحوار تنطقه الشخصيات بإحدى 15 لغة. والاهتمام واسع؛ والبداية من أكبر الموضوعات في مجموعة النقاش، بنحو 11,000 منشور.
لم تعد الأساليب حدًّا أيضًا. فالتصوير الحي السينمائي، والأنمي، والرسوم ثلاثية الأبعاد العائلية، والصلصال، والأساليب التصويرية كلها تأتي من الأدوات نفسها، ويمكن قفل مشروع كامل على أحدها.
أين ما زال يتعثر
الجزء الصعب ليس صنع مقطع. إنه جعل المقطع الثاني يتفق مع الأول. وقد طرح شخص يفكر في البدء السؤال الذي يدور حوله معظم الوافدين الجدد:
هل هذا المستوى من التحكم الدقيق والاتساق عبر عدة صور ممكن الآن بالذكاء الاصطناعي، أم أنه ما زال بعيد المنال؟
كان ذلك سؤالًا في r/generativeAI، والجواب الصادق له ثلاثة أجزاء. الوجوه والأماكن تصمد جيدًا حين تُولَّد كل لقطة من الصور المرجعية نفسها؛ وتنحرف حين تُوصف كل لقطة من الصفر. والتفاصيل الصغيرة، كالأصابع والمجوهرات والكتابة على لافتة، ما زالت تنجرف. وبعض الأشياء تبقى ضعيفة فعلًا: النص المقروء داخل الصورة، واللقطات الطويلة جدًا بلا قطع، والأطر المزدحمة حيث يفعل عدة أشخاص عدة أشياء في وقت واحد.
من مقطع واحد إلى فيديو كامل
الفيديو الذي يجلس الناس لمشاهدته هو عدة مقاطع تتفق مع بعضها، وهذا الاتفاق يُبنى قبل أن يُصيَّر أي شيء. وفي SceneMixer الترتيب ثابت: يُقرأ السيناريو إلى شخصيات وأماكن وأدوات؛ ويحصل كل شخص على ورقة مرجعية لكامل الجسد، ويحصل كل مكان على صورة؛ وتُكتب كل حلقة كقصة مصورة من لقطات مرقمة؛ وتُولَّد المقاطع من ذلك النص مع إرفاق الأوراق، ويبدأ كل منها من حيث انتهى سابقه؛ ثم تُدمج المقاطع في ملف واحد. النموذج هو من يرسم، والترتيب هو من يتذكر.
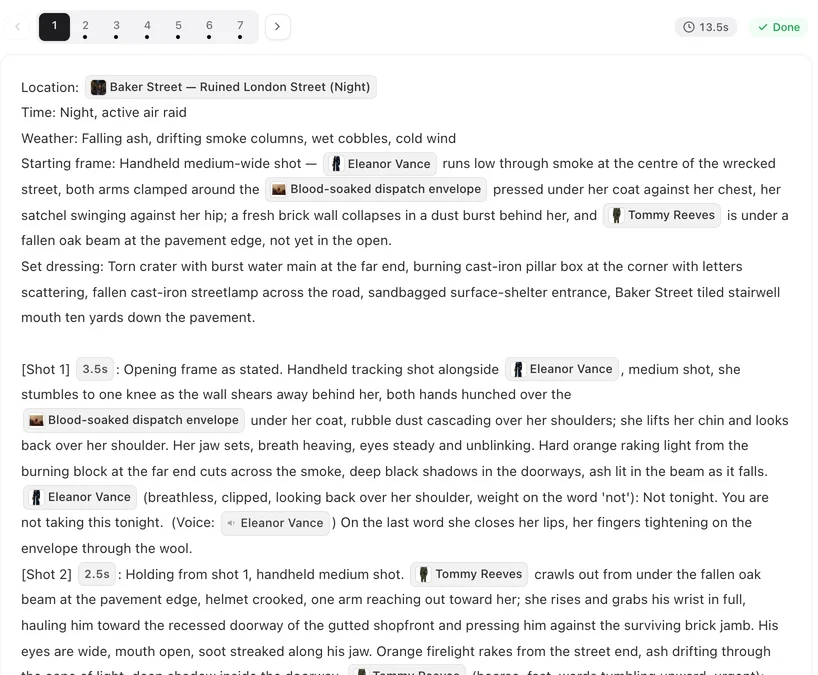
هل يستطيع الذكاء الاصطناعي أن يصنع فيديو لي من فكرة فقط؟
نعم، مع القليل من المساعدة. اكتب سطرًا في «AI Create» واختر طولًا، فيصبح سيناريو كاملًا تستطيع قراءته وتغييره قبل أن يُرسم أي شيء. وإن كانت لديك كلمات بالفعل، كسيناريو أو فصل أو قصة، فارفعها بدلًا من ذلك، وستحفظ القراءة حوارك. وتوجد نقطتا بداية أخريان لمهام محددة: صورة منتج لإعلان، ومقطع موجود يصل إلى بضع دقائق لإعادة صنعه بطاقم جديد. وفي كل الحالات ترى الطاقم وقائمة اللقطات قبل أن تدفع ثمن الفيديو، وهنا يكمن معظم التحكم.
كم يكلّف اكتشاف ذلك
التجربة رخيصة؛ أما الإنهاء فمدفوع. يحصل حساب SceneMixer الجديد على 50 رصيد تسجيل، وصور إعداد مجانية للشخصيات والأماكن الأولى، والقصة المصورة للحلقة الأولى ولقطة معاينة قصيرة واحدة. وبعد ذلك يُسعَّر الفيديو بالثانية، ويظهر السعر على الزر قبل أن تضغط. ويكلّف مقطع مدته دقيقة على الفئة الافتراضية 660 رصيد مع الجمع، قبل إعادة التصوير. ويشرح لماذا يكلّف فيديو الذكاء الاصطناعي ما يكلّفه أين يذهب ذلك المال.
متى لا تستخدم فيديو الذكاء الاصطناعي
- حين يجب أن يُظهر الفيديو شخصًا حقيقيًا، أو منتجًا حقيقيًا كما هو في الحركة، أو حدثًا حقيقيًا: فالمادة المولّدة مختلقة لا مسجّلة.
- حين تعتمد الرسالة على نص يظهر على الشاشة؛ أضف الكلمات في محرر بدلًا من ذلك.
- حين تحتاج إلى لقطة متصلة واحدة تدوم عدة دقائق؛ فالمشاهد المولّدة تُجمع من مقاطع أقصر.
- حين يكون المطلوب شخصية مشهورة أو فيلمًا معروفًا؛ فهذه الطلبات تُرفض.
- عدد المجتمع تقريب قائم على تصنيفات بقواعد لمجموعة ثابتة من المنشورات العامة.
الأسئلة الشائعة
هل تستطيع صنع فيديوهات بالذكاء الاصطناعي مجانًا؟
جزئيًا. تتيح SceneMixer لحساب جديد أن يجرب العملية كلها: رصيد التسجيل، وصور الإعداد المجانية، والقصة المصورة الأولى، ومعاينة قصيرة؛ ويُحتسب الفيديو المنتهي بالثانية.
هل يستطيع الذكاء الاصطناعي إنتاج فيديوهات بصوت وحوار؟
نعم. تخرج مقاطع SceneMixer بصوتها المدمج، وتنطق الشخصيات سطورها في الفيديو، بصوت لكل واحدة.
هل يستطيع الذكاء الاصطناعي توليد فيديوهات أطول من بضع ثوانٍ؟
التوليد الواحد قصير. وتجمع SceneMixer مقاطع يصل كل منها إلى خمس عشرة أو ثلاثين ثانية في حلقة واحدة، فيأتي الطول من الجمع.
هل يستطيع الذكاء الاصطناعي صنع فيديو لي؟
نعم. في SceneMixer يتحول سطر في «AI Create» إلى سيناريو، ويتحول السيناريو إلى طاقم وقصة مصورة، وتتحول القصة المصورة إلى فيديو تشاهده لقطة بلقطة.
ذو صلة: ما هو فيديو الذكاء الاصطناعي بعبارات بسيطة، ومتى يبدأ فيديو الذكاء الاصطناعي في أن يبدو حقيقيًا، وكيف تكتب لقطة واحدة، وطريقة الجمع التي تقف خلف الرقم المجتمعي.
جرّب فكرة واحدة
سطر في «AI Create»، وطاقم، وقصة مصورة، ولقطة معاينة مجانية واحدة، قبل أن تدفع ثمن الفيديو.
سجّل مجانًاأسعار الفيديو لكل ثانية موجودة في صفحة الأسعار بالأرقام نفسها.