الإجابات · الإنتاج
كيف تُصنع فيديوهات الذكاء الاصطناعي؟
تم التحديث في 18 نوفمبر 2026

لماذا يستمر الناس في السؤال
قد يبدو فيديو الذكاء الاصطناعي المقنع مستحيلًا لمن لم يرَ إلا صورًا ثابتة مولّدة. كتب أحد المشاهدين، بعد أن أُخبر أن مقطعًا أعجبه مولّد بالذكاء الاصطناعي:
رأيت بعض الناس يقولون إنه ذكاء اصطناعي لكنني لا أستطيع أن أفهم كيف صُنع هذا بقدرات الذكاء الاصطناعي الحالية
جاء ذلك من منشور عنوانه السؤال نفسه في r/generativeAI. وجانب الحرفة في الجواب موضوع كبير بذاته: الموجّهات وتوجيه الكاميرا تستحوذ على نحو 22,000 منشور في مجموعة النقاش. والخلاصة أن هناك طبقتين: ما يفعله النموذج، وما يُفعل حوله.
داخل النموذج: من الضجيج إلى الإطارات
تتعلم معظم نماذج الفيديو الحالية من كميات هائلة من اللقطات المقرونة بأوصاف. وللتوليد تبدأ بضجيج عشوائي وتصقله على خطوات كثيرة، تدفع فيها كل خطوة الإطارات أقرب إلى شيء يطابق الوصف وأي صور مرجعية مقدّمة. والناتج مقطع قصير، عادة من بضع ثوانٍ حتى خمس عشرة أو ثلاثين، لأن الحفاظ على اتساق كل إطار يصبح أصعب كلما طال المقطع. وتضيّق الصور المرجعية باب التخمين: فمع صورة لشخصية يرسم النموذج ذلك الشخص، بدل أن يخترع شخصًا جديدًا يناسب الكلمات فقط. وفي النماذج الحالية يُولَّد الصوت، كوقع الخطوات والمطر وشخصية تنطق سطرًا، في المرور نفسه لا يُضاف بعد ذلك.
ولهذا يعجز النموذج وحده عن حمل قصة. فهو يرى طلبًا واحدًا في كل مرة. ولا يتذكر أن المحقق كان يرتدي معطفًا رماديًا في المقطع السابق، ما لم يُرِه الطلب التالي المعطف.
الخطوة الأولى: الكلمات
تبدأ القصة كسيناريو أو فصل أو سطر واحد. وفي SceneMixer يُقرأ النص إلى شخصيات وأماكن وأدوات وحلقات، ولكل حلقة مخطط. وهذه أرخص خطوة، وهي التي تقرر أكثر الأشياء.
الخطوة الثانية: المراجع
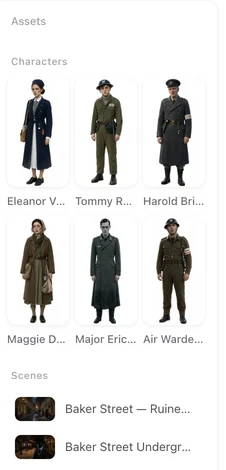
يحصل كل شخص على ورقة مرجعية لكامل الجسد، ويحصل كل مكان على صورة، وكلها مرسومة بالأسلوب البصري المختار في البداية. هذه هي الذاكرة التي يفتقدها النموذج: قصاصات الوجه والجسد من الورقة تُرفق بكل مقطع تظهر فيه الشخصية.
الخطوة الثالثة: اللقطات نصًا
تُكتب كل حلقة كقصة مصورة: المكان، والوقت، والإطار الافتتاحي، ثم اللقطات مرقّمة مع ثوانيها والكاميرا والحركة والسطر المنطوق. وتعديل هذا النص لا يستدعي أي نموذج ولا يكلّف شيئًا، لذلك يحدث معظم الإخراج هنا. واللقطة التي تُقرأ بوضوح، أي مكان واحد وحركة واحدة وكاميرا تفعل شيئًا واحدًا، لقطة يستطيع النموذج رسمها؛ ويشرح كيف تكتب لقطة واحدة العادات التي تجعل اللقطة المكتوبة موثوقة، من الإطار الافتتاحي إلى طول السطر.
الخطوة الرابعة: مقاطع بصوت
تُولَّد بعض اللقطات في مكان واحد معًا كمقطع، مع إرفاق الصور المرجعية المناسبة، ويخرج المقطع وصوته داخله. ويبدأ المقطع التالي من حيث انتهى السابق، فتنتقل الحركة عبر القطع. والمقطع الذي يخطئ يُصلح بتغيير كلماته وإعادة توليده وحده.
الخطوة الخامسة: الدمج والإنهاء
تُدمج المقاطع في حلقة واحدة، بسعر 1 رصيد للثانية من الطول النهائي، مع موسيقى تصويرية تلقائية يمكن إيقافها. ويمكن رفع المقطع المنتهي درجة دقة واحدة في كل مرة بخيار «تحسين» حتى 2K، ويحمل الملف شارة صغيرة للذكاء الاصطناعي وعلامة وصفية على الحسابات المجانية. وحسب ما قيس على SceneMixer خلال الأيام الـ30 حتى 6 نوفمبر 2026، كانت الحلقة كاملة جاهزة عادة بعد 24 دقيقة من بدء أول مقطع.
قيود طريقة صنع فيديو الذكاء الاصطناعي
- اللقطات مُختلقة لا مسجّلة؛ ولم يحدث شيء منها.
- النتائج تختلف من توليد إلى آخر، لذا خطط لإعادة تصوير بين حين وآخر.
- الكتابة داخل الصورة غير موثوقة، لذا تُضاف العناوين لاحقًا.
- الاتساق يعتمد على المراجع؛ ولقطة وُصفت من الصفر قد تنجرف رغم ذلك.
- زمن الحلقة متوسط شهر واحد من موقع واحد، وعدد الموضوعات تقدير قائم على قواعد.
الأسئلة الشائعة
كيف تُصنع أفلام الذكاء الاصطناعي؟
بالطريقة نفسها، لكن على مدى أطول: سيناريو، وأوراق مرجعية للطاقم، وقصة مصورة لقطة بلقطة، ومقاطع كثيرة، ثم جمع. ونوع «فيلم» في SceneMixer يزيل حد طول الحلقة.
هل تستخدم فيديوهات الذكاء الاصطناعي لقطات حقيقية؟
لا. اللقطات المولّدة جديدة؛ والصور المرجعية توجهها، لكن لا يوجد فيديو مسجّل للمشهد أصلًا.
كم يستغرق صنع فيديو بالذكاء الاصطناعي؟
يستغرق التصيير دقائق لكل مقطع، والمقاطع تُنجز جنبًا إلى جنب؛ أما الكتابة والمراجعة فتستغرقان أكثر من التوليد.
ماذا أحتاج لصنع فيديو بالذكاء الاصطناعي؟
فكرة أو سيناريو، ومظهر، وطاقم مرسوم مرة واحدة. يكفي حاسوب ومتصفح؛ لا حاجة إلى كاميرا أو بطاقة رسوميات.
كيف يعمل فيديو الذكاء الاصطناعي؟
يحوّل نموذج الفيديو الوصف النصي، وغالبًا مع صور مرجعية، إلى بضع ثوانٍ من الصور المتحركة. تُخطَّط الفيديوهات الأطول كسلسلة من هذه اللقطات ثم تُوصل ببعضها، ويضيف SceneMixer خطوات السيناريو والطاقم والستوريبورد حول النموذج.
ذو صلة: ما هو فيديو الذكاء الاصطناعي، وما الذي يستطيعه وما لا يستطيعه بعد، وطريقة الجمع التي تقف خلف عدد الموضوعات.
اتبع الخطوات على قصتك
الكلمات، والمراجع، واللقطات، والمقاطع، والدمج. شاهد كل خطوة قبل أن تدفع ثمن التالية.
سجّل مجانًاأسعار الفيديو لكل ثانية موجودة في صفحة الأسعار بالأرقام نفسها.