الإجابات · الواقعية
كيف تصنع فيديوهات واقعية بالذكاء الاصطناعي؟
تم التحديث في 17 نوفمبر 2026

لماذا يبدو فيديو الذكاء الاصطناعي مزيفًا
العلامة نادرًا ما تكون خطأً كبيرًا واحدًا. إنها سطح ناعم أكثر من اللازم، وضوء يأتي من لا مكان، وأناس يتحركون كأن لا وزن لهم. وقد لخّص شخص يقارن لقطتين أشيع شكوى في جملة:
أرى أن الثانية أفضل، لكن لها لمسة بلاستيكية أكثر.
كان ذلك سؤالًا مقارنًا في r/generativeAI. أما السؤال الأوسع، وهو متى يبدأ فيديو الذكاء الاصطناعي في أن يبدو حقيقيًا، فيظهر في نحو 76 منشورًا في مجموعة النقاش. وكل جزء من الجواب قرار تتخذه قبل التصيير.
ابدأ من مظهر التصوير الحي
في SceneMixer يُختار الأسلوب في الخطوة 1 ويُثبَّت للمشروع. وللواقعية اختر أسلوبًا حيًا: «HD رقمي» للمظهر الواضح لدراما البث، و«مصوّر على فيلم» للحبيبات واللون الدافئ، و«توهج ناعم» لجو باهت وشاحب، أو «فيلم أبيض وأسود». والأسلوب المتحرك لن يمر أبدًا كلقطة مصورة، مهما بلغت جودة التصيير.
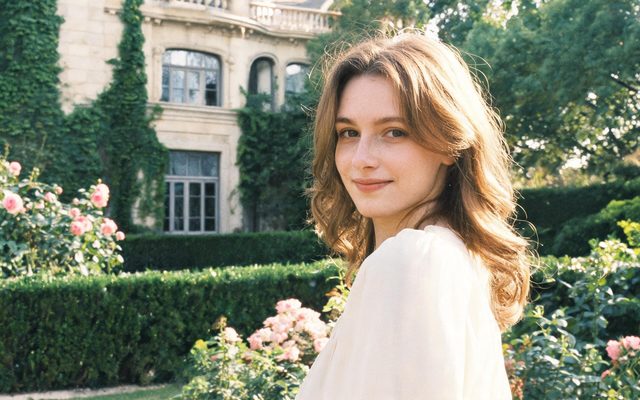
وجوه بعيوب
الوصف العام ينتج وجوهًا عامة لا عيب فيها، والخلو من العيوب يبدو مزيفًا. صِف الوجه كما تكتب ملاحظة الاختيار للممثلين: امرأة في الأربعينات بندبة خفيفة تعبر أحد حاجبيها، ونمش على الأنف، وشعر يشيب عند الصدغين ومربوط على عجل. تحفظ ورقة المرجع هذه التفاصيل في كل لقطة، وهذا يحل أيضًا مشكلة الواقعية الثانية: وجه يتغير بين القطعات.
ضوء يأتي من مكان ما
للّقطة الحقيقية مصدر ضوء يمكن الإشارة إليه. اكتبه داخل كل لقطة: مصباح مكتب من اليسار، وشمس متأخرة عبر الستائر، وباب ثلاجة يُفتح في مطبخ مظلم. الضوء الذي له سبب يمنح الظلال اتجاهًا، والظلال ذات الاتجاه هي معظم ما يجعل الإطار يبدو مصورًا.
حركات مادية وطواقم صغيرة
اكتب الحركة كسبب ونتيجة: تدفع الباب بكتفها ليُفتح؛ يرتجّ الكوب على الصحن حين يمر القطار. الحركة بلا وزن علامة فاضحة، والفعل الذي له سبب يمنح النموذج شيئًا ماديًا يُظهره. أبقِ شخصين أو ثلاثة في كل لقطة؛ فالأطر المزدحمة هي ما تنكسر فيه الأيدي والوجوه والاستمرارية أولًا.
فحص الواقعية قبل التصيير
اقرأ كل لقطة في القصة المصورة واطرح خمسة أسئلة. هل سُمّي مصدر ضوء، وهل يطابق وقت اليوم في رأس المقطع؟ هل الفعل شيء له وزن، كدفعة أو سحب أو سقوط أو مد يد، لا مجرد مزاج؟ هل في الإطار ثلاثة أشخاص أو أقل؟ هل يتضمن وصف الشخصية شيئًا واحدًا على الأقل يلاحظه مدير الاختيار، كندبة أو انحناءة أو عادة بيديه؟ وهل في اللقطة شيء يُقصد قراءته، كلافتة أو شاشة هاتف، ولن يخرج واضحًا؟ إصلاح أي من هذه في النص لا يكلّف شيئًا. أما اكتشافها بعد التصيير فيعني دفع ثواني المقطع نفسها مرتين، وهذه أكثر طريقة شيوعًا تغلو بها الواقعية.
المرحلة الأخيرة: فئة أعلى و«تحسين»
صمّم المسودة على فئة رخيصة طالما الكلمات ما زالت تتغير. وحين يكون المقطع صحيحًا، صيّر المختار على فئة أعلى، فتزداد الحدة مع الفئة من 480P إلى 1080P وفئة 2K في القمة، واحتفظ بكل مختارات الحلقة على الفئة نفسها كي لا يُعاد ترميز الجمع. ثم يرفع «تحسين» المقطع المنتهي درجة دقة واحدة في كل مرة، حتى 2K، دون صنع لقطة جديدة. ويشرح جعل فيديو الذكاء الاصطناعي يبدو واقعيًا كل قرار بأمثلة.
قيود فيديو الذكاء الاصطناعي الواقعي
- صور الأشخاص الحقيقيين مرفوضة كمراجع، لذا يجب أن تأتي الواقعية من وجوه مخترعة.
- قد تطلب المنصات وسم فيديو الذكاء الاصطناعي الفوتوغرافي الواقعي؛ وتلك الخطوة عليك عند النشر.
- الأيدي والنصوص على الأشياء والمشاهد المزدحمة ما زالت تحتاج محاولات أكثر من لقطة ثنائية قريبة.
- كلمات الجودة مثل «تحفة» أو «فائق الواقعية» لا تغيّر ما يستطيع النموذج رسمه.
- عدّ أسئلة الواقعية قائم على مطابقة بقواعد لنافذة ثابتة من النقاشات العامة.
الأسئلة الشائعة
هل تفيد موجّهات مثل 8K أو فائق الواقعية؟
لا. لا تضيف شيئًا يستطيع النموذج وضعه في الإطار؛ الذي يفعل ذلك هو وجوه محددة، ومصدر ضوء، وأفعال مادية.
هل أستطيع استخدام وجه شخص حقيقي؟
لا. صور المراجع التي تشبه وجه شخص حقيقي مرفوضة؛ اخترع الوجوه بدلًا من ذلك.
أي أسلوب يبدو أكثر واقعية في SceneMixer؟
أساليب التصوير الحي في SceneMixer: «HD رقمي» لمظهر حديث واضح، و«مصوّر على فيلم» للحبيبات والدفء.
هل يحتاج فيديو الذكاء الاصطناعي الواقعي إلى وسم؟
تطلب عدة منصات من صانعي المحتوى وسم فيديو الذكاء الاصطناعي الفوتوغرافي الواقعي. تحقق من القواعد الحالية لكل منصة؛ وهذا ليس نصيحة قانونية.
كيف أجعل فيديو الذكاء الاصطناعي واقعيًا بعد أن يُصيَّر؟
في الغالب لا يمكنك إصلاح الواقعية لاحقًا: غيّر الوصف والضوء والحركة، ثم أعد التوليد. و«تحسين» في SceneMixer يرفع الحدة درجة واحدة دون أن يغيّر اللقطة نفسها.
ذو صلة: متى يبدأ فيديو الذكاء الاصطناعي في أن يبدو حقيقيًا، ومدونة فيديو واقعية بالذكاء الاصطناعي، وطريقة الجمع التي تقف خلف العدد.
اختر مظهر تصوير حي
وجوه بعيوب، وضوء له مصدر، وشخصان أو ثلاثة في كل لقطة. أنهِ على فئة أعلى.
سجّل مجانًاأسعار الفيديو لكل ثانية موجودة في صفحة الأسعار بالأرقام نفسها.