الإجابات · الجودة
كيف تصنع فيديوهات بالذكاء الاصطناعي جيدة؟
تم التحديث في 17 نوفمبر 2026

الفرق بين الجيد والرديء
معظم من يطلبون أدوات أفضل يريدون في الحقيقة الفرار من مظهر المقاطع المولّدة بالذكاء الاصطناعي بالجملة. وقد كتب أحد الصانعين طلبه في سطر واحد:
أبحث عن شيء واقعي وجيد، لا عن محتوى ذكاء اصطناعي رديء.
جاء السطر من خيط في r/generativeAI يسأل عن الأدوات التي يجب تجربتها. والرداءة نادرًا ما تكون مشكلة أداة؛ إنها مقطع لا سبب لوجوده، يُوصف بكومة من الصفات، ويظهر فيه وجه يتغير بين القطعات. ونحو 58 منشورًا في مجموعة النقاش تسأل كيف تتعلم كتابة موجّهات تعطي نتائج جيدة؛ ومعظم الجواب في الأسفل، وقليل منه يتعلق بكلمات ذكية.
ابدأ بسبب يدفع إلى المشاهدة
الفيديو الجيد بالذكاء الاصطناعي يملك الشيء نفسه الذي يملكه الفيديو الجيد المصنوع بيد البشر: لحظة، أو سؤال، أو قصة. محقق يجد الجثة الخاطئة. قطة ترفض السرير الجديد. غريبان عالقان في مصعد. اكتب ذلك في جملة قبل كتابة أي لقطة. إن لم تكن الجملة مثيرة، فلن يصلحها أي مستوى تصيير. اختبرها على صديق: إن سأل ماذا يحدث بعد ذلك، فلديك فيديو؛ وإن أومأ بأدب، فاستمر في البحث عن اللحظة.
اكتب جملًا لا وسومًا
تقرأ النماذج الوصف كجملة. وسلاسل مثل «تحفة، أفضل جودة، 8K، سينمائي، حجمي» لا تضيف شيئًا يستطيع النموذج وضعه في الإطار، وتدفع الكلمات المهمة إلى أسفل، وتُرسم أحيانًا حرفيًا: اطلب ضبابًا حجميًا فيظهر الضباب. قل ما يقوله مدير التصوير: أين الكاميرا، وماذا تراه، ومن أين يأتي الضوء. واختر المظهر العام بإعداد الأسلوب البصري لا بالصفات.
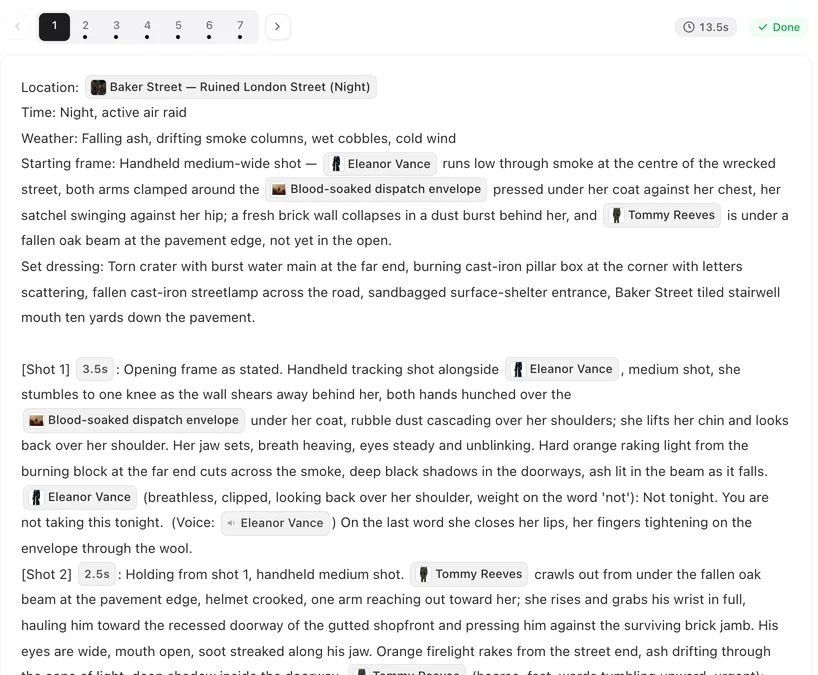
حركة واحدة لكل لقطة، وطاقم يصمد
امنح كل لقطة شيئًا واحدًا لتفعله: تفتح الدرج؛ يستدير؛ يرتجف المصباح. ثلاث حركات في لقطة واحدة تعود كضبابية تجمعها كلها. أبقِ شخصين أو ثلاثة في الإطار، وتأكد أن كل شخصية متكررة تأتي من ورقة مرجعية واحدة، لأن الوجه الذي يتغير بين القطعات أسرع طريقة لخسارة المشاهد. وفي SceneMixer تُرفق الورقة بكل مقطع تظهر فيه الشخصية.
قبل وبعد
هذه اللقطة نفسها مكتوبة بطريقتين. قبل: تحفة سينمائية، 8K، إضاءة درامية، امرأة غامضة في غرفة مظلمة، عاطفية، تفاصيل فائقة. بعد: لقطة متوسطة قريبة. امرأة في الأربعينات تجلس إلى طاولة مطبخ ليلًا، تضيئها الثلاجة المفتوحة خلفها وحدها؛ تدير خاتم زواج على الطاولة، ولا ترفع عينيها حين يُفتح الباب. تعطي النسخة الأولى النموذج صفات ولا شيء يُعرض. أما الثانية فتعطيه مكانًا، ومصدر ضوء، وشخصًا واحدًا، وفعلًا واحدًا، ولحظة توتر، وهذا كل ما يحتاجه الإطار. اكتب كل لقطة كالنسخة الثانية، وسترتفع جودة الفيديو كله قبل أن تغيّر أي إعداد. وفي SceneMixer يعيش هذا النص في القصة المصورة، حيث إعادة كتابته مجانية.
الصوت والإيقاع والمرحلة الأخيرة
أبقِ السطور المنطوقة قصيرة بما يكفي للقطتها، نحو ثلاث كلمات في الثانية بالإنجليزية، واترك نبضة صامتة حيث يجب أن تقع ردة الفعل. ابدأ من شيء يحدث بالفعل، واختم بشيء غير محسوم إن كان هناك جزء تالٍ. صمّم مسودة كل مقطع على فئة رخيصة، وأصلح الكلمات، ثم صيّر المختار مرة واحدة على الفئة التي تريد نشرها. احكم على النتيجة من الملف المحمّل ومن الشاشة التي سيستخدمها الجمهور. شاهده مرة بلا صوت ومرة وعيناك مغمضتان؛ فالفيديو الجيد ينجح في الاتجاهين.
قيود: ما الذي لا يستطيع الجيد فعله بعد
- النص القابل للقراءة داخل الإطار ما زال غير موثوق؛ أضفه لاحقًا.
- اللقطة المتصلة الواحدة تدوم مقطعًا واحدًا على الأكثر؛ والمشاهد الأطول تُجمع بقطعات.
- المشاهد المزدحمة والأيدي تحتاج محاولات أكثر حتى حين تكون الكتابة جيدة.
- المظهر القوي لا ينقذ فكرة ضعيفة.
- عدّ تعلم الموجّهات تطابق بقواعد لنافذة ثابتة من النقاشات العامة.
الأسئلة الشائعة
هل تجعل كلمات الجودة مثل 8K فيديوهات الذكاء الاصطناعي أفضل؟
لا. نماذج SceneMixer تقرأ الجمل لا الوسوم؛ صِف المكان والضوء والحركة بدلًا من ذلك.
ما الذي يجعل فيديو الذكاء الاصطناعي يبدو كمحتوى رديء؟
لا سبب لمشاهدته، وكومة من الصفات بدل مشهد، ووجوه تتغير بين اللقطات.
كم شخصًا ينبغي أن يكون في لقطة ذكاء اصطناعي واحدة؟
شخصان أو ثلاثة. الأطر المزدحمة هي ما ينكسر فيه الوجه والأيدي والاستمرارية أولًا.
كيف أجعل فيديوهات الذكاء الاصطناعي أفضل دون إنفاق أكثر؟
أصلح القصة ونص اللقطات أولًا، فالتعديل مجاني في SceneMixer؛ ثم صمّم المسودة بأرخص سعر، وصيّر المختار فقط على فئة أفضل.
ذو صلة: جعل فيديو الذكاء الاصطناعي واقعيًا، ولماذا لا تفعل الكلمات السحرية شيئًا، وطريقة الجمع التي تقف خلف العدد.
اكتب مشهدًا جيدًا واحدًا
سبب للمشاهدة، وجمل بسيطة، وحركة واحدة لكل لقطة. اقرأه قبل أن يُصيَّر.
سجّل مجانًاأسعار الفيديو لكل ثانية موجودة في صفحة الأسعار بالأرقام نفسها.