Antworten · Qualität
Wie erstellt man gute KI-Videos?
Aktualisiert 17. November 2026

Der Unterschied zwischen gut und Schrott
Die meisten, die nach besseren Tools fragen, wollen eigentlich dem Look massenproduzierter KI-Clips entkommen. Ein Creator brachte den Wunsch in einer Zeile auf den Punkt:
ich suche etwas Realistisches und Gutes, keinen KI-Schrott.
Der Satz stammt aus einem Thread in r/generativeAI, in dem nach Tools gefragt wurde. Schrott ist selten ein Tool-Problem. Es ist ein Clip ohne Grund zu existieren, mit einem Haufen Adjektive beschrieben und einem Gesicht, das sich zwischen Schnitten verändert. Rund 58 Beiträge im Korpus der Community fragen, wie man Prompts schreibt, die gute Ergebnisse liefern. Der größte Teil der Antwort steht unten, und sehr wenig davon hat mit klugen Wörtern zu tun.
Fang mit einem Grund zum Zuschauen an
Ein gutes KI-Video hat dasselbe wie ein gutes von Menschen gemachtes: einen Moment, eine Frage oder eine Geschichte. Ein Detektiv, der die falsche Leiche findet. Eine Katze, die das neue Bett verweigert. Zwei Fremde, die im Aufzug feststecken. Schreib das in einem Satz, bevor du eine einzige Einstellung schreibst. Ist der Satz nicht interessant, kann keine Render-Stufe das reparieren. Teste ihn an einem Freund: Fragt er, was als Nächstes passiert, hast du ein Video; nickt er höflich, such weiter nach dem Moment.
Schreib Sätze, keine Schlagwörter
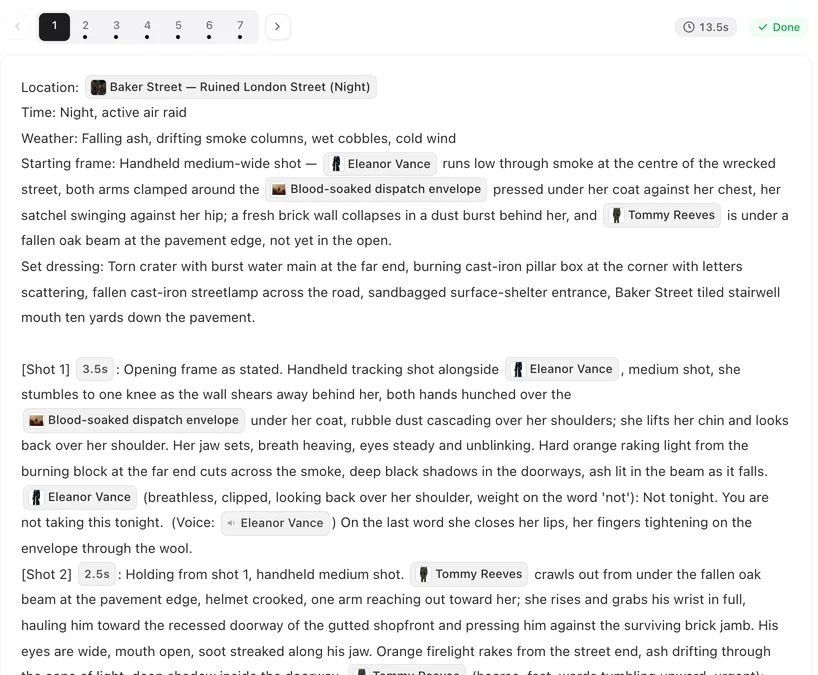
Modelle lesen eine Beschreibung als Satz. Reihen wie „masterpiece, best quality, 8K, cinematic, volumetric“ fügen nichts hinzu, das das Modell im Bild platzieren kann, schieben die wichtigen Wörter weiter nach hinten und werden manchmal wörtlich umgesetzt: Bittest du um volumetrischen Nebel, erscheint Nebel. Sag, was ein Kameramann sagen würde: wo die Kamera steht, was sie sieht, woher das Licht kommt. Den Gesamtlook wählst du mit der Vorgabe für den visuellen Stil statt mit Adjektiven.
Eine Handlung pro Einstellung und eine Besetzung, die hält
Gib jeder Einstellung eine Sache zu tun: Sie öffnet die Schublade; er dreht sich um; die Lampe flackert. Drei Handlungen in einer Einstellung kommen als Brei aller drei zurück. Halte zwei oder drei Personen pro Bild, und sorg dafür, dass jede wiederkehrende Figur aus einem Referenzblatt stammt, denn ein Gesicht, das sich zwischen Schnitten ändert, ist der schnellste Weg, einen Zuschauer zu verlieren. Auf SceneMixer wird das Blatt jedem Segment angehängt, in dem die Figur vorkommt.
Vorher und nachher
Hier ist dieselbe Einstellung zweimal geschrieben. Vorher: cineastisches Meisterwerk, 8K, dramatisches Licht, eine geheimnisvolle Frau in einem dunklen Raum, emotional, ultradetailliert. Nachher: Halbnahe. Eine Frau Ende vierzig sitzt nachts an einem Küchentisch, nur beleuchtet vom offenen Kühlschrank hinter ihr; sie dreht einen Ehering auf dem Tisch und blickt nicht auf, als sich die Tür öffnet. Die erste Fassung gibt dem Modell Adjektive und nichts zu zeigen. Die zweite gibt ihm einen Ort, eine Lichtquelle, eine Person, eine Handlung und einen Moment der Spannung, und mehr braucht ein Bild nicht. Schreib jede Einstellung wie die zweite Fassung, und die Qualität des ganzen Videos steigt, bevor du eine einzige Einstellung änderst. Auf SceneMixer lebt dieser Text im Storyboard, wo das Umschreiben kostenlos ist.
Ton, Tempo und der letzte Durchgang
Halte gesprochene Zeilen so kurz, wie es ihre Einstellung erlaubt, etwa drei Wörter pro Sekunde auf Englisch, und lass dort, wo eine Reaktion landen soll, eine stille Pause. Beginne mit etwas, das schon passiert, und ende mit etwas Offenem, wenn ein nächster Teil folgt. Entwirf jedes Segment auf einem günstigen Tarif, korrigiere die Wörter und rendere die brauchbaren Teile einmal auf dem Tarif, den du veröffentlichen willst. Beurteile das Ergebnis an der heruntergeladenen Datei und auf dem Bildschirm, den das Publikum nutzt. Schau einmal ohne Ton und einmal mit geschlossenen Augen; ein gutes Video funktioniert in beide Richtungen.
Grenzen: was auch gute KI-Videos nicht können
- Lesbarer Text im Bild bleibt unzuverlässig; füg ihn danach hinzu.
- Eine durchgehende Einstellung dauert höchstens ein Segment; längere Szenen werden zusammengeschnitten.
- Volle Bilder und Hände brauchen mehr Versuche, selbst wenn das Geschriebene gut ist.
- Ein starker Look kann eine schwache Prämisse nicht retten.
- Die Zählung zum Prompt-Lernen ist ein regelbasierter Abgleich über ein festes Fenster öffentlicher Threads.
FAQ
Verbessern Qualitätswörter wie 8K KI-Videos?
Nein. Die Modelle von SceneMixer lesen Sätze, keine Schlagwörter; beschreibe stattdessen Ort, Licht und Handlung.
Was lässt ein KI-Video nach Schrott aussehen?
Kein Grund zum Zuschauen, ein Haufen Adjektive statt einer Szene und Gesichter, die sich zwischen Einstellungen verändern.
Wie viele Personen sollten in einer KI-Einstellung sein?
Zwei oder drei. Volle Bilder sind die Stelle, an der Gesichter, Hände und Anschluss zuerst brechen.
Wie werden meine KI-Videos besser, ohne mehr auszugeben?
Korrigiere zuerst Geschichte und Shot-Text, denn Bearbeiten ist auf SceneMixer kostenlos. Dann günstig entwerfen und nur die brauchbaren Teile auf einem besseren Tarif rendern.
Verwandt: wie man KI-Video realistisch macht, warum Zauberwörter nichts bewirken und die Sammelmethode hinter der Zahl.
Schreib eine gute Szene
Ein Grund zum Zuschauen, schlichte Sätze, eine Handlung pro Einstellung. Lies sie, bevor sie gerendert wird.
Kostenlos registrierenDie Preise pro Videosekunde stehen auf der Preisseite mit denselben Zahlen.