Antwoorden · Kwaliteit
Hoe maak je goede AI-video's?
Bijgewerkt 17 november 2026

Het verschil tussen goed en slop
De meeste mensen die om betere tools vragen, willen eigenlijk ontsnappen aan de look van massaal gemaakte AI-clips. Eén maker verwoordde het verzoek in één regel:
ik zoek iets realistisch en goed, en niet AI-slop.
De regel komt uit een draad in r/generativeAI waarin werd gevraagd welke tools je kunt proberen. Slop is zelden een toolprobleem. Het is een clip zonder reden om te bestaan, beschreven met een stapel bijvoeglijke naamwoorden, met een gezicht dat tussen de shots verandert. Ongeveer 58 berichten in het communitycorpus vragen hoe je leert prompts te schrijven die goede resultaten geven; het meeste van het antwoord staat hieronder, en heel weinig gaat over slimme woorden.
Begin met een reden om te kijken
Een goede AI-video heeft hetzelfde wat een goede door mensen gemaakte video heeft: een moment, een vraag of een verhaal. Een rechercheur die het verkeerde lichaam vindt. Een kat die het nieuwe bed weigert. Twee vreemden vast in een lift. Schrijf dat in één zin voordat je een shot schrijft. Is de zin niet interessant, dan lost geen enkel renderniveau het op. Test het op een vriend: vraagt die wat er daarna gebeurt, dan heb je een video; knikt die beleefd, zoek dan verder naar het moment.
Schrijf zinnen, geen tags
Modellen lezen een beschrijving als een zin. Reeksen als "masterpiece, best quality, 8K, cinematic, volumetric" voegen niets toe dat het model in het beeld kan plaatsen, duwen de woorden die ertoe doen verder naar achteren en worden soms letterlijk genomen: vraag om volumetrische mist en er verschijnt mist. Zeg wat een cameraman zou zeggen: waar de camera staat, wat hij ziet, waar het licht vandaan komt. Kies de algehele look met de voorinstelling voor visuele stijl in plaats van bijvoeglijke naamwoorden.
Eén actie per shot, en een cast die standhoudt
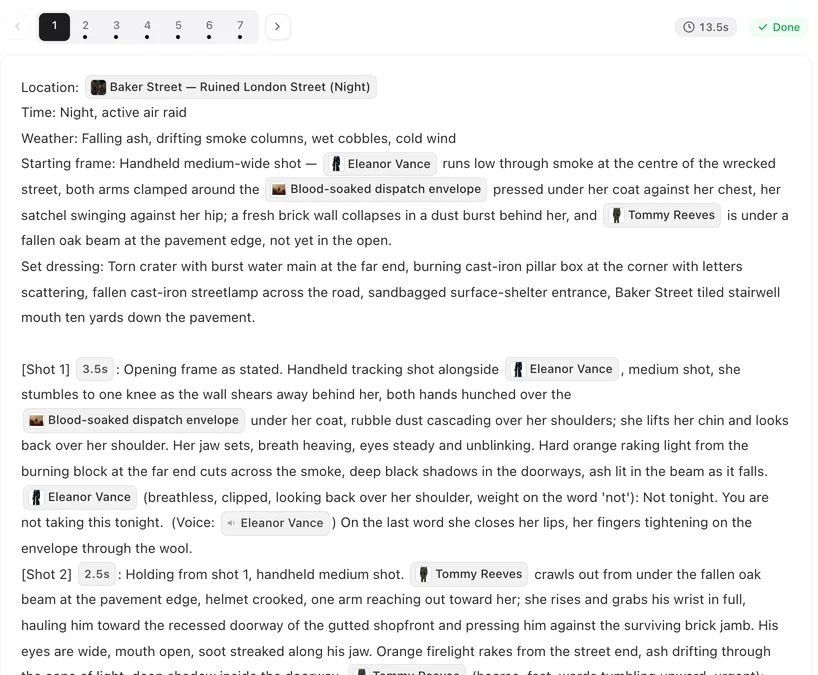
Geef elke shot één ding om te doen: zij opent de la; hij draait zich om; de lamp flikkert. Drie acties in één shot komen terug als een waas van alle drie. Houd twee of drie personen per beeld, en zorg dat elk terugkerend personage uit één referentiekaart komt, want een gezicht dat tussen de shots verandert, is de snelste manier om een kijker kwijt te raken. Op SceneMixer wordt de kaart gekoppeld aan elk segment waarin het personage voorkomt.
Een voor en na
Hier is hetzelfde shot op twee manieren geschreven. Voor: cinematic masterpiece, 8K, dramatic lighting, a mysterious woman in a dark room, emotional, ultra detailed. Na: Medium close-up. Een vrouw van in de veertig zit 's nachts aan een keukentafel, alleen verlicht door de open koelkast achter haar; ze draait een trouwring op de tafel rond en kijkt niet op als de deur opengaat. De eerste geeft het model bijvoeglijke naamwoorden en niets om te tonen. De tweede geeft een plek, een lichtbron, één persoon, één actie en een moment van spanning, en dat is alles wat een beeld nodig heeft. Schrijf elk shot zoals de tweede versie en de kwaliteit van de hele video stijgt, nog voordat je ook maar één instelling verandert. Op SceneMixer staat deze tekst in het storyboard, waar herschrijven gratis is.
Geluid, tempo en de laatste ronde
Houd gesproken regels kort genoeg voor hun shot, ongeveer drie woorden per seconde in het Engels, en laat een stille pauze waar een reactie moet landen. Begin met iets dat al gebeurt en eindig op iets onopgelosts als er een volgend deel is. Concipieer elk segment op een goedkoop niveau, los de woorden op, en render de bewaarde exemplaren één keer op het niveau waarop je wilt publiceren. Beoordeel het resultaat aan het gedownloade bestand en op het scherm dat het publiek gebruikt. Kijk één keer zonder geluid en één keer met je ogen dicht; een goede video werkt in beide gevallen.
Beperkingen: wat goed nog niet kan
- Leesbare tekst in het beeld blijft onbetrouwbaar; voeg die achteraf toe.
- Eén doorlopende take duurt hooguit één segment; langere scènes worden aan elkaar gemonteerd.
- Drukke actie en handen vragen meer pogingen, ook als de tekst goed is.
- Een sterke look kan een zwakke premisse niet redden.
- Het cijfer voor leren van prompts is een regelgebaseerde match over een vast venster van openbare draadjes.
Veelgestelde vragen
Maken kwaliteitswoorden zoals 8K AI-video's beter?
Nee. De modellen van SceneMixer lezen zinnen, geen tags; beschrijf in plaats daarvan de plek, het licht en de actie.
Wat maakt dat een AI-video op slop lijkt?
Geen reden om te kijken, een stapel bijvoeglijke naamwoorden in plaats van een scène, en gezichten die tussen shots veranderen.
Hoeveel mensen horen in één AI-shot?
Twee of drie. Drukke beelden zijn waar gezichten, handen en continuïteit het eerst breken.
Hoe maak ik AI-video's beter zonder meer uit te geven?
Los eerst het verhaal en de shottekst op, want bewerken is gratis op SceneMixer; concipieer daarna goedkoop en render alleen de bewaarde exemplaren op een beter niveau.
Verwant: AI-video realistisch maken, waarom toverwoorden niets doen, en de verzamelmethode achter de telling.
Schrijf één goede scène
Een reden om te kijken, gewone zinnen, één actie per shot. Lees het voordat het wordt gerenderd.
Gratis aanmeldenDe prijzen per seconde video staan op de prijspagina, met dezelfde cijfers.