Antworten · Action
Wie plane ich eine One-Take-Action-Aufnahme mit KI-Video?
Aktualisiert 14. Oktober 2026

Was eine One-Take-Aufnahme von der Pipeline verlangt
Schnitte sind Verstecke. Wenn ein Kampf, eine Verfolgung oder ein Rundgang zusammengeschnitten wird, setzt jeder Schnitt die Geografie zurück, verzeiht ein verändertes Kostüm und lässt die nächste Einstellung einen neuen Raum erfinden. Eine One-Take-Aufnahme verbietet all das: Die Kamera bewegt sich ohne Unterbrechung durch den Raum, also müssen Positionen, Bewegungsrichtung, Requisiten in der Hand und das Licht im Gesicht über den gesamten Verlauf übereinstimmen.
Das ist auch der Grund, warum One-Take-Aufnahmen diejenigen sind, an die sich Zuschauer erinnern – und für die Macher Budgets verbrennen: Mit einem echten Team braucht es Proben, mit generiertem Video braucht es Planung. Denn das Modell erstellt gerne eine wunderschöne durchgehende Aufnahme eines Raums, der sich mitten in der Bewegung neu anordnet. Die Bewegungsfragen im Corpus sind zahlreich: 520 Beiträge fragen danach, Bewegung 1:1 zu kopieren. Die Antwort ist keine Einstellung – es geht darum, die Aufnahme so zu schreiben, dass die Teile nicht widersprechen können.
Schreibe den Weg vor den Shots
Plane die Aufnahme als eine einzige Reise, in einem Satz: Die Kamera fährt hinter dem Kurier ein, folgt ihr durch die Gasse, duckt sich mit ihr unter das Rollladen und endet bei dem fallengelassenen Paket. Dieser Satz ist das Rückgrat der Aufnahme. Dann teile die Reise in Beats auf – ein Beat endet dort, wo sich die Handlung bedeutsam ändert – und schreibe jeden Beat als Shot mit eigener Zeitangabe im Storyboard. Die Shots sind keine Schnitte; sie sind der Zeitmaßstab für eine durchgehende Bewegung, und ihre Zeitangaben lassen sich vor der Generierung kostenlos anpassen – so stimmst du das Tempo der Aufnahme ab.
Beschreibe den Raum so, wie du einen echten Raum beschreiben würdest: Wo die Möbel stehen, auf welcher Seite die Tür ist, wo das Licht herkommt. Vage Räume werden genau von einer durchgehenden Kamera aufgedeckt – es gibt keinen Schnitt weg von einer Wand, die sich verschoben hat. Jede Angabe im Storyboard zu Position und Richtung muss über die gesamte Aufnahme hinweg stimmen. Deshalb ist das einfachste Planungswerkzeug ein unspektakuläres: Weniger Beats, jeder klar positioniert.
Ein Segment oder mehrere?
Ein Take, der innerhalb der Generationsgrenze liegt, ist der einfache Fall: ein Segment, eine Anfrage, bis zu 15 Sekunden auf Seedance 2.0, mit einer Segmentlänge von dreißig Sekunden auf den dafür ausgelegten Tarifen. Innerhalb eines Segments gibt es überhaupt keine Übergänge, und für eine einzelne Handlungseinheit reichen fünfzehn Sekunden Bildzeitung meist mehr als aus.
Längere Aufnahmen verketten Segmente, und die Kette folgt einer Regel: Das nächste Segment beginnt dort, wo das letzte geendet hat. Was die Illusion an der Naht schützt, ist die Richtung – behalte die Kamerarichtung und die Bewegungsrichtung des Subjekts über den Übergang hinweg bei, und vermeide eine Gegen Einstellung oder einen harten Themenwechsel an der Naht. Das wirkt wie der Schnitt, den die Aufnahme versprochen hat, nicht zu machen. Die Naht ist auch der Ort, an dem sich ein neu generiertes Segment lohnt: Repariere das eine Segment, das falsch zurückkam, statt die gesamte Aufnahme neu zu bauen.
Halte den Raum fest
Die maschinenseitige Antwort auf driftende Geografie ist ein Plan in drei Dimensionen. Bevor die Shots einer Szene generiert werden, legt die Seite die Szene als einfachen 3D-Durchgang an – Räume als Kästen, die wichtigen Möbel, jede Person als einfache Figur – und ermittelt eine Platzierung pro Shot: Wo alle stehen und wo eine Kamera stehen kann, um sie zu sehen. Der Durchgang legt genau vier Dinge fest und nichts sonst: Wo die Kamera steht, wie breit der Bildausschnitt ist, wo jede Person im Raum steht und wo sich die Shot-Änderung befindet. Dieser Plan sorgt dafür, dass Sitze, Türen, Wände und wer neben wem steht, über die gesamte Aufnahme hinweg halten. Deshalb schneidet die Kamera nur zu Einstellungen, die im Raum existieren – und der Plan baut auf deinem Storyboard und dem Szenenbild auf. Das ist ein weiterer Grund, warum der vorherige Abschnitt wichtig ist: Du kämpfst nicht gegen den Plan, wenn du schreibst – du fütterst ihn.
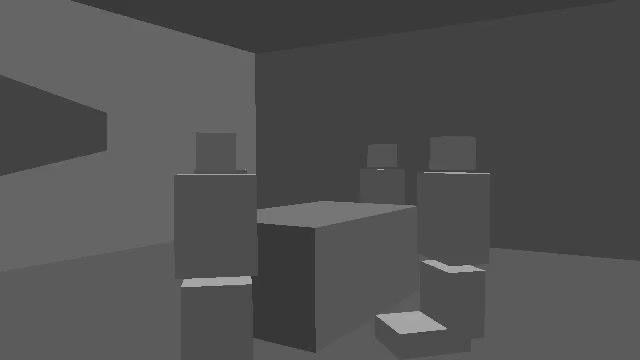
Zwei Gewohnheiten machen den Plan nutzbar. Nenne Positionen, anstatt sie vorauszusetzen – wer am Kopf des Tisches sitzt, wer neben der Tür steht – und halte die Besetzung einer Aufnahme klein: Jedes zusätzliche Gesicht in einem durchgehenden Bild ist eine weitere Person, die die Kamera im Blick behalten muss. Eine Aufnahme funktioniert am besten mit einem Subjekt, einem Verfolger und einem Raum.
Was eine durchgehende Aufnahme meist zerstört
- Eine Änderung, die die Aufnahme nicht machen kann. Ein Kostümwechsel, eine neue Verletzung oder eine gezogene Waffe ändern, was das Objekt ist – nicht wo es ist. Jede davon braucht ein eigenes Referenzbild, das für die relevanten Segmente ausgewählt wird. Verwandlungen mitten in der Aufnahme sind ein Zustandsproblem, kein Kameraproblem.
- Beats, die eine eigene Einstellung brauchen. Wenn der Plan insgeheim eine Nahaufnahme, eine Reaktion und eine Totale in einer ununterbrochenen Bewegung will, wird die Aufnahme keine davon richtig umsetzen. Entscheide, wofür die Aufnahme da ist: Für die Geografie, die Dynamik oder die Enthüllung.
- Menge und Verkehr. Hintergrundpersonen sind eine Aussage auf Szenenebene, keine Improvisation pro Beat; eine Aufnahme mit unkontrollierter Menge hat in jeder Sekunde eine andere Menge.
- Dialog im Vorbeigehen. Zeilen, die während der Bewegung gesprochen werden, brauchen ihre Zeitangaben im Shot-Text, genau wie in jedem anderen Shot; eine Aufnahme lockert die Zeitregeln nicht – sie vervielfacht sie.
Wie sich die Bewegungsfragen aufteilen
Die zwei großen Bewegungsfragen teilen sich sauber auf: Die eine fragt, wie man Bewegung kopiert, die andere, wie man eine Aufnahme baut. Beide sind Mengensymptome desselben fehlenden Teils – eines Plans dafür, wo sich Dinge befinden:
| Frage (nahezu identische Beiträge) | Beiträge |
|---|---|
| Die Frage nach der Bewegungsübernahme | 520 |
| Die Frage nach dem One-Take | 150 |
Und wenn ein Plan funktioniert, sagt dir das Publikum in einer Zeile – dieser Kommentar ist der Maßstab, an dem jeder durchgehende Action-Beat gemessen wird:
Das war großartig. Eine der kohärentesten AI-Action-Sequenzen, die ich je gesehen habe.
Kohärent ist das Schlüsselwort: was auch immer die Sequenz tat, sie verlor den Raum nicht. Das Zitat stammt aus einer Diskussion in r/aivideo.
Einschränkungen: was diese Seite nicht behandelt
- Ein One-Take ist eine Wahl, keine Tugend. Coverage – eine Weitwinkel-, eine Nahaufnahme, eine Reaktion – so wird die meiste Action tatsächlich aufgebaut, und eine Szene mit schnellen, kleinen Beats wirkt meist geschnitten besser als in einer Einstellung.
- Generierte Takes brauchen immer noch eine Prüfung: das Modell bestimmt, wie sich die Pixel bewegen, also plane Zeit für die Neugenerierung des Segments ein, das falsch zurückkam, und korrigiere zuerst den Storyboard-Text, bevor du neu würfelst.
- Ein Take, der mitten im Ort wechseln muss, sind zwei Takes, die über eine Naht verbunden sind – egal wie der Text geschrieben ist; plane diese Naht bewusst, anstatt sie zu entdecken.
- Die Zahlen hier sind regelbasierte Näherungswerte aus einem festen Fenster, und das zitierte Lob ist die Erfahrung eines einzelnen Betrachters, kein Benchmark.
FAQ
Wie lang kann ein einzelner Take sein?
Ein Segment dauert bis zu 15 Sekunden auf Seedance 2.0, bzw. dreißig auf den Langtake-Tarifen. Längere durchgehende Handlung besteht aus aneinandergereihten Segmenten, die jeweils dort anfangen, wo das vorherige aufgehört hat – der Übergang ist eine Nahtstelle, kein Schnitt, wenn die Überschrift darüber hinwegläuft.
Muss ich jeden Schritt der Kamerabewegung beschreiben?
Beschreibe den Weg, nicht die Choreografie: Eintritt, was die Kamera verfolgt, wo sie stoppt, und die Beats dazwischen mit ihren Sekunden. Die Shots geben dem Take sein Timing; die Positionszeilen geben ihm einen Raum, durch den er sich bewegen kann.
Was, wenn das Modell trotzdem einen Schnitt einfügt?
Behandle es zuerst als Problem des Shot-Textes: generiere das Segment neu, nachdem du die Kontinuität explizit gemacht hast – Überschrift, Subjekt, Position am Ende. Wenn zwei Versuche auf die gleiche Weise fehlschlagen, teile den Take an dem Beat, an dem er immer bricht; eine geplante Naht ist besser als ein ungeplanter Schnitt.
Kann der Take eine Menschenmenge oder Straßenverkehr enthalten?
Ja, wenn die Menge auf Szenenebene deklariert und dort beibehalten wird – Hintergrundpersonen als dauerhafter Zustand des Ortes, nicht als neue Erfindung pro Beat. Eine nicht deklarierte Menge wirkt in jeder Sekunde des Takes wie eine andere Menge.
Zwei Guides gehen tiefer: wie räumliche Konsistenz funktioniert und wie man ein echtes Dreh mit generierten Clips probt behandeln die Mechanik, und die verwandte Antwort zum Aufbau über eine Minute hinaus deckt die Segmentarithmetik ab, die diese Seite voraussetzt. Die Methodennotiz beschreibt, wie solche Zahlen erhoben werden.
Plane den Take dort, wo er planbar ist
Lade ein Skript hoch; SceneMixer schreibt das Storyboard, fixiert den Raum in einem räumlichen Modell und rendert den Take Segment für Segment.
Kostenlos anmeldenDie Videopreise pro Sekunde findest du auf der Preisseite mit den gleichen Zahlen.
Preise·Anleitungen·Beispiele·Alternativen·Antworten·Support·Datenschutz·AGB·Rechtliches·Kontakt·Partnerprogramm·© 2026 SceneMixer