Antwoorden · Actie
Hoe plan ik een one-take actieshot met AI-video?
Bijgewerkt 14 oktober 2026

Wat een one-take van de pipeline vergt
Cuts zijn plekken om je achter te verschuilen. Wanneer een gevecht, achtervolging of rondleiding aan elkaar wordt geknipt, reset elke cut de geografie, vergeeft een kostuum dat veranderd is, en laat de volgende hoek een nieuwe ruimte verzinnen. Een one-take verbiedt dat allemaal: de camera reist zonder stoppen door de ruimte, dus posities, rijrichting, rekwisieten in de hand en het licht op een gezicht moeten de hele run overeenkomen.
Dat is ook waarom one-takes de shots zijn die kijkers onthouden en waar makers budgetten op verbranden — met een fysieke crew vergt het repetitie, en met gegenereerde video vergt het planning, omdat het model graag een prachtige continue shot produceert van een ruimte die zich halverwege de beweging herschikt. De bewegingsvragen in de corpus zijn groot: 520 berichten vragen over het één-op-één kopiëren van beweging. Het antwoord is geen instelling; het is het schrijven van de take zodat de onderdelen niet kunnen verschillen.
Schrijf het pad voor de shots
Plan de take als een enkele reis, in één zin: de camera komt binnen achter de koerier, volgt haar door de steeg, duikt met haar onder de rolluik door, en eindigt op het gevallen pakket. Die zin is de ruggengraat van de shot. Breek de reis vervolgens op in momenten — een moment eindigt waar de actie betekenisvol verandert — en schrijf elk moment als een shot met zijn eigen secondes in de storyboard. De shots zijn geen cuts; het zijn de tijdliniaal voor één doorlopende beweging, en hun secondes zijn gratis aan te passen voordat er iets wordt gegenereerd, en zo stem je het tempo van de take af.
Beschrijf de ruimte op dezelfde manier als je een echte kamer zou beschrijven: waar het meubilair staat, aan welke kant de deur is, waar het licht vandaan komt. Vage ruimtes zijn precies wat een continue camera blootlegt — je kunt niet wegsnijden van een muur die is verplaatst. Elke claim die de storyboard doet over positie en richting is een claim die de take de hele run waar moet houden, dus het goedkoopste planningsmiddel is een onopvallende: minder momenten, elk duidelijk gelokaliseerd.
Eén segment, of meerdere?
Een take die binnen de generatielimiet past is het eenvoudige geval: één segment, één verzoek, maximaal 15 seconden op Seedance 2.0, met een segmentlengte van dertig seconden beschikbaar op de tiers die daarvoor zijn gemaakt. Binnen één segment zitten helemaal geen naden, en voor een enkel actiemoment is vijftien seconden meestal meer dan genoeg schermtijd.
Langere runs ketenen segmenten aan elkaar, en de ketting volgt één regel: het volgende segment opent waar het laatste eindigde. Wat de illusie bij de naad beschermt is richting — houd de koers van de camera en de reis van het onderwerp doorlopend over de verbinding heen, en vermijd om de naad te ontmoeten met een omkering of een harde onderwerpverandering, wat overkomt als de cut die de take beloofde niet te maken. De naad is ook de plek waar een opnieuw gegenereerd segment zijn waarde bewijst: repareer het ene segment dat verkeerd terugkwam in plaats van de hele take opnieuw op te bouwen.
Houd de ruimte vast
Het machine-side antwoord op dwalende geografie is een plan in drie dimensies. Voordat de shots van een scène worden gegenereerd, legt de site de scène uit als een eenvoudige driedimensionale opzet — kamers als dozen, het meubilair dat ertoe doet, elke persoon als een eenvoudig figuur — en bepaalt één plaatsing per shot: waar iedereen is, en waar een camera kan staan om ze te zien. De opzet legt vier dingen vast en niets meer — waar de camera is, hoe wijd het frame is, waar elke persoon in de ruimte is, en waar de shot verandert — en dat plan is ervoor dat stoelen, deuren, muren en wie naast wie staat over de hele take behouden blijven. Het is waarom de camera alleen snijdt naar hoeken die in de ruimte bestaan, en het is opgebouwd uit jouw storyboard en de afbeelding van de scène, wat nog een reden is waarom het vorige gedeelte ertoe doet: je vecht niet tegen het plan als je schrijft, je voedt het.
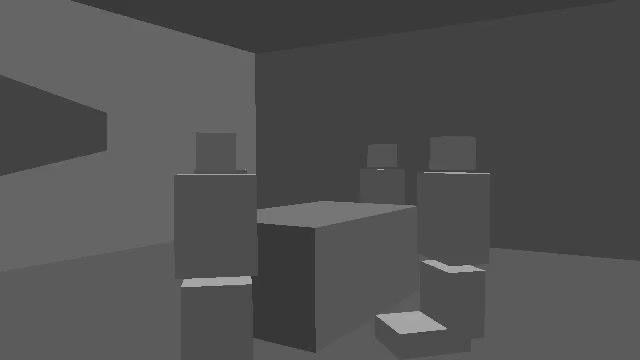
Twee gewoonten brengen het plan tot werken. Noem posities in plaats van ze aan te nemen — wie aan het hoofd van de tafel zit, wie naast de deur staat — en houd de cast van een take klein: elk extra gezicht in een continu frame is nog een persoon die de camera moet bijhouden. Een take werkt het beste met een onderwerp, een achtervolger en een ruimte.
Wat een continue take meestal breekt
- Een verandering die de take niet kan maken. Een kostuumwissel, een nieuwe verwonding of een getrokken wapen verandert wat het object is, niet waar het is — elk heeft zijn eigen referentieafbeelding nodig die is geselecteerd voor de relevante segmenten. Transformaties halverwege de take zijn een staatsprobleem, geen cameraprobleem.
- Momenten die hun eigen beeldvoering nodig hebben. Als het plan stiekem een close-up, een reactie en een wijd shot wil in één ononderbroken beweging, zal de take geen van alle waarmaken. Bedenk waar de take voor is: de geografie, het momentum, of de onthulling.
- Menigte en verkeer. Achtergrondpersonen zijn een uitspraak op scèneniveau, geen improvisatie per moment; een take met een onbeheerde menigte is een take met elke seconde een andere menigte.
- Dialoog tijdens de beweging. Regels die halverwege de beweging worden gezegd, hebben hun secondes nodig in de shottekst, precies zoals in elke andere shot; een take versoepelt de timingregels niet, hij vermenigvuldigt ze.
Hoe de bewegingsvragen zich splitsen
De twee grote bewegingsvragen splitsen zich netjes op: de ene vraagt hoe je beweging kopieert, de andere hoe je een take opbouwt. Beiden zijn volume-symptomen van hetzelfde ontbrekende stuk — een plan voor waar dingen zijn:
| Vraag (bijna identieke berichten) | Berichten |
|---|---|
| De vraag over het kopiëren van beweging | 520 |
| De vraag over de one-take | 150 |
En als een plan werkt, vertelt het publiek je dat in één zin — deze reactie is de maatstaf waar elke doorlopende actiebeat aan wordt afgemeten:
Dat was geweldig. Een van de meest samenhangende AI-actiesequenties die ik ooit heb gezien.
Samenhangend is het sleutelwoord: wat de sequentie ook deed, hij verloor de ruimte niet uit het oog. De quote komt uit een discussie op r/aivideo.
Beperkingen: wat deze pagina niet behandelt
- Een one-take is een keuze, geen deugd. Coverage — een breedbeeld, een close-up, een reactie — is hoe de meeste actie daadwerkelijk wordt opgebouwd, en een scène met snelle, kleine beats komt meestal beter over als hij geknipt is dan als hij doorloopt.
- Gegenereerde opnames moeten nog steeds worden nagekeken: het model bepaalt hoe de pixels bewegen, dus houd rekening met het opnieuw genereren van het segment dat verkeerd terugkwam, en pas de storyboardtekst opnieuw aan voordat je opnieuw genereert.
- Een opname die halverwege van locatie moet veranderen, zijn twee opnames die aan elkaar worden gekoppeld via een naad, hoe de tekst ook is geschreven; plan die naad bewust in plaats van hem te ontdekken.
- De aantallen hier zijn op regels gebaseerde benaderingen uit een vast venster, en de geciteerde lof is de ervaring van één kijker, geen benchmark.
Veelgestelde vragen
Hoe lang kan een enkele opname duren?
Eén segment duurt maximaal 15 seconden op Seedance 2.0, of dertig op de long-take tiers. Langere doorlopende actie bestaat uit aaneengeschakelde segmenten, die elk beginnen waar de vorige eindigde — de naad is een verbinding, geen snede, als de kop erdoorheen loopt.
Moet ik elke stap van de camerabeweging beschrijven?
Beschrijf de reis, niet de choreografie: de entree, wat de camera volgt, waar hij stopt, en de beats daartussen met hun seconden. De shots geven de opname zijn timing; de positielijnen geven hem een ruimte om doorheen te bewegen.
Wat als het model toch een knip toevoegt?
Behandel het eerst als een shottekstprobleem: genereer het segment opnieuw nadat je de continuïteit expliciet hebt gemaakt — kop, onderwerp, positie aan het eind. Als twee pogingen op dezelfde manier falen, splits de opname dan op de beat waar hij steeds breekt; een geplande naad is beter dan een ongeplande knip.
Kan de opname een menigte of straatverkeer bevatten?
Ja, als de menigte op scheniveau wordt gedeclareerd en zo wordt gehouden — achtergrondpersonen als een vaste staat van de locatie, niet als een nieuwe uitvinding per beat. Een menigte die niet wordt gedeclareerd, lijkt elke seconde van de opname een andere menigte.
Twee handleidingen gaan dieper in: hoe ruimtelijke consistentie werkt en hoe je een echte shoot repeteert met gegenereerde clips zijn de mechanismen, en het zusterantwoord over opbouwen voorbij één minuut behandelt de segmentrekenkunde die deze pagina aanneemt. De methodenotitie beschrijft hoe tellingen zoals deze worden verzameld.
Plan de opname waar het gepland kan worden
Upload een script; SceneMixer schrijft de storyboard, zet de ruimte vast in een ruimtelijk model en rendert de opname segment voor segment.
Gratis aanmeldenDe videotarieven per seconde staan op de prijzenpagina met dezelfde getallen.
Prijzen·Gidsen·Voorbeelden·Alternatieven·Antwoorden·Ondersteuning·Privacy·Voorwaarden·Juridisch·Contact·Partnerprogramma·© 2026 SceneMixer