Jawaban · Aksi
Bagaimana Cara Merencanakan Bidikan Aksi Sekali Ambil dengan Video AI?
Diperbarui 14 Oktober 2026

Apa yang diminta sekali ambil dari alur kerja
Potongan adalah tempat untuk bersembunyi. Ketika pertarungan, pengejaran, atau penelusuran disusun dengan potongan, setiap potongan mengatur ulang geografi, memaafkan kostum yang berubah, dan membiarkan sudut berikutnya menciptakan ruangan baru. Sekali ambil melarang semua itu: kamera bergerak melalui ruang tanpa berhenti, sehingga posisi, arah gerak, properti di tangan, dan cahaya di wajah harus konsisten selama seluruh durasi.
Itulah sebabnya sekali ambil adalah bidikan yang diingat penonton dan bidikan yang menghabiskan anggaran pembuat — dengan kru fisik dibutuhkan latihan, dan dengan video yang dihasilkan dibutuhkan perencanaan, karena model akan dengan senang hati menghasilkan bidikan berkelanjutan yang indah dari ruangan yang menata ulang dirinya di tengah gerakan. Pertanyaan gerakan di korpus sangat banyak: 520 postingan bertanya tentang menyalin gerakan satu lawan satu. Jawabannya bukan pengaturan; melainkan menulis pengambilan sehingga semua bagian tidak bisa tidak konsisten.
Tulis jalurnya sebelum bidikan
Rencanakan pengambilan sebagai satu perjalanan tunggal, dalam satu kalimat: kamera masuk dari belakang kurir, mengikutinya menyusuri gang, menunduk bersamanya di bawah rana, dan berakhir pada paket yang jatuh. Kalimat itu adalah tulang punggung bidikan. Kemudian pecah perjalanan menjadi ketukan — ketukan berakhir di mana aksi berubah secara bermakna — dan tulis setiap ketukan sebagai bidikan dengan durasi detiknya sendiri di storyboard. Bidikan-bidikan itu bukan potongan; mereka adalah penggaris waktu untuk satu gerakan berkelanjutan, dan durasi detiknya dapat diedit secara bebas sebelum apa pun dihasilkan, itulah cara Anda menyesuaikan tempo pengambilan.
Tulis ruangnya dengan cara yang sama seperti Anda mendeskripsikan ruangan nyata: di mana letak perabotan, sisi mana pintunya berada, dari mana cahaya berasal. Ruangan yang samar persis seperti yang diekspos oleh kamera berkelanjutan — tidak ada potongan untuk berpaling dari dinding yang bergeser. Setiap klaim yang dibuat storyboard tentang posisi dan arah adalah klaim yang harus dipertahankan pengambilan selama seluruh durasinya, jadi alat perencanaan termurah adalah yang tidak mewah: lebih sedikit ketukan, masing-masing dengan lokasi yang jelas.
Satu segmen, atau beberapa?
Take yang sesuai dengan batas generasi adalah kasus yang mudah: satu segmen, satu permintaan, hingga 15 detik di Seedance 2.0, dengan panjang segmen tiga puluh detik yang tersedia pada tingkatan yang dirancang untuknya. Di dalam satu segmen tidak ada sambungan sama sekali, dan untuk satu aksi singkat, lima belas detik biasanya lebih dari cukup waktu tayang.
Durasi yang lebih panjang merantai segmen, dan rantai tersebut mengikuti satu aturan: segmen berikutnya dimulai di mana segmen terakhir berakhir. Yang melindungi ilusi di sambungan adalah arah — jaga arah kamera dan pergerakan subjek tetap berkelanjutan di seluruh sambungan, dan hindari bertemu sambungan dengan pembalikan arah atau perubahan topik yang tajam, yang akan terbaca sebagai potongan yang dijanjikan tidak akan dibuat oleh pengambilan. Sambungan juga merupakan tempat segmen yang diregenerasi menunjukkan nilainya: perbaiki satu segmen yang kembali salah alih-alih membangun kembali seluruh pengambilan.
Jaga ruangan tetap tetap
Jawaban dari sisi mesin untuk geografi yang melayang adalah rencana dalam tiga dimensi. Sebelum bidikan adegan dihasilkan, situs menata adegan sebagai lintasan tiga dimensi sederhana — ruangan sebagai kotak, perabotan yang penting, setiap orang sebagai figur polos — dan menentukan satu penempatan per bidikan: di mana semua orang berada, dan di mana kamera bisa berdiri untuk melihat mereka. Lintasan itu memperbaiki empat hal dan tidak lebih — di mana kamera berada, seberapa lebar bingkainya, di mana setiap orang berada di ruang, dan di mana bidikan berubah — dan rencana itulah yang membuat kursi, pintu, dinding, dan siapa yang berdiri di samping siapa tetap konsisten di seluruh pengambilan. Itulah sebabnya kamera hanya berpindah ke sudut yang ada di ruangan, dan itu dibangun dari storyboard Anda dan gambar adegan, yang merupakan alasan lain mengapa bagian sebelumnya penting: Anda tidak melawan rencana saat menulis, Anda memberinya makan.
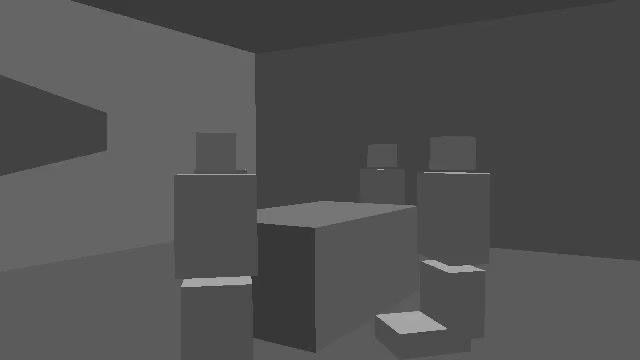
Dua kebiasaan membuat rencana itu bekerja. Sebutkan posisi alih-alih mengasumsikannya — siapa yang berada di kepala meja, siapa yang di samping pintu — dan jaga pemeran pengambilan tetap kecil: setiap wajah tambahan dalam bingkai berkelanjutan adalah orang lain yang harus dilacak oleh kamera. Pengambilan bekerja paling baik dengan subjek, pengejar, dan sebuah ruangan.
Apa yang biasanya merusak pengambilan berkelanjutan
- Perubahan yang tidak dapat dilakukan pengambilan. Pertukaran kostum, luka baru, atau senjata yang tergambar mengubah apa objek itu, bukan di mana letaknya — masing-masing membutuhkan gambar referensi sendiri yang dipilih untuk segmen yang relevan. Transformasi di tengah pengambilan adalah masalah status, bukan masalah kamera.
- Ketukan yang membutuhkan liputan sendiri. Jika rencana diam-diam menginginkan close-up, reaksi, dan wide di dalam satu gerakan yang tidak terputus, pengambilan tidak akan memenuhi salah satunya. Tentukan untuk apa pengambilan itu: geografi, momentum, atau pengungkapan.
- Kerumunan dan lalu lintas. Orang-orang latar belakang adalah pernyataan tingkat adegan, bukan improvisasi per ketukan; pengambilan dengan kerumunan yang tidak dikelola adalah pengambilan dengan kerumunan yang berbeda di setiap detik.
- Dialog singkat saat bergerak. Baris kalimat yang diucapkan di tengah gerakan membutuhkan durasi detiknya di teks bidikan, persis seperti di bidikan lainnya; pengambilan tidak melonggarkan aturan waktu, ia melipatgandakannya.
Bagaimana pertanyaan gerakan terbagi
Dua pertanyaan gerakan besar terbagi dengan rapi: satu bertanya bagaimana menyalin gerakan, satu bertanya bagaimana membangun pengambilan. Keduanya adalah gejala volume dari bagian yang sama yang hilang — rencana untuk di mana letak segala sesuatu:
| Pertanyaan (postingan yang hampir identik) | Postingan |
|---|---|
| Masalah penyalinan gerakan | 520 |
| Masalah pengambilan gambar satu take | 150 |
Dan ketika rencana berhasil, penonton memberi tahu Anda dalam satu baris — komentar ini adalah tolok ukur setiap aksi berkelanjutan dinilai:
Itu keren. Salah satu urutan aksi AI paling koheren yang pernah saya lihat.
Koheren adalah kata kuncinya: apa pun yang dilakukan urutan itu, ia tidak kehilangan ruangannya. Kutipan itu berasal dari diskusi di r/aivideo.
Keterbatasan: apa yang tidak dibahas halaman ini
- Satu take adalah pilihan, bukan kelebihan. Coverage — gambar lebar, gambar dekat, reaksi — adalah cara sebagian besar aksi dibangun, dan adegan dengan aksi cepat yang kecil biasanya lebih enak dipotong daripada dipertahankan.
- Take yang dihasilkan tetap perlu ditinjau: model memutuskan bagaimana piksel bergerak, jadi siapkan anggaran untuk regenerasi segmen yang hasilnya salah, dan perbaiki kembali teks storyboard sebelum mengulang.
- Sebuah take yang harus berpindah lokasi di tengah jalan adalah dua take yang dirangkai di sambungan, bagaimanapun teksnya ditulis; rencanakan sambungan itu dengan sengaja daripada menemukannya secara tidak sengaja.
- Jumlah di sini adalah perkiraan berbasis aturan dari jendela tetap, dan pujian yang dikutip adalah pengalaman satu penonton, bukan tolok ukur.
FAQ
Berapa lama durasi satu take?
Satu segmen berjalan hingga 15 detik di Seedance 2.0, atau tiga puluh detik pada tingkatan long-take. Aksi berkelanjutan yang lebih panjang adalah segmen yang dirangkai, masing-masing dimulai di tempat segmen terakhir berakhir — sambungannya adalah gabungan, bukan potongan, ketika judulnya terbawa melintasi sambungan tersebut.
Apakah saya harus mendeskripsikan setiap langkah gerakan kamera?
Deskripsikan perjalanannya, bukan koreografinya: titik masuk, apa yang diikuti kamera, di mana ia berhenti, dan aksi di antaranya beserta durasi detiknya. Bidikan memberikan waktu pada take; garis posisi memberinya ruang untuk bergerak.
Bagaimana jika model tetap menambahkan potongan?
Anggap itu sebagai masalah teks bidikan terlebih dahulu: regenerasi segmen setelah membuat kontinuitasnya jelas — judul, subjek, posisi di akhir. Jika dua percobaan gagal dengan cara yang sama, bagi take di titik aksi di mana ia terus rusak; sambungan yang direncanakan lebih baik daripada potongan yang tidak direncanakan.
Bisakah take menyertakan kerumunan atau lalu lintas jalanan?
Bisa, jika kerumunan dinyatakan di tingkat adegan dan dipertahankan di sana — orang-orang latar belakang sebagai keadaan tetap lokasi, bukan penemuan baru per aksi. Kerumunan yang tidak dinyatakan akan terbaca sebagai kerumunan yang berbeda di setiap detik take.
Dua panduan membahas lebih dalam: bagaimana konsistensi spasial terjaga dan cara melatih syuting sungguhan dengan klip yang dihasilkan adalah mekanismenya, dan jawaban serupa tentang membangun video lebih dari satu menit membahas perhitungan segmen yang diasumsikan halaman ini. Catatan metode menjelaskan bagaimana jumlah seperti ini dikumpulkan.
Rencanakan take di tempat yang bisa direncanakan
Unggah naskah; SceneMixer menulis storyboard, mengatur ruangan dalam model spasial, dan merender take per segmen.
Daftar gratisTarif video per detik ada di halaman harga dengan angka yang sama.
Harga·Panduan·Contoh·Alternatif·Tanya Jawab·Dukungan·Privasi·Ketentuan·Informasi hukum·Hubungi kami·Program afiliasi·© 2026 SceneMixer