問答 · 格式
那些 AI 視頻是怎麼做出來的?
更新於 2026 年 11 月 18 日

大家說的「那些」AI 視頻是指什麼
這個問題通常附上一個連結,卻沒有文字說明。一個抱怨睡前時間的會說話寶寶、一段像肥皂劇般分手的蘋果與香蕉、一隻旁白自家主人糟糕決定的貓,還有一個小人物帶你遊覽歷史街道。r/aivideo 上有一則貼文只用一句話問道:
「你能告訴我這些視頻是怎麼做的嗎?」
這些格式看起來各不相同,但背後的問題一樣,而且很常見:社群語料中約有 98 則貼文在問,如何重現自己在某處看到的視頻風格。簡短的答案是,這些片段沒有一個是單一的神奇提示詞。每一支都是小型製作,有角色陣容、劇本和格式,只要知道去哪裡看,各個部分其實很容易指出來。
大家怎麼做出那些 AI 視頻?同樣的三層結構
一個會反覆出現的角色。 能成長的帳號不會隨便發片段,而是一集接一集地發同一個寶寶、同一對水果、同一隻得意的貓。角色只設計一次,帶有一個醒目的特徵,這個設計會在每個鏡頭中重複使用。觀眾追隨的是一張臉,不是一個模型。
帶有鉤子的劇本。 前兩秒就提出問題或笑點:寶寶不肯吃蔬菜,香蕉另有新歡。接著是簡短的對話、一個反應,以及一個看向鏡頭的眼神。三十秒就足夠。寫作承擔的工作比渲染還多。
一種聲音和一個畫幅。 這類片段大多會說話,而聲音本身就是笑點的一部分:寶寶的臉配上成熟的嗓音,水果配上戲劇化的聲音。它們採直式手機畫幅,並以一拍收尾,讓下一集很容易接上。
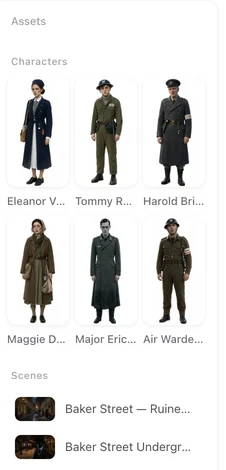
在 SceneMixer 一步步做一支
新建一個直式專案,貼上或撰寫一個短劇本;只要一句話,AI 創作就能起草出一版。劇本會被讀成角色、場景和集數大綱。每個角色都會有一張設定圖,從設定圖裁出的臉部和身體局部,會放進角色出現的每個片段中,所以週一的寶寶就是週五的寶寶。在任何東西渲染之前,你可以逐鏡頭以文字編輯分鏡:發生什麼、誰在說話,以及台詞要怎麼演。接著生成片段,對白由角色在片段中說出,最後合併成一個檔案,由你下載並自行發布。
非人類主角的做法相同。水果、寵物或機器人,不過就是一個有設定圖的角色;描述是什麼讓它容易辨認,並讓那個細節保持不變。真人的逼真臉孔不接受作為參考,因此角色陣容必須是虛構的,這也能讓帳號免於被投訴冒充他人。
該從哪種格式開始
挑選一個你能一再重複其笑點的格式。會說話的寶寶適合有一個反覆出現的執念。水果連續劇適合人物關係清楚到不必背景也能看懂。寵物旁白適合以主人為貫穿笑點。歷史 vlog 適合每集造訪一個地點、一個時刻。如果你十分鐘內寫不出這個格式的五個集數點子,那它只是一次性的,而一次性的內容很少能累積追蹤者。
每集只設定一個場景、處理一個問題。短劇本渲染更快、花費更少,也更容易修改:如果某句台詞效果不好,只改那句並重新生成那一段,而不是整集重做。
限制:複製爆紅格式做不到什麼
- 格式不是保證:同樣的做法,對某個帳號有效,對另一個未必;而平台以外的人,都看不出原因。
- 照搬別人的角色、聲音或整集內容,就是抄襲其作品;借用結構即可,角色陣容請自行虛構。
- 你看到的一些片段,是在生成後經過手工剪輯的;單一工具一次不會重現每種效果。
- SceneMixer 製作視頻;發布、應用程式內的字幕和成長則由你自己負責。
- 「重現」問題的則數,是依據一段固定時間範圍內的公開貼文,以規則比對得出的。
常見問題
Reddit 討論串一直在問的那些 AI 視頻,要怎麼做?
把片段拆成幾個部分:反覆出現的角色、帶鉤子的短劇本、一段聲音,以及直式畫幅。SceneMixer 會依你的劇本建構每個部分,並讓角色在每個鏡頭中保持一致。
大家怎麼每次都用同一個角色做出那些 AI 視頻?
他們只設計一次角色,並重複使用該設計。在 SceneMixer 中,設定圖會附在角色出現的每個片段上。
會說話的寶寶或水果視頻,能免費做嗎?
你可以免費起步:在 SceneMixer,新帳號的前幾張設定圖與第一版分鏡免費;視頻在你渲染後按秒計費。
做那些 AI 視頻需要剪輯軟體嗎?
片段本身不需要:SceneMixer 會把各段合併成一個檔案。如果你想加平台字幕或額外特效,剪輯軟體會有幫助。
相關:製作寶寶 AI 視頻、重現你在網路上看到的視頻風格、AI 水果連續劇指南、非人類角色,以及此則數字背後的統計方法。