إجابات · الأداء
كيف أحصل على عاطفة وتمثيل حقيقيين من شخصيات الذكاء الاصطناعي؟
تم التحديث في 31 أكتوبر 2026
ما الذي يحكم عليه المشاهدون فعلًا
اختبار تمثيل جنبًا إلى جنب في المدونة يُظهر ما يحكم عليه المشاهدون. وقد سرد صاحبه ما كان يراقبه:
كنت أنظر أساسًا إلى أشياء مثل حركة العينين، والتعبيرات الدقيقة، والتوقيت، والانتقالات العاطفية، وهل يبدو الأداء إنسانيًا فعلًا
لاحظ كم من هذه القائمة يتعلق بالزمن: الانتقالات والتوقيت أشياء تحدث بين اللحظات، لا داخل لحظة واحدة. وذهب ردّ في النقاش نفسه أبعد، فحكم على المشهد بالأجساد لا بالوجوه:
هذا لا يتسق فعلًا مع لغة جسدهم.
كلتا النقطتين تقودان إلى الخلاصة نفسها. التمثيل ليس خاصية في الوجه يفتحها نموذج أفضل؛ إنه العلاقة بين ما حدث، وما تفعله الشخصية حياله، وكم من الوقت نراها تفعله. وهذه كلها أمور يتحكم فيها وصف اللقطة.
امنح الشخصية سببًا
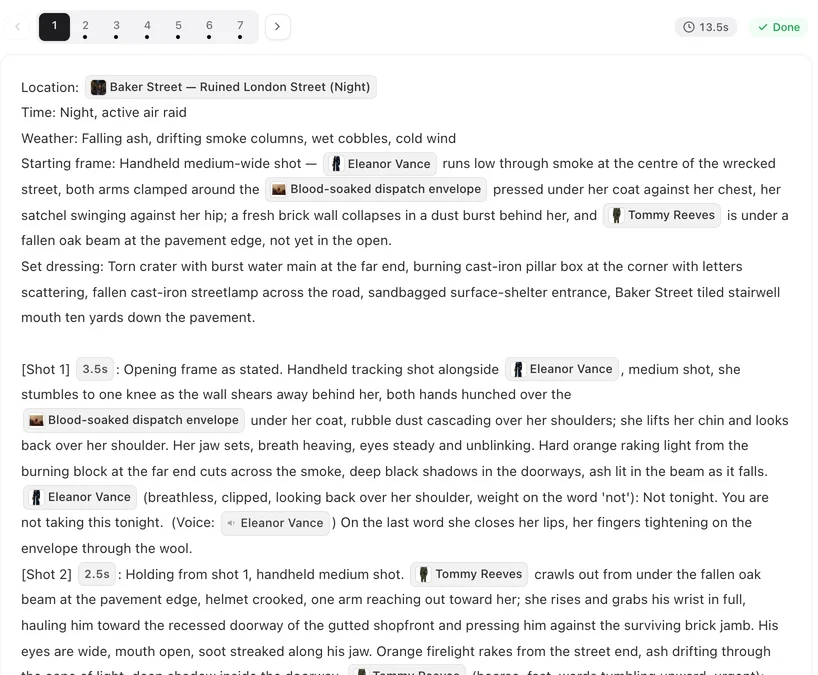
تبدأ العاطفة في القصة. شخصية قرأت للتو رسالة، أو خسرت جدالًا، أو رأت من ظنت أنه رحل، لديها ما تتفاعل معه؛ أما شخصية قيل لها أن تبدو حزينة في غرفة فارغة فلا. في SceneMixer، عند قراءة النص تحصل كل شخصية أيضًا على ملاحظة قصيرة عن شخصيتها مأخوذة من القصة، وتنتقل هذه الملاحظة إلى كل storyboard يُكتب لها. ما تفعله الشخصية في اللقطة، وملاحظة الأداء بين القوسين، وكلمات الجملة هي ما تصوّره الكاميرا فعلًا — فالمشهد الذي يمهّد للسبب في اللقطة السابقة يعطي اللقطة التالية ما تؤديه.
اكتب السبب، ثم رد الفعل
الكلمات التي تصف نتيجة — منكسر القلب، مهدِّد، فرِح للغاية — تميل إلى أن تُرسم كوجه ثابت. أما الكلمات التي تصف سببًا ورد فعل جسديًا فتتيح للأداء أن يحدث: تقرأ السطر الأخير، وتطوي الرسالة على ثنيتها القديمة، ولا ترفع نظرها. لقطة التمثيل الجيدة تحتوي عادةً على إيقاع واحد:
- المحفّز: ما تراه الشخصية أو تسمعه، ويفضّل أن يكون في اللقطة السابقة.
- رد الفعل الأول: شيء صغير وجسدي — نفَس محبوس، يد تتوقف، عينان تتجهان إلى الباب.
- القرار: ما تفعله بعد ذلك، وهنا تصبح العاطفة مقروءة.
التزم بفعل واحد في كل لقطة وامنحه ثواني كافية. ثانيتان رد فعل؛ وأربع ثوانٍ انتقال. اللقطة التي يجب أن تتسع لكشف ورد فعل وجواب في ثلاث ثوانٍ ستعرض الثلاثة ضبابًا.
الجملة تحمل الأداء
يُولَّد الحوار مع الصورة، فطريقة قول الجملة تشكّل الوجه الذي يقولها. تعيش كل جملة داخل اللقطة التي تُقال فيها: المتحدث، وملاحظة الأداء بين قوسين، والكلمات، والصوت الذي ينطقها. «(بهدوء، دون أن ينظر إليه)» توجيه يعرفه أي ممثل، وهو ما يحوّل الجملة من مُلقاة إلى مقصودة. والمستمع لا يقل أهمية عن المتحدث: اكتب ما تفعله الشخصية الأخرى بينما تقع الجملة عليها — فكّ يتوتر، نظرة تُصرف — وأبقِ شفتيها مغلقتين. والحوار ومزامنة الشفاه خيط كبير في المدونة بحد ذاته، بواقع 2,600 منشور.
قريب بما يكفي لنراه
التأطير يقرر هل الأداء مرئي أصلًا. التفاعلات الصغيرة تعيش في اللقطات القريبة والمتوسطة القريبة؛ واللقطة الواسعة تُظهر ما حدث لا ما عناه. بدّل بين الوجهين في المواجهة، وغيّر التأطير في كل قطع ليُقرأ المشهد كتغطية لا كلقطة واحدة متقطعة. وحين يكون المقطع النهائي صحيحًا إلا في تفصيل واحد — تعبير مختلف قليلًا مثلًا — فتغيير التعبير أحد التعديلات الثابتة التي يمكن إجراؤها على المقطع في مكانه دون إعادة توليد اللقطة.
الاختبار الذي يطبقه المشاهدون هو الذي سمّاه مباشرة ردّ تحت إعلان قصير في r/aivideo قدّم العاطفة على المؤثرات:
هناك قصة، وقدر من تطور الشخصية، وبعض التوتر، وتوقيت سليم.
حدود الإخراج بالنص
- أنت تخرج لنموذج لا لممثل: النص نفسه قد يعطي لقطة أقوى أو أضعف في كل مرة، فاحسب حسابًا لإعادة توليد اللقطة الأساسية.
- الأداء الدقيق جدًا الممتد طويلًا هو الأصعب؛ واللقطات الأقصر ذات الإيقاع الواضح أكثر موثوقية.
- تقليد وجه ممثل حقيقي أو صوته مرفوض؛ يجب أن ينتمي الأداء إلى شخصية مخترعة.
- المقارنات المقتبسة هنا أحكام مشاهدين أفراد، والأعداد تقديرات قائمة على قواعد من فترة واحدة.
الأسئلة الشائعة
لماذا تبدو شخصيات الذكاء الاصطناعي كأنها تتكلف التعابير؟
لأن اللقطة تسمّي نتيجة مثل حزين أو غاضب، فتُرسم رسمًا. اكتب السبب ورد فعل جسديًا صغيرًا بدلًا من ذلك، وامنحه بضع ثوانٍ.
كيف أخبر الشخصية بطريقة قول الجملة؟
ضع ملاحظة أداء بين قوسين قبل الكلمات، مثل (بهدوء، دون أن ينظر إليه). تُؤدى الجملة بهذه الطريقة في عملية التوليد نفسها مع الصورة.
أي تأطير يُظهر العاطفة أفضل؟
اللقطات القريبة والمتوسطة القريبة للتفاعلات؛ واللقطات الواسعة لما حدث. غيّر التأطير في كل قطع بين وجهين.
هل أستطيع إصلاح تعبير واحد دون إعادة توليد؟
نعم. تغيير التعبير أحد التعديلات الثابتة التي يمكن إجراؤها على مقطع منتهٍ في مكانه.
لجانب الكتابة، اقرأ منح الشخصية شخصية يُظهرها الفيديو وكتابة الحوار في الـ storyboard؛ وتغطي الإجابة عن الحفاظ على الصوت نفسه الجانب الصوتي. تتبع الأعداد ملاحظة المنهج.
أخرِج المشهد، لقطةً بعد لقطة
يكتب SceneMixer كل جملة مع طريقة أدائها وينتج الصوت والصورة معًا؛ وأنت تعدّل الإيقاعات قبل إنتاج أي شيء.
سجّل مجانًاأسعار الفيديو بالثانية في صفحة الأسعار بالأرقام نفسها.