Antwoorden · Acteerprestatie
Hoe krijg ik echte emotie en acteerwerk uit AI-personages?
Bijgewerkt 31 oktober 2026
Waar kijkers eigenlijk op letten
Een acteertest naast elkaar in het corpus laat zien waarop kijkers oordelen. De maker somde op waar hij naar keek:
Ik keek vooral naar dingen als oogbewegingen, microexpressies, timing, emotionele overgangen en of het spel echt menselijk aanvoelt
Merk op hoeveel van die lijst over tijd gaat: overgangen en timing gebeuren tussen momenten, niet in één ervan. Een reactie in dezelfde thread ging verder en beoordeelde de scène op de lichamen, niet de gezichten:
Dat past niet echt bij hun lichaamstaal.
Beide punten leiden tot dezelfde conclusie. Acteren is geen eigenschap van een gezicht die een beter model ontsluit; het is de verhouding tussen wat er gebeurde, wat het personage daarmee doet en hoe lang we kijken terwijl het dat doet. Dat zijn allemaal dingen die een shotbeschrijving bepaalt.
Geef het personage een reden
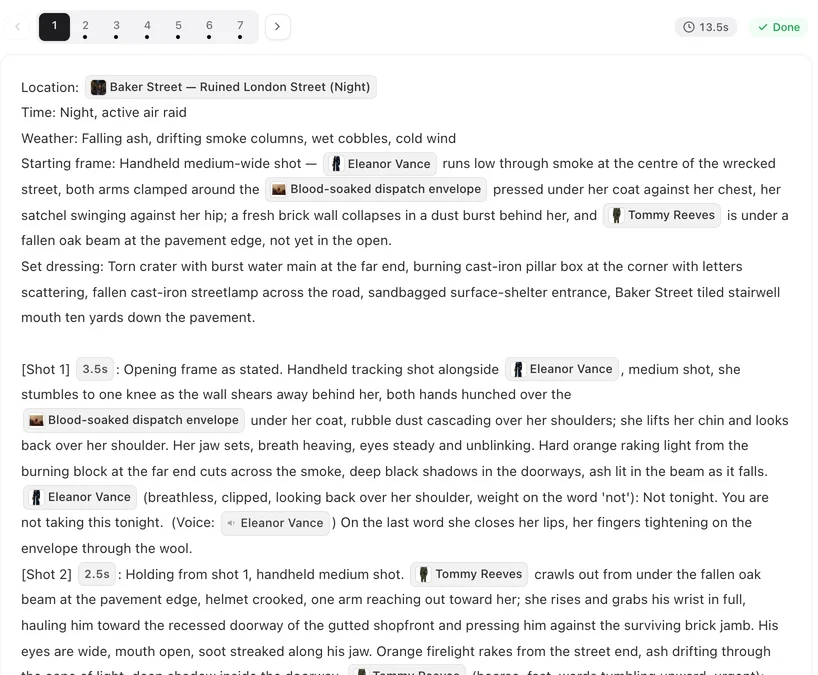
Emotie begint in het verhaal. Een personage dat net een brief heeft gelezen, een ruzie heeft verloren of iemand ziet die hij weg waande, heeft iets om op te reageren; een personage dat verdrietig moet kijken in een lege kamer niet. In SceneMixer krijgt elk personage bij het lezen van het script ook een korte notitie over zijn persoonlijkheid uit het verhaal, en die notitie gaat mee in elke storyboard die voor hem wordt geschreven. Wat een personage in een shot doet, de voordrachtsnotitie tussen haakjes en de woorden van de regel zijn wat de camera echt filmt — een scène die de reden in de vorige shot opbouwt, geeft de volgende shot iets om te spelen.
Schrijf de oorzaak, dan de reactie
Woorden die een resultaat beschrijven — gebroken, dreigend, dolblij — worden vaak als een vast gezicht opgeschilderd. Woorden die een oorzaak en een lichamelijke reactie beschrijven, laten het spel ontstaan: ze leest de laatste regel, vouwt de brief langs zijn oude vouw en kijkt niet op. Een goede acteershot bevat meestal één beat:
- De trigger: wat het personage ziet of hoort, het liefst in de shot ervoor.
- De eerste reactie: iets kleins en lichamelijks — een ingehouden adem, een hand die stopt, ogen die naar de deur gaan.
- De beslissing: wat ze daarna doen, waar de emotie leesbaar wordt.
Houd het bij één handeling per shot en geef haar genoeg seconden. Twee seconden is een reactie; vier is een overgang. Een shot dat een onthulling, een reactie en een antwoord in drie seconden moet proppen, speelt ze alle drie als een waas.
De regel draagt de voordracht
Dialoog wordt samen met het beeld gegenereerd, dus hoe een regel wordt gezegd, bepaalt het gezicht dat hem zegt. Elke regel staat binnen de shot waarin hij wordt uitgesproken: de spreker, een voordrachtsnotitie tussen ronde haakjes, de woorden en de stem die ze uitspreekt. "(zacht, zonder hem aan te kijken)" is een aanwijzing die een acteur zou herkennen, en het maakt van een voorgedragen regel een gemeende. De luisteraar telt net zo zwaar als de spreker: schrijf wat het andere personage doet terwijl de regel landt — een kaak die zich spant, een blik opzij — en houd de lippen dicht. Dialoog en lipsync zijn op zich al een grote draad in het corpus, met 2,600 posts.
Dichtbij genoeg om het te zien
De kadrering bepaalt of een rol überhaupt zichtbaar is. Kleine reacties wonen in close-ups en medium close-ups; een totaalshot laat zien wat er gebeurde, niet wat het betekende. Snij in een confrontatie heen en weer tussen de twee gezichten en wissel de kadrering bij elke snede, zodat de scène als dekking leest in plaats van als één hakkelende shot. Klopt een afgewerkte clip op één detail na — een uitdrukking die een tikje af is, bijvoorbeeld — dan is de uitdrukking aanpassen een van de vaste bewerkingen die je ter plekke op de clip kunt doen, zonder de shot opnieuw te genereren.
De toets die kijkers toepassen is die welke een reactie onder een korte trailer in r/aivideo die emotie boven effecten stelde direct noemde:
Er is een verhaal, er is een beetje karakterontwikkeling, wat spanning en een goede timing.
Beperkingen van regisseren in tekst
- Je regisseert een model, geen acteur: dezelfde tekst kan elke keer een sterkere of zwakkere take geven, dus reken erop dat je de sleutelshot opnieuw genereert.
- Heel subtiele, lang aangehouden rollen zijn het moeilijkst; kortere shots met een duidelijke beat zijn betrouwbaarder.
- Het nabootsen van het gezicht of de stem van een echte acteur wordt geweigerd; de rol moet bij een verzonnen personage horen.
- De hier geciteerde vergelijkingen zijn oordelen van individuele kijkers, en de aantallen zijn op regels gebaseerde benaderingen uit één periode.
Veelgestelde vragen
Waarom lijken AI-personages gezichten te trekken?
Omdat de shot een resultaat noemt zoals verdrietig of boos, en dat wordt opgeschilderd. Schrijf in plaats daarvan de oorzaak en een kleine lichamelijke reactie, en geef haar een paar seconden.
Hoe vertel ik een personage hoe het een regel moet zeggen?
Zet een voordrachtsnotitie tussen ronde haakjes voor de woorden, zoals (zacht, zonder hem aan te kijken). De regel wordt zo uitgesproken in dezelfde generatie als het beeld.
Welke kadrering toont emotie het best?
Close-ups en medium close-ups voor reacties; totaalshots voor wat er gebeurde. Wissel de kadrering bij elke snede tussen twee gezichten.
Kan ik één uitdrukking herstellen zonder opnieuw te genereren?
Ja. Een uitdrukking aanpassen is een van de vaste bewerkingen die je ter plekke op een afgewerkte clip kunt doen.
Voor de schrijfkant: lees een personage een persoonlijkheid geven die de video laat zien en dialoog schrijven in de storyboard; het antwoord op een stem hetzelfde houden behandelt het geluid. De aantallen volgen de methodenotitie.
Regisseer de scène, shot voor shot
SceneMixer schrijft elke regel met de bijbehorende voordracht en rendert stem en beeld samen; jij bewerkt de beats voordat er iets wordt gerenderd.
Meld je gratis aanDe tarieven per seconde video staan met dezelfde cijfers op de prijspagina.