解答 · 表演
如何讓 AI 角色演出真實的情感與表演?
更新於 October 31, 2026

觀眾真正在評判什麼
語料庫中有一則並排的表演測試,顯示了觀眾評判的重點。作者列出了他們觀察的項目:
我主要看的是眼球動作、微表情、時機、情緒轉換,以及表演究竟是不是有人味
注意這份清單有多少與時間有關:轉換和時機是發生在兩個瞬間之間的事,不是存在於某一個瞬間。同一串討論中的一則回覆更進一步,用身體而不是臉來評斷這個場景:
這跟他們的肢體語言其實不太一致。
兩個觀點指向同一個結論。表演不是更好的模型就能解鎖的臉部屬性;它是發生了什麼事、角色對此做了什麼,以及我們看他們做了多久之間的關係。這些全都是鏡頭描述可以控制的。
給角色一個理由
情感從故事開始。剛讀完一封信、剛吵輸一場架,或是看見以為已經不在的人,這樣的角色有東西可以反應;被要求在空房間裡看起來悲傷的角色就沒有。在 SceneMixer,讀取劇本時,每個角色也會依故事得到一段簡短的個性註記,並帶進為他們寫的每一份分鏡腳本。角色在鏡頭中做的事、括號中的語氣提示,以及台詞的文字,才是鏡頭真正拍下的內容——所以在前一個鏡頭先鋪好理由的場景,會讓下一個鏡頭有東西可以演。
先寫起因,再寫反應
描述結果的詞——心碎、威嚇、欣喜若狂——往往會被畫成一張固定的臉。描述起因與身體反應的詞,才讓表演得以發生:她讀完最後一行,沿著舊摺痕把信摺起來,沒有抬頭。一個好的表演鏡頭通常包含一個節拍:
- 觸發:角色看見或聽見了什麼,最好是在前一個鏡頭。
- 第一個反應:細微的身體動作——屏住呼吸、手停住、視線轉向門口。
- 決定:他們接下來做什麼,情感就在這裡變得清晰可讀。
每個鏡頭只放一個動作,並給足秒數。兩秒是一個反應;四秒是一次轉變。如果一個鏡頭要在三秒內塞進揭露、反應和回應,三者都會變成一團模糊。
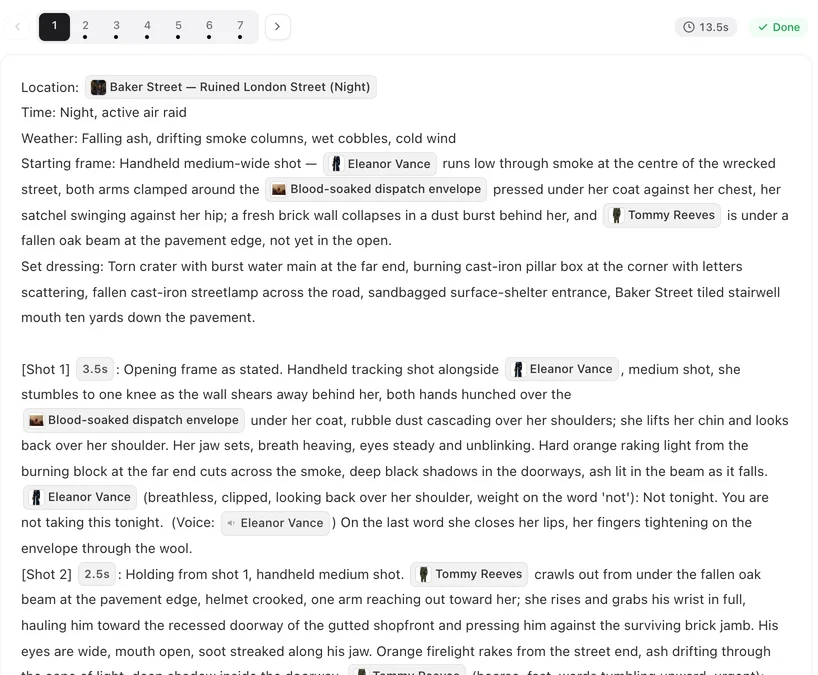
台詞帶著語氣
對白是和畫面一起生成的,所以一句話怎麼說,會塑造說這句話的那張臉。每句台詞都放在說出它的鏡頭裡:說話者、圓括號中的語氣提示、台詞文字,以及說出它的聲音。「(輕聲,不看他)」是演員看得懂的指示,也讓一句台詞從背誦變成真心。聽者和說者同樣重要:寫出另一個角色在這句話落下時做了什麼——下顎繃緊、移開視線——並讓他們的嘴唇保持閉合。對白與對嘴本身就是語料庫中的大主題,有 2,600 篇貼文。
近到看得見
取景決定表演究竟看不看得見。細微的反應存在於特寫和中近景裡;遠景交代發生了什麼,卻看不出那代表什麼。對峙時在兩張臉之間切換,並在每次切換時改變取景,讓場景看起來是多機位剪輯,而不是跳來跳去的單一鏡頭。當完成的片段除了一個細節之外都很好——例如表情稍微差了一點——更改表情是可以直接對片段做的固定編輯之一,不必重新生成鏡頭。
觀眾採用的標準,正是 r/aivideo 一則重情感而非特效的短預告片底下一則回覆直接點出的:
有故事,有一點角色發展,有些張力,還有恰當的時機。
用文字導演的限制
- 你導演的是模型,不是演員:同樣的文字每次可能給出較強或較弱的一版,所以要為重新生成關鍵鏡頭預留預算。
- 非常細膩、長時間維持的表演最難;較短、節拍明確的鏡頭更可靠。
- 模仿真實演員的臉或聲音會被拒絕;表演必須屬於虛構的角色。
- 這裡引用的比較是個別觀眾的判斷,數字則是依規則從單一期間估算的近似值。
常見問題
為什麼 AI 角色看起來像在做鬼臉?
因為鏡頭寫的是「悲傷」或「憤怒」這類結果,那會被直接畫上去。改寫起因和細小的身體反應,並給它幾秒鐘。
如何告訴角色這句台詞該怎麼說?
在台詞文字前面用圓括號寫語氣提示,例如(輕聲,不看他)。這句台詞會在與畫面同一次生成中依此演出。
哪種取景最能呈現情感?
反應用特寫和中近景;發生了什麼用遠景。在兩張臉之間的每次切換都改變取景。
可以只修一個表情而不重新生成嗎?
可以。更改表情是可以直接對已完成片段做的固定編輯之一。
寫作面請讀賦予角色影片看得出來的個性與在分鏡腳本中寫對白;關於保持聲音一致的解答則談聲音。數字依據方法說明。