답변 · 연출
AI가 영화를 연출할 수 있나요?
2026년 11월 6일 업데이트
사람들이 이미 연출을 보는 곳
AI 영상이 잘 나오면 시청자는 도구보다 사람을 칭찬하는 경향이 있습니다. r/aivideos의 액션 시리즈 아래에서, 무엇이 행해졌는지 가장 잘 묘사한 댓글은 연출가에 대한 평처럼 읽혔습니다:
그런 연속성을 얻으려면 프롬프트에 필요한 정밀도가 최고 수준의 감독급입니다.
그 말이 맞습니다. 연출은 일련의 결정입니다. 각 샷이 무엇을 보여 주는지, 얼마나 지속되는지, 카메라가 어디 있는지, 프레임에 누가 있는지, 대사가 어떻게 말해지는지. 그리고 연속성은 그 결정들이 일관되게 내려졌다는 증거입니다. 카메라와 샷 기법은 커뮤니티 자료에서 가장 큰 주제 중 하나이며, 약 22,000개 게시글이 있습니다. 질문은 그 결정 중 어떤 것을 도구가 여러분 대신 맡아 줄 수 있느냐입니다.
SceneMixer에서 AI가 결정하는 것
기계적인 절반의 상당 부분입니다. 대본을 읽으면 각 에피소드는 세그먼트와 번호가 매겨진 샷들의 스토리보드가 되며, 각 샷은 고유한 길이, 프레이밍 변화, 행동을 갖습니다. 샷 길이는 대사에서 파생되므로 아홉 단어짜리 대사에 배우가 1.5초를 받는 일은 없습니다. 누가 화면에 있는지는 샷마다 표시되며, 단지 보이거나 말을 걸리기만 하는 사람은 이름 대신 지시문으로 적히므로, 한 사람만 나오는 샷에 그 얼굴이 나타나지 않습니다.
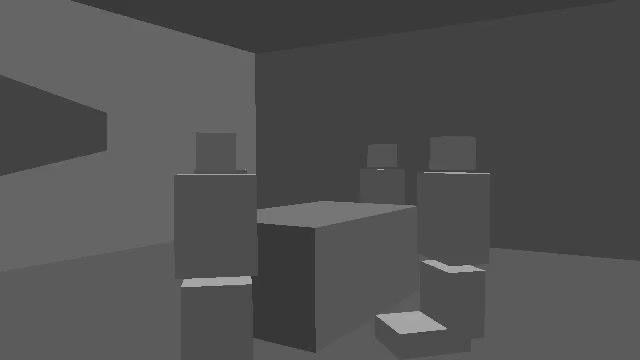
연출의 배치도 처리됩니다. SceneMixer는 각 장면의 자동 AI 3D 모델을 만들고, 그 장면의 모든 샷은 그 하나의 모델을 기준으로 생성됩니다. 그래서 와이드 샷, 클로즈업, 리버스 샷이 서로 다른 위치에서 같은 방을 묘사합니다. 카메라 위치를 쓸 필요는 없습니다. 누가 누구를 마주 보는지만 말하면, 배치가 카메라를 그것이 참이 되는 곳에 둡니다. 여러분은 그 모델을 보지도, 만지지도 않습니다.
여러분에게 남는 것
- 캐스팅. 모든 등장인물 시트와 장소 이미지를 승인하세요. 얼굴은 결정이며, 그것은 여러분의 몫입니다.
- 이야기. 읽기는 여러분이 준 것을 각색합니다. 무슨 일이 어떤 순서로, 왜 일어나는지는 여러분의 대본입니다.
- 연기. 전달은 각 대사에 붙은 메모(화남, 지침, 거의 들리지 않는)로 조절되며, 어떤 테이크를 남길지는 여러분이 정합니다.
- 여러분이 신경 쓰는 카메라. 스토리보드는 샷마다 프레이밍과 움직임을 제안합니다. 카메라가 다른 일을 해야 한다면 단어를 고치세요. 짧은 샷, 컷마다 다른 프레이밍, 움직임은 하나씩.
- 컷. 모든 재생성은 버전으로 보관되며, 어느 것이 에피소드에 들어갈지는 여러분이 정합니다.
AI 속도로 하는 감독의 작업 방식
스토리보드를 촬영 대본으로, 렌더링을 촬영으로 다루세요. 생성하기 전에 모든 세그먼트를 읽으세요. 샷마다 행동 하나, 각 대사에 충분한 초, 프레임에 맞는 사람. 그다음 세그먼트 하나를 렌더링하고 데일리처럼 평가하세요. 사이트에서 2026년 11월 6일까지의 30일 동안 측정하면, 세그먼트는 중간값 약 4분에 나왔고, 전체 에피소드는 첫 세그먼트가 시작된 뒤 24분 만에 완성되었습니다. 메모와 새 테이크 사이의 순환이 하루가 아니라 몇 분 단위입니다.
역할 분담이 유용한 부분입니다. 이곳의 초보 감독은 세 사람의 대화를 어떻게 블로킹하는지, 리버스 샷을 위해 카메라를 어디 두는지 알 필요가 없습니다. 배치가 그 일을 합니다. 그들에게 필요한 것은 시각, 즉 장면이 무엇에 관한 것인지, 대사가 떨어질 때 관객이 누구의 얼굴을 봐야 하는지, 그리고 그냥 괜찮은 테이크를 거부할 인내심입니다. 그 절반은 자동화할 수 없으며, 같은 대본에서 두 편의 다른 영화를 만드는 것도 바로 그 절반입니다.
쓸모 있는 카메라 어휘는 카메라 움직임 프롬프트 쓰는 법과 시네마틱 카메라 움직임 쓰기를 보세요. 배치가 사람을 제자리에 두는 방식은 공간 일관성이 각 장면 뒤의 3D 모델을 설명합니다.
자동 연출의 한계
- 아주 느린 카메라 움직임은 정지 화면처럼 나올 수 있습니다. 여러분이 신경 쓰는 움직임은 분명하고, 볼 수 있을 만큼 빠르게 만드세요.
- 렌즈 번호, 카메라 브랜드, 스타일 태그 나열은 별 효과가 없습니다. 카메라가 무엇을 하는지, 시청자가 무엇을 느껴야 하는지를 묘사하세요.
- 복잡한 블로킹, 즉 카메라가 방을 지나가는 동안 여러 사람이 각자 다른 일을 하는 장면은 대화 장면보다 더 많은 시도가 필요합니다.
- 사이트 수치는 한 달 동안의 SceneMixer 작업 기준이며 매달 갱신됩니다. 커뮤니티 수치는 키워드 근사치입니다.
FAQ
AI가 카메라 각도를 고르나요?
스토리보드에서 샷마다 제안하고, 각 장면의 3D 모델 안에 카메라를 둡니다. 다른 것을 원하면 어디서든 단어를 고치면 됩니다.
카메라 위치를 직접 써야 하나요?
아니요. 누가 누구를 마주 보는지 말하면, SceneMixer의 배치가 그것이 참이 되는 곳에 카메라를 둡니다.
연기도 연출할 수 있나요?
네. 각 대사 앞의 괄호 메모로, 그리고 어떤 테이크를 남길지 고르는 것으로 가능합니다. 재생성은 모두 버전으로 보관됩니다.
배치 기능에 추가 비용이 드나요?
아니요. 모든 장면은 기본 과정에서 3D 모델을 함께 만들며, 가격은 추가되지 않아요.
관련: AI로 스토리보드 만드는 법은 촬영 대본을 다루고, 한 테이크 액션 샷 계획하기는 연출이 가장 어려운 경우이며, 커뮤니티 수치는 수집 방법을 따릅니다.