回答 · 演出
AIで映画を演出できる?
2026年11月6日更新
人々がすでに演出を見ている場所
AI動画がうまくいくと、視聴者は道具ではなく、人を評価しがちです。r/aivideosのアクションシリーズの下で、何が行われたかを最もよく言い当てたコメントは、監督へのレビューのように読めました。
そうした連続性を得るために、プロンプトで必要な精密さは、トップの監督レベルです。
それは正しい捉え方です。演出は一連の判断です。各ショットが何を見せるか、どれだけの長さか、カメラがどこにあるか、誰がフレームに入るか、セリフがどう言われるか。そして連続性は、それらの判断が一貫して行われた証拠です。カメラとショットの技術は、コミュニティのコーパスで最も大きな話題の一つで、約22,000件の投稿があります。問題は、そのうちどの判断をツールがあなたの代わりに引き受けられるかです。
SceneMixerでAIが決めること
機械的な半分の、かなりの部分です。脚本が読み込まれると、各エピソードは、セグメントと番号付きショットの絵コンテになり、それぞれに固有の長さ、構図の変化、動きがあります。ショットの長さはセリフから導かれるので、どの俳優も9語のセリフに1.5秒しか与えられません。画面に誰がいるかはショットごとに示され、見られているだけ、または話しかけられているだけの人は、名前ではなく指示として書かれるので、一人だけのショットに顔が現れることはありません。
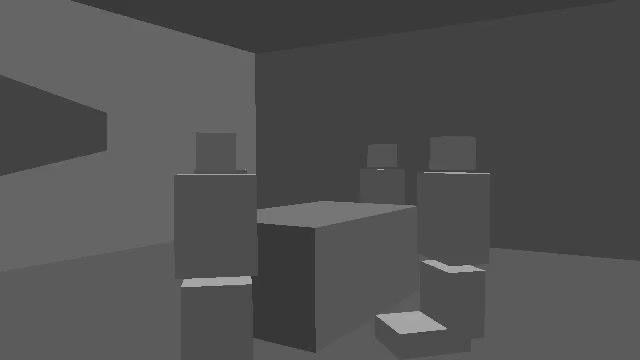
立ち位置の設計も扱います。SceneMixerは各シーンの自動的なAI 3Dモデルを作り、そのシーン内のすべてのショットは、その一つのモデルに対して生成されます。そのため、引きのショット、寄りのショット、切り返しのショットは、同じ部屋を異なる位置から描きます。カメラの位置を書く必要はありません。誰が誰を向いているかを言えば、演出がそれが正しくなる場所にカメラを置きます。そのモデルを見ることも、触ることもありません。
あなたの手元に残るもの
- キャスティング。 すべてのキャラクターのシートとロケーション画像を承認するのはあなたです。顔は判断であり、その判断はあなたのものです。
- 物語。 読み込みはあなたが与えたものを脚色します。何が起き、どの順番で、なぜ起きるのかは、あなたの脚本です。
- 演技。 話し方は、各セリフに付けたメモ(怒って、疲れて、ほとんど聞こえないように)によって導かれ、どのテイクを残すかを決めるのはあなたです。
- あなたがこだわるカメラ。 絵コンテは、ショットごとに構図と動きを提案します。カメラに別のことをさせたい場所では、言葉を編集してください。短いショット、カットごとに違う構図、一つずつの動き。
- カット。 すべての生成はバージョンとして残ります。どれをエピソードに入れるかは、あなたの判断です。
AIの速さでの、監督のワークフロー
絵コンテを撮影台本として、レンダリングを撮影として扱ってください。生成する前に各セグメントを読みます。ショットごとに一つのはっきりした動き、各セリフに十分な秒数、正しい人物がフレームに入っていること。それから1本のセグメントをレンダリングし、デイリーラッシュのように判断します。サイトで2026年11月6日までの30日間の期間に計測すると、セグメントは中央値で約4分で戻ってきて、1話全体は最初のセグメントの開始から24分で完成しました。メモと新しいテイクのあいだのループは、一日ではなく数分です。
役割分担こそが役に立つ部分です。ここで初めて演出をする人は、三人の会話をどう配置するか、切り返しのためにカメラをどこに置くかを知る必要はありません。それは演出が行います。必要なのは視点です。このシーンが何についてなのか、セリフが決まったときに観客がどの顔を見るべきなのか。そして、ただ良いだけのテイクを却下する忍耐力です。その半分は自動化できず、同じ脚本から二本の映画を違うものにするのは、その半分です。
効果のあるカメラの語彙については、カメラの動きのプロンプトの書き方と映画的なカメラの動きを書くを参照してください。演出が人物を所定の位置に保つ方法については、空間の一貫性が各シーンの背後にある3Dモデルを説明しています。
自動演出の限界
- 非常にゆっくりしたカメラの動きは、静止して見えることがあります。こだわる動きは、見えるくらいはっきりと、十分速く作ってください。
- レンズの番号、カメラのブランド、スタイルタグの羅列は、ほとんど効果がありません。カメラが何をして、視聴者が何を感じるべきかを説明してください。
- 複雑な配置、つまりカメラが部屋を移動する間に、複数の人がそれぞれ別のことをする場合は、会話のシーンより多くの試行が必要です。
- サイトの数値はSceneMixerのタスク1か月分で、毎月更新しています。コミュニティの件数はキーワードによる概算です。
よくある質問
AIがカメラアングルを選びますか?
絵コンテでショットごとに提案し、各シーンの3Dモデルの中にカメラを配置します。ほかのものが欲しい場所では、言葉を編集してください。
カメラの位置を自分で書く必要がありますか?
いいえ。誰が誰を向いているかを言えば、SceneMixerの演出がそれが正しい場所にカメラを置きます。
演技も自分で演出できますか?
はい。各セリフの前の括弧つきのメモと、どのテイクを残すかを選ぶことで。すべての生成はバージョンとして残ります。
演出に追加料金はかかりますか?
いいえ。すべてのシーンは通常の工程の一部として3Dモデルが作られ、料金が増えることはありません。
関連:AIで絵コンテを作る方法では撮影台本を扱い、ワンテイクのアクションショットを計画するは演出の最も難しい場面であり、コミュニティの件数は集計方法に従っています。