解答 · 導演
AI 能導一部電影嗎?
更新於 2026 年 11 月 6 日

人們已經在哪裡看見導演功力
AI 影片做得好的時候,觀眾通常歸功於做的人,而不是工具。在 r/aivideos 裡一個動作系列的貼文 底下,最能形容所做之事的留言,讀起來像在評論一位導演:
要做出那種連戲感,你在提示詞裡所需的精準度,已經是頂級導演的水準。
這個說法很貼切。導演工作就是一連串的決定——每個鏡頭要呈現什麼、持續多久、攝影機在哪裡、畫面裡有誰、一句台詞要怎麼說——而連戲就是這些決定被一致執行的證明。攝影與鏡頭技法是社群語料庫中最大的主題之一,約 22,000 則貼文。問題在於,這些決定裡,哪些可以交給工具代勞。
SceneMixer 上 AI 替你決定什麼
機械性的那一半,它做了很多。讀取劇本後,每一集會變成由片段與編號鏡頭組成的分鏡,每個鏡頭都有自己的時長、景別變化與動作。鏡頭長度從對白推導,所以不會有一句九個字的台詞,卻只給演員一秒半。每個鏡頭都標明畫面上是誰;只是被看或被對話的人,會寫成動作指示而非角色名,因此他們的臉不會出現在單人鏡頭中。
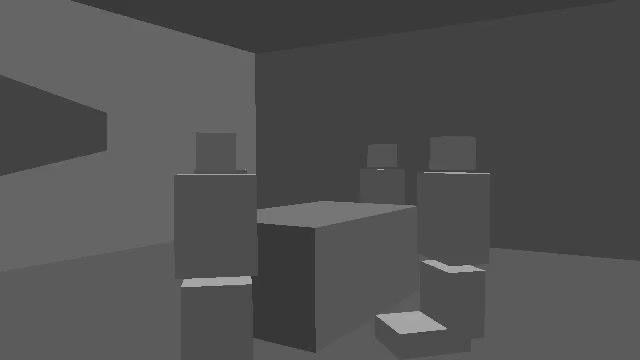
走位也有處理。SceneMixer 會為每個場景自動建立 AI 的三維模型,場景內的每個鏡頭都根據同一個模型生成,因此全景、特寫與反打鏡頭描述的是同一個房間、不同的位置。你不必寫攝影機位置:說明誰面對誰,走位會把攝影機放在讓這件事成立的地方。你看不到這個模型,也不需要去碰它。
仍需你自己掌握的部分
- 選角。 每一張角色表與場景圖都由你核准。臉孔是一項決定,而且是你的決定。
- 故事。 讀取會依你提供的內容改編;發生什麼、按什麼順序、為什麼,是你的劇本。
- 表演。 每句台詞的備註——憤怒、疲倦、幾不可聞——會引導演繹,而你決定保留哪一次。
- 你在意的攝影機。 分鏡會逐鏡提出景別與運鏡;若攝影機該做別的,就改文字。短鏡頭、每次切換景別不同、每鏡一個動作。
- 剪輯。 每一次重新生成都會被保存為一個版本;哪一個放進成片,由你決定。
導演的工作流程,以 AI 速度運行
把分鏡當成拍攝腳本,把算圖當成拍攝本身。生成前先讀每一段:每個鏡頭一個清楚的動作、每句台詞有足夠的秒數、畫面裡是對的人。然後算一段,像看粗剪樣片那樣判斷它。在本站 截至 2026 年 11 月 6 日的 30 天 內,一段影片的中位數約 4 分鐘就回來,整集則在第一段開始後 24 分鐘完成,因此從一個備註到一次新拍攝的循環是幾分鐘,而不是一天。
分工才是有用的部分。這裡的新手導演不需要懂得如何調度三人對話,或反打鏡頭該把攝影機放在哪裡;這些由走位處理。他們真正需要的是一個觀點——這場戲在講什麼、台詞落下時觀眾應該看誰的臉——以及拒絕一個只是還可以的版本的耐心。這一半無法自動化,而正是它讓同一個劇本拍出兩部不同的電影。
關於有效的攝影詞彙,參見 如何寫攝影機運動提示詞 與 撰寫電影化的攝影運動;至於走位如何讓人物留在位置上,空間一致性說明了每個場景背後的三維模型。
自動導演的限制
- 非常緩慢的攝影運動可能會生成成靜止畫面;請讓你在意的運動清楚而迅速,好讓人看得見。
- 鏡頭焦段數字、相機品牌與一長串風格標籤作用不大。請描述攝影機做什麼、以及觀眾該感受到什麼。
- 複雜的走位——多人各自做不同的事,同時攝影機穿越房間——比對話場景需要更多次嘗試。
- 網站數字是 SceneMixer 一個月的任務,每月更新;社群數字是關鍵字近似值。
常見問題
AI 會替我選攝影機角度嗎?
它會在分鏡中逐鏡提出角度,並把攝影機放在每個場景的三維模型之內;你想要別的,就改文字。
我必須寫攝影機位置嗎?
不必。說明誰面對誰,SceneMixer 的走位就會把攝影機放在讓這件事成立的位置。
我能指導演技嗎?
可以,透過每句台詞前方的括號備註,以及選擇要保留哪一次。每次重新生成都會被保存為一個版本。
走位要額外收費嗎?
不會。每個場景都會作為一般流程的一部分產生 3D 模型,而且不會增加價格。
相關:如何用 AI 做分鏡 涵蓋拍攝腳本,規劃一鏡到底的動作戲 是最難的導演工作,社群數字則依循收集方法。