Antwoorden · Stem
Hoe houd ik de stem van een personage consistent tussen afleveringen?
Bijgewerkt 14 oktober 2026

De drie manieren waarop een personage een stem kan hebben
Personages worden gekoppeld aan een vooraf ingestelde stembibliotheek in plaats van ontworpen op basis van een tekstbeschrijving, en je kunt ook je eigen sample voor een personage uploaden. Concreet zijn er drie statussen waarin een personage zich kan bevinden. De eerste is een stem die in woorden is beschreven: leeftijd, gewicht en tempo, overgenomen uit de scriptlezing, uitgevoerd door het videomodel. Dat is waar elk personage begint tenzij je iets aanpast, en het doet een redelijke job — de beschrijving is wat het model hoort in plaats van een sample.
De tweede is een gekoppelde voorinstelling. Elke stem in de bibliotheek wordt geleverd met een korte sample die je kunt afspelen voor je kiest; de site stelt per personage een match voor op basis van geslacht, taal en leeftijd, en je kunt opnieuw koppelen of handmatig een andere kiezen via de selector. Koppelen is een gratis modelaanroep — het verbruikt geen credits en wordt niet geblokkeerd door je gelijktijdigheidslimiet. De derde is je eigen opname: upload een sample voor een personage en die wordt de stemreferentie van dat personage voor elk segment waarin ze spreken, en latere koppelingen overschrijven het niet.
Eén grens om in acht te nemen: de gekoppelde bibliotheek en de uploadmogelijkheid zijn bedoeld voor stemmen die je bezit of waarvoor je een licentie hebt. De eigen nalevingsrichtlijnen van de site behandelen gelijkenis — zowel gezicht als stem — als iets waar je het recht op moet hebben voordat je publiceert, en de interface kan niet controleren of een sample van jou is: wie op upload drukt, draagt de verantwoordelijkheid. Dus upload je eigen stem, of een stem waar je toestemming voor hebt, en behandel al het andere als een vraag voor een advocaat in plaats van een trucje in de workflow. De voorwaarden hechten er hetzelfde gewicht aan.
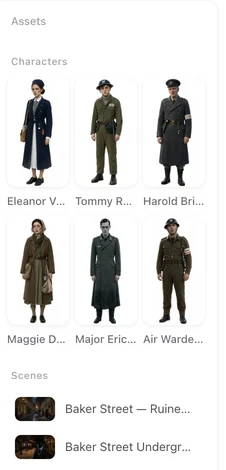
Waarom dezelfde stem een hele serie blijft houden
De stem is, net als het gezicht, een eigenschap van het personage in het project. Welke bron ook is gekoppeld, het wordt consistent gebruikt: hetzelfde personage spreekt met dezelfde stem in elk segment en elke aflevering — zowel aflevering één als aflevering twaalf — omdat de referentie met het personage meegaat naar elke opname waarin ze voorkomen. Niets in een opnameregel hoeft het te herhalen, en niets aan het opnieuw genereren van een enkel segment verandert het.
Twee details zijn het waard om te weten. Stemmen toewijzen is een bewuste stap, niet iets dat stilletjes met elk personage gebeurt, dus een personage zonder gekoppelde voorinstelling werkt verder op basis van de geschreven beschrijving. En het toewijzen ervan is een besluit per personage, niet per project: twee hoofdrolspelers kunnen de ene een voorinstelling hebben en de andere een beschreven stem, en de mix is in beide gevallen stabiel.
Dictie is een andere laag. Hoe een regel wordt gezegd — laag en stabiel, hees, nauwelijks hoorbaar — staat op de regel zelf geschreven als een dictienotitie, omdat een fluistering regie is in plaats van een tweede stem. Houd dictienotities bij de regel waar ze horen en laat de stem die van het personage blijven.
Eén project, één dialoogtaal
De taal die de cast spreekt, wordt per project ingesteld voordat het script wordt verwerkt, en het is een van de vijftien interfacetalen plus Kantonees als alleen-dialoogoptie. De regel wordt in die taal uitgevoerd terwijl de opname wordt gerenderd — beeld en spraak komen uit dezelfde generatie — dus er is geen nasynchronisatie en geen hertiming achteraf. Een script dat in de ene taal is geschreven, kan in een andere taal worden uitgevoerd; de taal van de pagina waarop je schrijft, de taal van het script en de taal die de cast spreekt, zijn drie afzonderlijke keuzes.
Waar mensen het meest over struikelen, zijn accenten. De bibliotheek is georganiseerd per taal — Chinees, Engels, Kantonees — en een match wordt gekozen op basis van geslacht, leeftijdsgroep en manier, niet op accentwoorden in een beschrijving; de beschrijving is de enige plek waar een accent vandaan komt. Dus een accent zet je in de stembeschrijving, en een andere taal stel je in bij de projectinstellingen. Als je beide op één plek vraagt, krijgen twee instructies ruzie over dezelfde zin.
Wat een stem nog wel verandert
Drie eerlijke gevallen. Een personage zonder voorinstelling: de geschreven beschrijving doet het werk, wat betekent dat twee takes iets anders kunnen klinken — koppel een voorinstelling als je elke keer dezelfde lezing wilt. Een regel die gewoon fout is: de stem repareert geen woordkeus; verander de regel (of de dictienotitie) en genereer opnieuw. En een afgewerkte clip: de instelling van het personage bepaalt toekomstige renders, terwijl een clip die al bestaat, wordt gewijzigd via Redub onder de speler, die de regels opnieuw doet in een gekozen stem zonder de eigen instelling van het personage te raken — de gids voor het veranderen van een stem legt het uit. Voor personages die wel te horen zijn maar nooit te zien zijn, houd ze gemarkeerd als buiten beeld en geef ze een stem: hun regels gebruiken die nog steeds, en hun gezicht wordt nooit gegenereerd.
Wat de stemdiscussies zeggen
Het thema stem, muziek en geluid is een van de meest gelabelde in het corpus, en het smallere label dialoog-en-lipsynchronisatie staat op 2,600 — met 520 berichten die overeenkomen met de trefwoorden voor klachten over lippen die niet matchen. De terugkerende opmerking in de reacties is niet de technologie; het is de uitvoering:
| Aantal op basis van regelovereenkomst | Berichten |
|---|---|
| Labels voor stem, muziek en geluid | 12,000 |
| Labels voor dialoog-en-lipsynchronisatie | 2,600 |
| Trefwoorden voor klachten over lipsynchronisatie | 520 |
Twee reacties uit het corpus zetten het goed neer. De eerste komt uit een discussie over waar AI-filmmaken nog moet groeien:
Stemacteren is de volgende grote hindernis die AI moet overwinnen.
De tweede is een reactie op een afgewerkte film — het beeld klopt, en de uitvoering is wat de betovering breekt:
Ziet er prachtig uit, maar de dialoog is vlak. Er zit een mechanisch ritme in dat het helemaal verpest. Geen intonatie.
De eerste reactie komt uit een discussie in r/Filmmakers; de tweede uit een remake-topic in r/aivideos. De methodenotitie beschrijft hoe de tellingen zijn verzameld.
Beperkingen: waar dit niet geldt
- Matchen en uploaden geven een personage een stem; ze regelen niet wie die stem mag gebruiken. Als je productie de stem van een specifieke acteur nodig heeft, is dat een licentiegesprek — de interface van de site kan niet controleren of een geüpload sample van jou is, dus de verantwoordelijkheid ligt bij de uploader.
- Accenten staan niet in de bibliotheek. Als het accent het belangrijkste is, schrijf het dan in de stembeschrijving en verwacht dat het model het net als elke andere aanwijzing interpreteert.
- Stemconsistentie zorgt niet voor het acteerwerk. Een vlakke voordracht is een regelprobleem — herschrijf de regel of de voordrachtnotitie in plaats van de stem opnieuw te matchen.
- De corpuscijfers zijn trefwoordregeltellingen over de collectie van 2026; ze laten zien waar de conversatie over gaat, geen ranglijst van resultaten.
Veelgestelde vragen
Blijft de stem van een personage hetzelfde tussen afleveringen door?
Ja, om dezelfde reden als het gezicht: een stem is op projectniveau aan het personage gekoppeld en gaat mee naar elk segment waarin dat personage spreekt — aflevering één net zo goed als aflevering twaalf.
Kan ik mijn eigen stem uploaden?
Ja. Upload een opname als stemreferentie van een personage en die wordt gebruikt voor elk segment waarin ze spreken; het is een blijvende keuze en latere matching overschrijft het niet.
Kan ik een stem wijzigen nadat de video is gemaakt?
De instelling van het personage bepaalt toekomstige renders. Voor een clip die al bestaat, is er Redub onder de speler, die de regels opnieuw inspreekt met de stem die je kiest — de eigen instelling van het personage blijft zoals die was.
Verandert de taal van de dialoog de stem?
Niet direct. De stembibliotheek is ingedeeld per taal, en de dialoogtaal van het project bepaalt in welke taal de regels worden geschreven en voorgedragen; Kantonees is beschikbaar als alleen-dialoog-optie.
De praktische uitleg staat in hoe personagestemmen werken — de drie modi, wat de stem wel en niet regelt — en hoofd-, bij- en stem-only personages gaat over de personages die je wel hoort maar nooit ziet. Het fix-one-shot antwoord gaat verder waar een geleverde voordracht aangepast moet worden.
Stem één keer casten
Upload een script, match of upload de stem van elk personage, en hoor een regel voorgedragen worden voordat je iets uitgeeft — spraak zit bij de videoprijs in, zonder aparte audiokosten.
Gratis aanmeldenSpraak zit bij de videoprijs in — er zijn geen aparte audiokosten. Tarieven staan op de prijzenpagina met dezelfde cijfers.
Prijzen·Gidsen·Voorbeelden·Alternatieven·Antwoorden·Ondersteuning·Privacy·Voorwaarden·Juridisch·Contact·Partnerprogramma·© 2026 SceneMixer