إعادة الإنتاج: كيف تُقرأ الحوارات والموسيقى من المقطع، وما الذي يصل إلى حلقتك

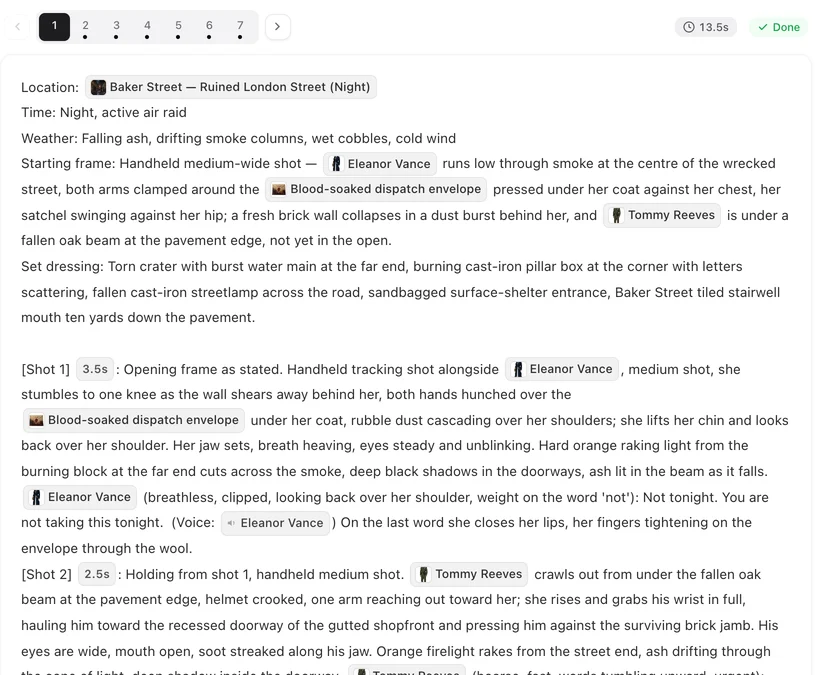
بعد القراءة، افتح الحلقة في الخطوة 3 واقرأ مخططها: كل كتلة مشهد تسرد أسطرها بصيغة «المتحدث: النص».
كيف تُسمع الأسطر
يعمل التعرف على الكلام على الصوت الخاص بكل لقطة. ما يُسمع يُسلم إلى واصف اللقطة كـ«هذه الكلمات قيلت هنا»؛ ثم يحدد الواصف هوية المتحدث من الوجوه ويكتب السطر في اللقطة. تُعالج الموسيقى الموجودة تحت الكلام؛ أما الصراخ فوق ضجيج الحشد، واللهجات الثقيلة، والأسطر الهادئة جدًا فهي الحالات التي يفشل فيها، وتُترك بدلًا من اختلاقها. تظهر الأسطر بعد ذلك في المخطط كما في السيناريو: اكتب الحوار بحيث يُلتقط.
لماذا النقل كما سُمع بدل التخمين
إذا تُرك النموذج البصري لنفسه وسُئل «ماذا قيل هنا؟»، فإنه يسمع أحيانًا ولا يسمع أحيانًا أخرى على نفس اللقطة، ويختلق أسطرًا معقولة عندما يكون غير متأكد. تثبيت الكلمات المعترف بها في الوصف يمنع كلا الأمرين؛ تُستخدم نفس الكلمات في كل مرة تُوصف فيها اللقطة.
الموسيقى
تسأل القراءة مرة واحدة ما إذا كان المقطع يحتوي على موسيقى وما نوعها. إذا كان كذلك، يحمل كل مقطع تولده ملخص موسيقى من سطر واحد يطابقها، بحيث تحتوي المقاطع المولدة على موسيقى بنفس الطابع؛ ولا يُستخدم المسار المصدر نفسه أبدًا. تُسجل الأصوات المحيطة لكنها لا تُنقل. من أين تأتي الموسيقى.
لغة الحوار
تُختار في شاشة الرفع، وتكون افتراضيًا بلغة واجهتك (الموقع الصيني دائمًا بالصينية)، وتُثبت بمجرد بدء القراءة. الأسطر المسموعة بلغة أخرى تُترجم إليها. لا يمكن تغييرها بعد ذلك لإعادة الإنتاج، ولهذا السبب لا تعرض الخطوة 1 القائمة المنسدلة. بعد القراءة.
عندما يُفقد سطر أو يكون خطأ
لا يمكن تحرير المخطط نفسه، وتنسخ لوحة المشاهد أسطره حرفيًا. أنشئ لوحة المشاهد، ثم افتح المقطع الذي ينتمي إليه السطر وأضفه أو صححه هناك مع تحديد المتحدث؛ السطر المنسوب إلى الشخص الخطأ يُصحح بالطريقة نفسها. التحرير مجاني. أنشئ لوحة المشاهد.
| في المقطع | في القراءة | في حلقتك |
|---|---|---|
| سطر منطوق واضح | يُنقل كما سُمع، ويُحدد المتحدث | سطر في المخطط |
| لا يتحدث أحد | تُعلَم اللقطة كصامتة | لا يوجد سطر |
| كلام غير واضح | يُترك | أضفه يدويًا في المقطع |
| الموسيقى | يُسجل طابعها | موسيقى بنفس الطابع في كل مقطع |
| الصوت المحيط | يُسجل | لا يُنقل؛ تكتب لوحة المشاهد صوتها الخاص |
الأسئلة الشائعة
لماذا يوجد سطر مفقود؟
لم يستطع المتعرف تمييزه. قارنه بمقطعك وأضفه في المقطع بمجرد وجود لوحة المشاهد.
هل تُستخدم الأصوات المصدر؟
لا. الأصوات تأتي من إعدادات أصوات طاقم الممثلين، كما في أي مشروع.
هل يمكن لإعادة الإنتاج أن تتحدث لغة مختلفة عن المصدر؟
نعم؛ اختر لغة الحوار في شاشة الرفع وستُترجم الأسطر أثناء القراءة.
هل تُعاد استخدام الموسيقى المصدر؟
لا. يُوصف طابعها وتولد المقاطع موسيقى خاصة بها.
لماذا لا يظهر سطر لصراخ الحشد؟
ضجيج المجموعة يُعامل كصوت خلفية، لا كحوار.
تم التحديث في 27 سبتمبر 2026
الأسعار·الأدلة·العينات·الدعم·الخصوصية·الشروط·معلومات قانونية·تواصل معنا·© 2026 SceneMixer