Remake: hoe gesproken zinnen en muziek uit de clip worden gelezen, en wat er in je aflevering terechtkomt

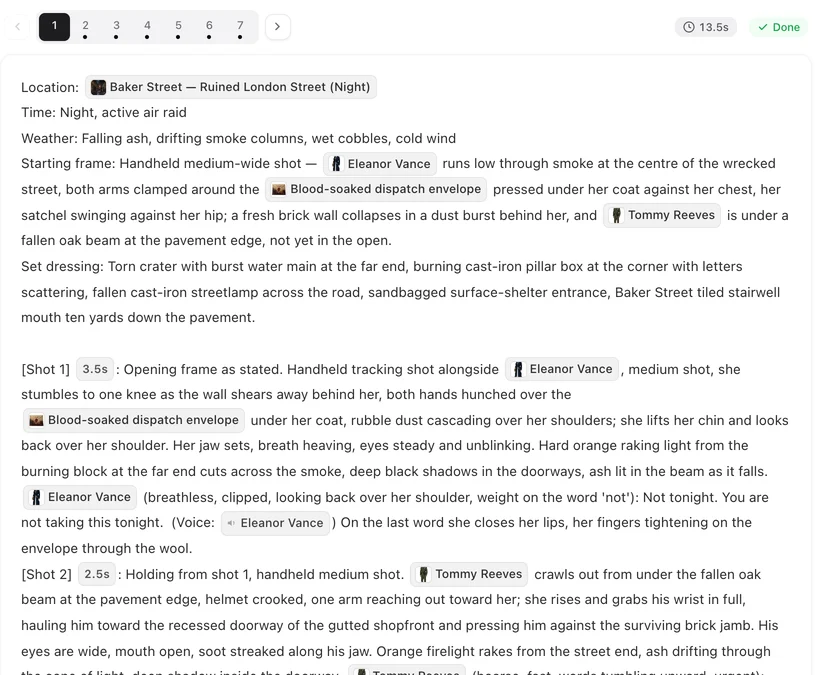
Na een analyse open je de aflevering in Stap 3 en lees je de opzet: elk sceneblok vermeldt de zinnen in de vorm spreker: zin.
Hoe zinnen worden gehoord
Spraakherkenning draait op de eigen audio van elke shot. Wat hij hoort, wordt aan de shotbeschrijving doorgegeven als ‘deze woorden werden hier gesproken’; de beschrijver noemt vervolgens de spreker aan de hand van de gezichten en schrijft de zin in de shot. Muziek onder spraak wordt verwerkt; geschreeuw boven een menigte, sterke accenten en zeer stille zinnen zijn plekken waar het faalt, en die worden weggelaten in plaats van verzonnen. Zinnen verschijnen daarna in de opzet zoals in een script: Schrijf dialoog zodat hij wordt opgepikt.
Waarom citeren in plaats van raden
Aan zichzelf overgelaten hoort een vision model soms wel en soms niet wat er in dezelfde shot gezegd wordt, en verzint het aannemelijke zinnen bij onzekerheid. Herkende woorden die in de beschrijving worden vastgezet, voorkomen beide; dezelfde woorden worden elke keer gebruikt als de shot wordt beschreven.
Muziek
De analyse controleert eenmaal of de clip muziek heeft en wat voor soort. Als dat zo is, krijgt elk segment dat je genereert een muziekomschrijving van één regel die daarbij past, zodat de gegenereerde segmenten muziek van hetzelfde karakter hebben; de bron-track zelf wordt nooit gebruikt. Omgevingsgeluid wordt genoteerd maar niet overgenomen. Waar de muziek vandaan komt.
Dialoogtaal
Gekozen op het uploadscherm, standaard ingesteld op je interfacetaal (de Chinese site is altijd Chinees), en vastgelegd zodra de analyse start. Zinnen die in een andere taal worden gehoord, worden ernaar vertaald. Die kan achteraf niet worden gewijzigd voor een remake, daarom biedt Stap 1 de vervolgkeuzelijst niet aan. Na de analyse.
Wanneer een zin is gemist of fout is
De opzet zelf kan niet worden bewerkt, en het storyboard neemt de zinnen woord voor woord over. Genereer het storyboard, open daarna het segment waar de zin thuishoort en voeg hem daar toe of corrigeer hem, met de spreker; een zin die aan de verkeerde persoon is toegewezen, corrigeer je op dezelfde manier. Bewerken is gratis. Genereer het storyboard.
| In de clip | In de analyse | In je aflevering |
|---|---|---|
| Een duidelijke gesproken zin | Geciteerd, spreker benoemd | Een zin in de opzet |
| Niemand spreekt | Shot gemarkeerd als stil | Geen zin |
| Onduidelijke spraak | Weggelaten | Voeg hem handmatig toe in het segment |
| Muziek | Karakter genoteerd | Muziek van hetzelfde karakter in elk segment |
| Omgevingsgeluid | Genoteerd | Niet overgenomen; het storyboard schrijft zijn eigen geluid |
FAQ
Waarom ontbreekt een zin?
De herkenner kon hem niet verstaan. Vergelijk het met je clip en voeg hem toe in het segment zodra het storyboard bestaat.
Worden de bronstemmen gebruikt?
Nee. Stemmen komen uit de spraakinstellingen van de cast, zoals in elk project.
Kan de remake een andere taal spreken dan de bron?
Ja; kies de dialoogtaal op het uploadscherm en de zinnen worden tijdens de analyse vertaald.
Wordt de bronmuziek hergebruikt?
Nee. Het karakter ervan wordt beschreven en de segmenten genereren hun eigen muziek.
Waarom krijgt een menigteschreeuw geen zin?
Groepsgeluid wordt behandeld als achtergrondgeluid, niet als dialoog.
Gehoord, geciteerd, geschreven
Wat er in de clip werd gezegd, is wat je aflevering zegt.
Bijgewerkt 27 september 2026
Prijzen·Gidsen·Voorbeelden·Ondersteuning·Privacy·Voorwaarden·Juridisch·Contact·© 2026 SceneMixer