리메이크: 클립에서 대사와 음악이 어떻게 읽히고, 내 에피소드에 어떻게 반영되나요

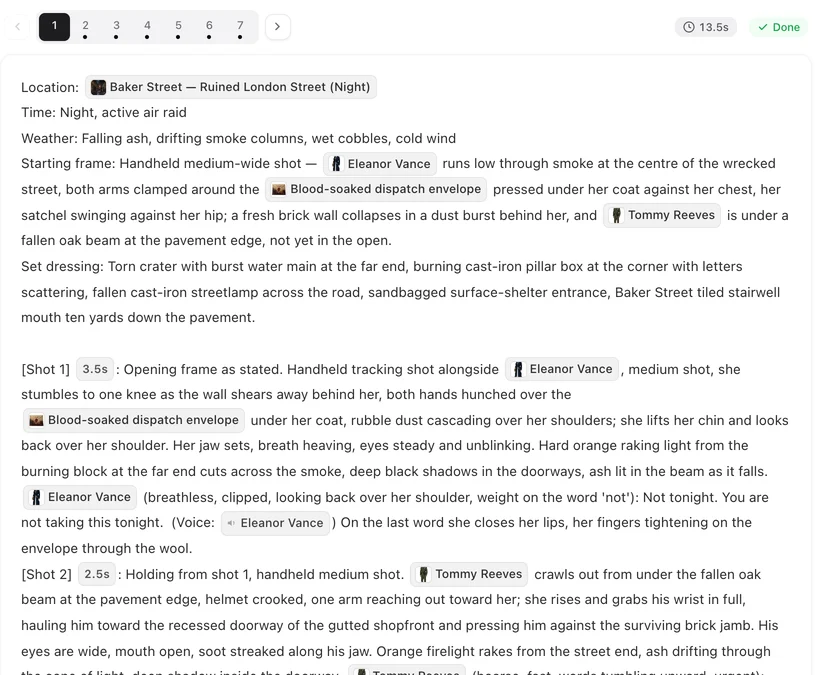
읽기가 끝나면 3단계에서 에피소드를 열고 아웃라인을 확인하세요. 각 장면 블록에는 '화자: 대사' 형식으로 대사가 나열됩니다.
대사가 들리는 방식
음성 인식은 각 숏의 오디오를 개별로 실행합니다. 인식된 내용은 '여기서 이 단어들이 말해졌다'는 형태로 숏 설명에 전달되고, 설명 모델은 얼굴을 보고 화자를 지정한 뒤 대사를 숏에 작성합니다. 대사 아래 깔린 음악은 처리되지만, 군중 속 고함, 심한 억양, 아주 작은 목소리의 대사는 인식에 실패하며 지어내는 대신 누락됩니다. 이후 대사는 대본처럼 아웃라인에 표시됩니다: 인식 잘 되게 대사 작성하기.
왜 추측하지 않고 인용하나요
비전 모델에 '여기서 무슨 말을 하나요?'라고 그대로 물으면 같은 숏에서도 들릴 때도 있고 안 들릴 때도 있으며, 불확실할 때 그럴듯한 대사를 지어내곤 합니다. 인식된 단어를 설명에 고정하면 이 두 문제를 막을 수 있고, 숏을 설명할 때마다 항상 같은 단어가 사용됩니다.
음악
읽기 과정에서 클립에 음악이 있는지, 어떤 종류인지 한 번 확인합니다. 음악이 있으면 생성하는 각 세그먼트에 그에 맞는 한 줄짜리 음악 브리프가 적용되어, 생성된 세그먼트에 같은 특징의 음악이 들어갑니다. 원본 트랙 자체는 절대 사용되지 않습니다. 환경음은 기록되지만 이어지지는 않습니다. 음악은 어디에서 오나요.
대사 언어
업로드 화면에서 선택하며 기본값은 인터페이스 언어입니다(중국 사이트는 항상 중국어). 읽기가 시작되면 고정됩니다. 다른 언어로 들린 대사는 해당 언어로 번역됩니다. 리메이크에서는 나중에 변경할 수 없기 때문에 1단계에서는 드롭다운을 제공하지 않습니다. 읽기 이후.
대사가 누락되거나 틀렸을 때
아웃라인 자체는 편집할 수 없으며, 스토리보드는 아웃라인의 대사를 그대로 복사합니다. 스토리보드를 생성한 뒤 해당 대사가 속한 세그먼트를 열어 화자와 함께 대사를 추가하거나 수정하세요. 화자가 잘못 지정된 경우도 같은 방식으로 고칩니다. 편집은 무료입니다. 스토리보드 생성하기.
| 클립에서 | 읽기에서 | 내 에피소드에서 |
|---|---|---|
| 선명하게 들리는 대사 | 인용되고 화자가 지정됨 | 아웃라인의 대사가 됨 |
| 아무도 말하지 않음 | 숏이 무음으로 표시됨 | 대사 없음 |
| 알아듣기 어려운 발화 | 누락됨 | 세그먼트에 직접 추가하세요 |
| 음악 | 특징이 기록됨 | 모든 세그먼트에 같은 특징의 음악이 들어감 |
| 환경음 | 기록됨 | 이어지지 않음; 스토리보드가 자체적으로 작성함 |
자주 묻는 질문
대사가 왜 누락되나요?
인식기가 알아듣지 못했기 때문입니다. 스토리보드가 생성된 후 클립과 비교해 세그먼트에 직접 추가하세요.
원본 목소리를 사용하나요?
아니요. 다른 프로젝트와 마찬가지로 캐스트의 음성 설정에서 목소리를 가져옵니다.
리메이크가 원본과 다른 언어로 말할 수 있나요?
네. 업로드 화면에서 대사 언어를 고르면 읽기 단계에서 대사가 번역됩니다.
원본 음악을 재사용하나요?
아니요. 음악의 특징을 설명하고 세그먼트가 자체 음악을 생성합니다.
군중의 함성에 왜 대사가 없나요?
집단 소음은 대사가 아닌 배경 소리로 처리됩니다.
2026년 9월 27일 업데이트