Refilmagem: como falas e música são lidas do clipe e o que vai para o seu episódio

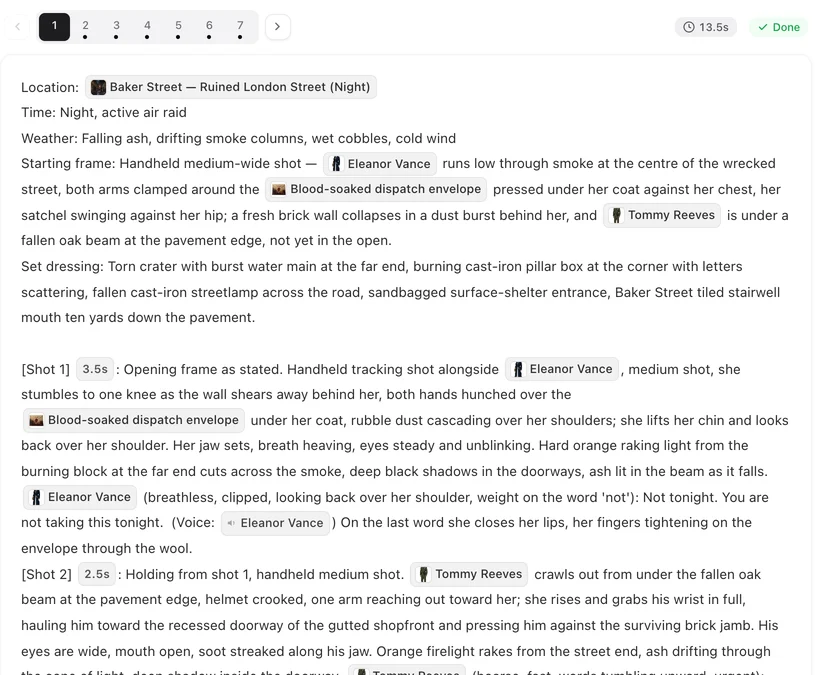
Depois da leitura, abra o episódio na Etapa 3 e leia o esboço: cada bloco de cena lista suas falas no formato “falante: fala”.
Como as falas são ouvidas
O reconhecimento de fala roda no áudio de cada tomada. O que ele ouve é passado para a descrição da tomada como “essas palavras foram ditas aqui”; o descritor então identifica quem está falando pelos rostos e escreve a fala na tomada. Música por baixo da fala é tratada corretamente; gritos no meio de multidão, sotaques carregados e falas muito baixas são os casos em que ele falha, e nesses casos as falas são omitidas em vez de inventadas. As falas aparecem no esboço como num roteiro: Escreva Diálogos que Sejam Capturados.
Por que citar, e não adivinhar
Por conta própria, um modelo de visão perguntado “o que foi dito aqui” às vezes ouve e às vezes não, na mesma tomada, e inventa falas plausíveis quando está inseguro. Palavras reconhecidas fixadas na descrição evitam os dois problemas; as mesmas palavras são usadas toda vez que a tomada é descrita.
Música
A leitura verifica uma vez se o clipe tem música e de que tipo. Se tiver, cada segmento gerado carrega um briefing de música de uma linha correspondente, para que os segmentos tenham música do mesmo estilo; a faixa original nunca é usada. Som ambiente é anotado, mas não levado adiante. De Onde Vem a Música.
Idioma do diálogo
Escolhido na tela de envio, com padrão no idioma da sua interface (o site chinês é sempre em chinês), e fixo assim que a leitura começa. Falas ouvidas em outro idioma são traduzidas para ele. Não é possível mudar isso depois em uma refilmagem, por isso a Etapa 1 não mostra esse menu. Depois da Leitura.
Quando uma fala foi perdida ou está errada
O esboço em si não pode ser editado, e o storyboard copia suas falas palavra por palavra. Gere o storyboard, depois abra o segmento onde a fala pertence e adicione ou corrija ali, com o falante; uma fala atribuída à pessoa errada é corrigida da mesma forma. Editar é gratuito. Gerar o Storyboard.
| No clipe | Na leitura | No seu episódio |
|---|---|---|
| Fala clara | Citada, falante identificado | Uma fala no esboço |
| Ninguém fala | Tomada marcada como silenciosa | Sem fala |
| Fala pouco clara | Omitida | Adicione manualmente no segmento |
| Música | Estilo anotado | Música do mesmo estilo em cada segmento |
| Som ambiente | Anotado | Não levado adiante; o storyboard cria o seu próprio |
Perguntas frequentes
Por que uma fala está faltando?
O reconhecedor não conseguiu entendê-la. Compare com o seu clipe e adicione-a no segmento depois que o storyboard existir.
As vozes originais são usadas?
Não. As vozes vêm das configurações de voz do elenco, como em qualquer projeto.
A refilmagem pode falar um idioma diferente do original?
Sim; escolha o idioma do diálogo na tela de envio e as falas serão traduzidas na leitura.
A música original é reutilizada?
Não. Seu estilo é descrito e os segmentos geram a sua própria.
Por que um grito de multidão não vira fala?
Ruído de grupo é tratado como som de fundo, não como diálogo.
Atualizado em 27 de setembro de 2026
Preços·Guias·Amostras·Suporte·Privacidade·Termos·Aviso legal·Contato·© 2026 SceneMixer