Remake: Cara Dialog dan Musik Dibaca dari Klip, dan Hasilnya di Episode Anda

Setelah pembacaan selesai, buka episode di Langkah 3 dan baca kerangkanya: setiap blok adegan mencantumkan dialog dalam format pembicara:isi.
Cara dialog didengar
Pengenalan ucapan berjalan pada audio setiap bidak sendiri. Apa yang didengar diberikan ke deskripsi bidak sebagai ‘kata-kata ini diucapkan di sini’; pendeskripsi kemudian menentukan pembicara dari wajah yang ada dan menuliskan dialog ke dalam bidak. Musik di bawah ucapan sudah ditangani; teriakan di tengah kerumunan, aksen kental, dan dialog yang sangat pelan adalah kondisi yang membuatnya gagal, dan bagian itu dibiarkan kosong alih-alih dibuat-buat. Dialog kemudian muncul di kerangka seperti naskah: Tulis Dialog Agar Terdeteksi.
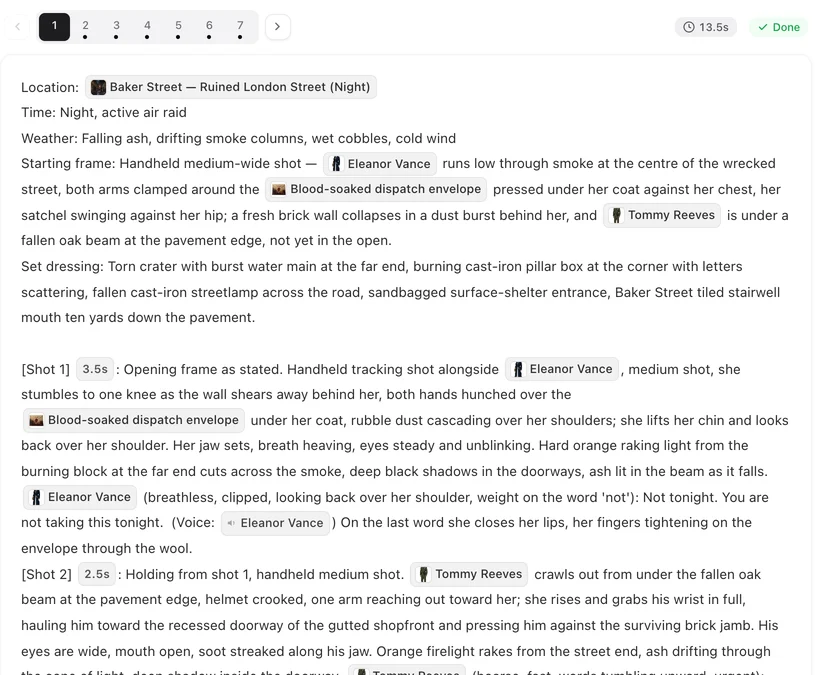
Mengapa dikutip, bukan ditebak
Jika dibiarkan sendiri, model visi yang ditanya ‘apa yang diucapkan di sini’ terkadang bisa mendengar dan terkadang tidak, pada bidak yang sama, dan akan membuat dialog yang terdengar masuk akal saat ragu. Kata-kata yang dikenali yang disematkan ke deskripsi menghentikan kedua masalah itu; kata yang sama digunakan setiap kali bidak dideskripsikan.
Musik
Pembacaan menanyakan sekali apakah klip memiliki musik dan jenisnya apa. Jika ada, setiap segmen yang Anda hasilkan membawa ringkasan musik satu baris yang cocok, sehingga segmen yang dihasilkan memiliki musik dengan karakter yang sama; trek sumber itu sendiri tidak pernah digunakan. Suara sekitar dicatat tetapi tidak dibawa ke hasil. Asal Musik yang Digunakan.
Bahasa dialog
Dipilih di layar unggah, default ke bahasa antarmuka Anda (situs Tiongkok selalu menggunakan bahasa Tiongkok), dan terkunci setelah pembacaan dimulai. Dialog yang terdengar dalam bahasa lain akan diterjemahkan ke bahasa ini. Bahasa tidak dapat diubah setelahnya untuk remake, itulah sebabnya Langkah 1 tidak menyediakan menu pilihan. Setelah Pembacaan.
Saat dialog terlewat atau salah
Kerangka itu sendiri tidak dapat diedit, dan storyboard menyalin dialognya kata demi kata. Hasilkan storyboard, lalu buka segmen tempat dialog itu seharusnya berada dan tambahkan atau perbaiki di sana, beserta pembicaranya; dialog yang salah orang diperbaiki dengan cara yang sama. Pengeditan tidak memerlukan biaya. Hasilkan Storyboard.
| Di klip | Di hasil pembacaan | Di episode Anda |
|---|---|---|
| Dialog yang jelas | Dikutip, pembicara dinamai | Dialog di kerangka |
| Tidak ada yang bicara | Bidak ditandai sunyi | Tidak ada dialog |
| Ucapan tidak jelas | Dibiarkan kosong | Tambahkan secara manual di segmen |
| Musik | Karakter dicatat | Musik berkarakter sama di setiap segmen |
| Suara sekitar | Dicatat | Tidak dibawa; storyboard membuat suaranya sendiri |
FAQ
Mengapa ada dialog yang hilang?
Pengenal tidak dapat menangkapnya. Bandingkan dengan klip Anda dan tambahkan di segmen setelah storyboard dibuat.
Apakah suara sumber digunakan?
Tidak. Suara berasal dari pengaturan suara pemeran, seperti pada proyek mana pun.
Bisakah remake menggunakan bahasa yang berbeda dari sumber?
Bisa; pilih bahasa dialog di layar unggah dan dialog akan diterjemahkan saat pembacaan.
Apakah musik sumber digunakan kembali?
Tidak. Karakternya dideskripsikan dan segmen menghasilkan musiknya sendiri.
Mengapa teriakan kerumunan tidak ada dialognya?
Suara kelompok dianggap sebagai suara latar, bukan dialog.
Didengar, dikutip, ditulis
Apa yang diucapkan di klip adalah apa yang diucapkan episode Anda.
Diperbarui 27 September 2026
Harga·Panduan·Contoh·Dukungan·Privasi·Ketentuan·Informasi hukum·Hubungi kami·© 2026 SceneMixer