Переробка: як з кліпу зчитуються репліки та музика і що потрапляє у вашу серію

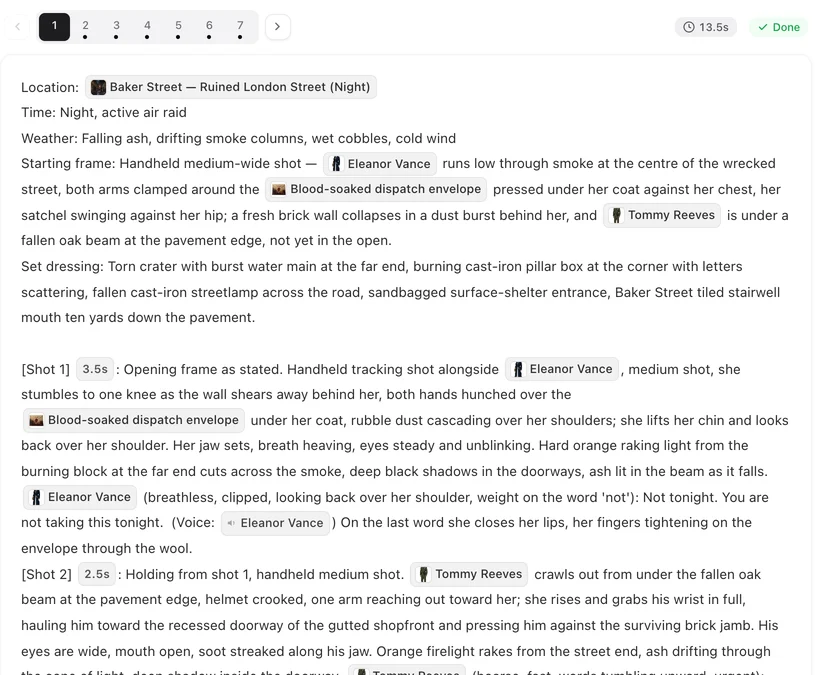
Після зчитування відкрийте серію на Кроці 3 і перегляньте її структуру: у кожному блоці сцени репліки подані у форматі «мовець: репліка».
Як зчитуються репліки
Розпізнавання мовлення запускається для аудіо кожного кадру окремо. Почуте передається описувачу кадру як «тут були сказані такі слова»; після цього описувач визначає мовця за обличчями і вписує репліку в кадр. Музику під мовленням система обробляє коректно; крики крізь натовп, сильні акценти та дуже тихі репліки — це ситуації, де розпізнавання дає збій, і такі фрагменти пропускають, а не вигадують. Потім репліки з’являються в структурі, як у сценарії: Пишіть діалоги так, щоб їх було розпізнано.
Чому цитувати, а не вгадувати
Якщо покластися лише на візуальну модель і запитати її «що тут сказано», вона на тому самому кадрі то почує репліку, то ні, а в разі невпевненості вигадає правдоподібні фрази. Закріплення розпізнаних слів в описі запобігає обом проблемам: щоразу під час опису кадру використовуються ті самі слова.
Музика
Під час зчитування один раз перевіряється, чи є в кліпі музика і якого вона типу. Якщо є, кожен згенерований вами сегмент міститиме однорядковий опис музики, що відповідає оригіналу, — тому в згенерованих сегментах буде музика схожого характеру; сам вихідний трек ніколи не використовується. Фонові шуми зазначаються, але не переносяться. Звідки береться музика.
Мова діалогів
Обирається на екрані завантаження, за замовчуванням відповідає мові інтерфейсу (китайська версія сайту завжди залишається китайською), і фіксується після початку зчитування. Репліки, почуті іншою мовою, перекладаються обраною мовою. Для переробки її не можна змінити після запуску, тому на Кроці 1 відповідний випадний список відсутній. Після зчитування.
Якщо репліку пропущено або розпізнано неправильно
Саму структуру серії редагувати не можна, і сторіборд копіює з неї репліки слово в слово. Згенеруйте сторіборд, потім відкрийте сегмент, де має бути потрібна репліка, і додайте або виправте її там разом із зазначенням мовця; репліку, приписану не тій людині, виправляють так само. Редагування безплатне. Згенерувати сторіборд.
| У кліпі | Під час зчитування | У вашій серії |
|---|---|---|
| Чітка вимовлена репліка | Цитується, мовець визначений | Репліка в структурі серії |
| Ніхто не говорить | Кадр позначено як тихий | Репліки немає |
| Невиразне мовлення | Пропущено | Додайте репліку в сегмент вручну |
| Музика | Характер зазначено | Музика схожого характеру в кожному сегменті |
| Фонові шуми | Зазначено | Не переносяться; сторіборд створює власні |
Поширені запитання
Чому репліка відсутня?
Розпізнавач не зміг її розібрати. Порівняйте зі своїм кліпом і додайте репліку в сегмент після створення сторіборду.
Чи використовуються оригінальні голоси?
Ні. Голоси беруться з налаштувань голосів акторського складу, як і в будь-якому проєкті.
Чи може переробка бути озвучена іншою мовою, ніж оригінал?
Так; оберіть мову діалогів на екрані завантаження, і репліки будуть перекладені під час зчитування.
Чи повторно використовується оригінальна музика?
Ні. Описується її характер, і сегменти генерують власну музику.
Чому крик натовпу не отримує окремої репліки?
Груповий шум вважається фоновим звуком, а не діалогом.
Почуто, процитовано, записано
Те, що було сказано в кліпі, — те й звучатиме у вашій серії.
Оновлено 27 вересня 2026 року
Ціни·Посібники·Зразки·Підтримка·Конфіденційність·Умови·Правова інформація·Контакти·© 2026 SceneMixer