Remake: cómo se leen los diálogos y la música del clip, y qué termina en tu episodio

Después de la lectura, abre el episodio en el Paso 3 y revisa su esquema: cada bloque de escena lista sus frases en formato «personaje: frase».
Cómo se escuchan las frases
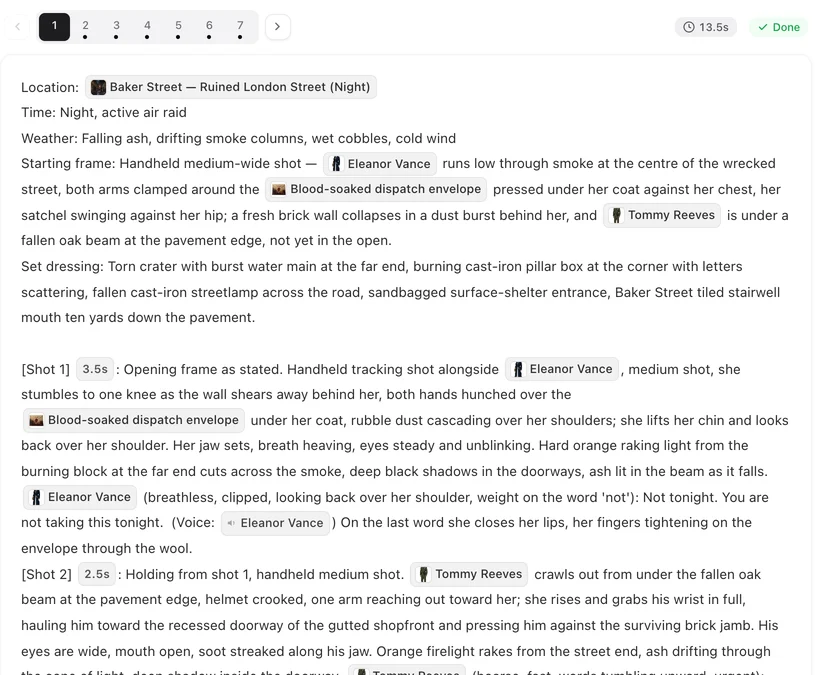
El reconocimiento de voz se ejecuta sobre el audio de cada plano. Lo que detecta se pasa a la descripción del plano como «aquí se dijeron estas palabras»; después, el descriptor identifica al hablante por las caras y escribe la frase en el plano. La música bajo la voz se gestiona bien; los gritos entre una multitud, los acentos muy marcados y las frases muy bajas son los casos en que falla, y esas se omiten en lugar de inventarse. Las frases aparecen luego en el esquema como en un guion: Escribe los diálogos para que se detecten.
Por qué citar, no adivinar
Si se deja solo, un modelo de visión al que se le pregunte «qué se dice aquí» a veces oye y a veces no, en el mismo plano, e inventa frases creíbles cuando no está seguro. Las palabras reconocidas fijadas en la descripción evitan ambos problemas: se usan las mismas palabras cada vez que se describe el plano.
Música
La lectura pregunta una vez si el clip tiene música y de qué tipo. Si la hay, cada segmento que generes lleva una indicación musical de una línea que coincide con ella, para que los segmentos generados tengan música del mismo estilo; la pista original nunca se usa. El sonido ambiental se anota pero no se traslada. De dónde viene la música.
Idioma del diálogo
Se elige en la pantalla de subida, por defecto el idioma de tu interfaz (el sitio chino siempre está en chino), y se fija cuando empieza la lectura. Las frases oídas en otro idioma se traducen a él. No se puede cambiar después en un remake, por eso el Paso 1 no muestra el desplegable. Después de la lectura.
Cuando falta una frase o es incorrecta
El esquema en sí no se puede editar, y el storyboard copia sus frases palabra por palabra. Genera el storyboard, luego abre el segmento al que pertenece la frase y añádela o corrígela allí, con su hablante; una frase asignada a la persona equivocada se corrige de la misma forma. Editar es gratis. Generar el storyboard.
| En el clip | En la lectura | En tu episodio |
|---|---|---|
| Una frase hablada clara | Citada, hablante identificado | Una frase en el esquema |
| Nadie habla | Plano marcado como silencioso | Sin frase |
| Habla poco clara | Se omite | Añádela a mano en el segmento |
| Música | Estilo anotado | Música del mismo estilo en cada segmento |
| Sonido ambiental | Anotado | No se traslada; el storyboard crea el suyo propio |
Preguntas frecuentes
¿Por qué falta una frase?
El reconocedor no pudo entenderla. Compárala con tu clip y añádela en el segmento cuando exista el storyboard.
¿Se usan las voces originales?
No. Las voces vienen de la configuración de voz del reparto, como en cualquier proyecto.
¿Puede el remake hablar en un idioma distinto al del original?
Sí; elige el idioma del diálogo en la pantalla de subida y las frases se traducen durante la lectura.
¿Se reutiliza la música original?
No. Se describe su estilo y los segmentos generan la suya propia.
¿Por qué un grito de multitud no tiene frase?
El ruido de grupo se trata como sonido de fondo, no como diálogo.
Actualizado el 27 de septiembre de 2026
Precios·Guías·Ejemplos·Soporte·Privacidad·Términos·Aviso legal·Contacto·© 2026 SceneMixer