Hoe personagestemmen werken

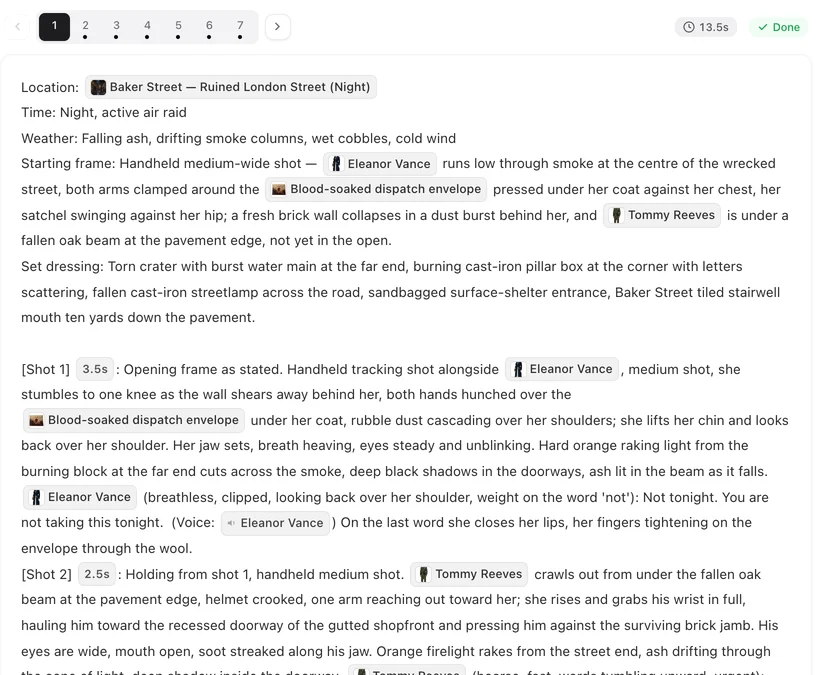
Stembeschrijvingen staan in het personagepaneel van elk project. Open een voorbeeld, klik op een personage, en de stemregel staat onder de uiterlijkbeschrijving.
Modus 1 — een stem in woorden (de standaard)
Bij het script krijgt elk personage een korte stembeschrijving, net zoals ze een uiterlijk krijgen. Die regel gaat mee in de videoprompt en het model voert hem uit. Er is geen voorbeeldbestand gekoppeld; er wordt niets van tevoren gegenereerd.
Dit is de standaard omdat het gratis is, direct werkt, en voor de meeste personages genoeg is. De prijs is consistentie: twee opnames van hetzelfde personage kunnen net iets anders klinken.
Modus 2 — gekoppeld aan een preset die je kunt horen
Open een personage en vraag een stemmatch. Een korte, gratis scan leest de beschrijving en kiest een stem uit de ingebouwde bibliotheek, bij voorkeur eentje die de juiste taal spreekt. Je krijgt een voorbeeld om af te spelen en een kiezer om een andere stem te selecteren als de match niet goed is.
Zodra de stem is gekoppeld, wordt het voorbeeld een audioreferentie voor elke opname waarin dat personage spreekt. Daardoor blijft de stem hetzelfde in de hele aflevering.
De bibliotheek is een vaste set systeemstemmen met een vooraf gerenderd voorbeeld per stem, dus matchen is gratis om te proberen en gratis om te wijzigen.
Modus 3 — zelf uploaden
Je kunt een fragment uploaden en dat als stem van het personage gebruiken. Het wordt ingekort tot een korte referentie en op dezelfde manier gebruikt als een gematchte preset. Een geüploade stem is een vaste keuze: latere matchscans overschrijven hem niet. Bestanden uploaden is een lidfunctie — de eerste twee modi zijn voor iedereen gratis.
Upload alleen een stem die je mag gebruiken. Een opname van een echte persoon is van die persoon, en het platform helpt je niet als je die zonder toestemming gebruikt.
Wat de stem wel en niet bepaalt
De stem bepaalt klankkleur en voordracht. Hij bepaalt niet wat er wordt gezegd — de regels komen uit het storyboard en worden woord voor woord uitgesproken. Hij geldt ook niet voor vertelling: regels die als buiten beeld of voice-over zijn gemarkeerd, worden als off-screen audio verwerkt, en de mensen in beeld houden hun mond dicht.
Als een opname geen dialoog heeft, wordt er geen stem gebruikt — wat je hoort is de omgevingstrack die voor die opname is ingesteld.
Van gedachten veranderen
Opnieuw matchen, een andere preset kiezen, of terugkeren naar een tekstbeschrijving is allemaal gratis en werkt bij de volgende opname die je genereert. Segmenten die je al hebt opgenomen, houden de stem waarmee ze zijn opgenomen; regenereer een segment als je de nieuwe stem erin wilt hebben.
| Modus | Kosten | Consistentie |
|---|---|---|
| Beschrijving in woorden | Gratis, automatisch | Goed, varieert iets per opname |
| Gematchte preset | Gratis om te matchen en te wijzigen | Blijft hetzelfde in de hele aflevering |
| Eigen upload | Lidfunctie | Blijft hetzelfde; wordt niet overschreven door hermatchen |
Veelgestelde vragen
Moet ik stemmen kiezen voordat ik video genereer?
Nee. Zonder gematchte stem wordt de beschrijving direct uitgevoerd, en dat is de standaard voor elk project.
Kan ik een stem beluisteren voordat ik hem kies?
Ja — elke preset in de bibliotheek heeft een voorbeeld dat je in de kiezer kunt afspelen.
Kost het matchen van een stem credits?
Nee. De matchscan is gratis, en van gedachten veranderen ook.
Wordt de stem gebruikt voor vertelling en innerlijke monoloog?
Die regels worden als off-screen audio behandeld: je hoort ze, maar de mensen op beeld bewegen hun lippen niet.
Kan ik de stem van een specifiek persoon klonen?
Leden kunnen een fragment uploaden dat ze mogen gebruiken. We bieden geen klonen van een bekende persoon aan, en het uploaden van andermans stem zonder toestemming is niet toegestaan.
Hoor het verschil
Open een personage, match een stem en speel het voorbeeld af voordat je iets opneemt.
Bijgewerkt 21 september 2026
Prijzen·Gidsen·Voorbeelden·Ondersteuning·Privacy·Voorwaarden·Juridisch·Contact·© 2026 SceneMixer