解答 · 歷史
如何為歷史題材 AI 影片建立鏡頭清單?
更新於 October 31, 2026

為什麼清單要先於畫面
這個方法最清楚的一段說明,來自一位創作者,他做了一個中世紀村莊裡的第一人稱一日。在還沒有任何片段之前,每個鏡頭都已經是紙上的一列:
如果弧線在鏡頭清單上讀不出來,在螢幕上也讀不出來。
鏡頭清單是調整節奏、鏡頭流動和連戲成本最低的地方。在紙上你就能看出連續三個遠景會讓節奏變慢、市集那場戲沒有建立鏡頭、黎明離開的角色回來時背包卻變了。這些一旦渲染出來,每一個都得重拍。歷史題材讓賭注更高,因為觀眾帶著知識來看,而同一個專案底下的回覆就顯示了細節出錯時會發生什麼事:
身為對歷史有研究的人,我只能說:這跟當年的時代毫無關係。
每一列放什麼
一列可用的內容,欄位和攝製團隊需要的一樣:在哪裡、什麼時候,發生什麼事,如何取景、鏡頭動不動,誰說話、怎麼說,以及聽到什麼。在 SceneMixer,分鏡腳本本身就是這份清單。每個片段開頭都有一個標頭,固定地點、時間和天氣;其下每個編號鏡頭都帶有它的秒數、取景、動作、附語氣提示的台詞,以及聲音。你可以自己寫好清單貼進去,也可以讓系統讀取劇本後修改它產生的清單——無論哪種,編輯分鏡腳本文字都是免費的,影片只對你渲染的片段計費。
| 欄位 | 範例列(黎明的港口) |
|---|---|
| 地點與時間 | 石砌碼頭,晨光初現,海霧 |
| 動作 | 一名書記在商船卸下雙耳瓶時逐一清點 |
| 取景與運鏡 | 遠景,緩慢推向書記 |
| 台詞 | 書記低聲說:十二個。他們寫的是十四個。 |
| 聲音 | 海鷗、繩索嘎吱聲、槳劃過水面 |
每個鏡頭只放一個動作,並給它發生的時間。一列若寫著書記清點、爭論、怒氣沖沖地離開,那就是三列。
把時代感放進只畫一次的內容
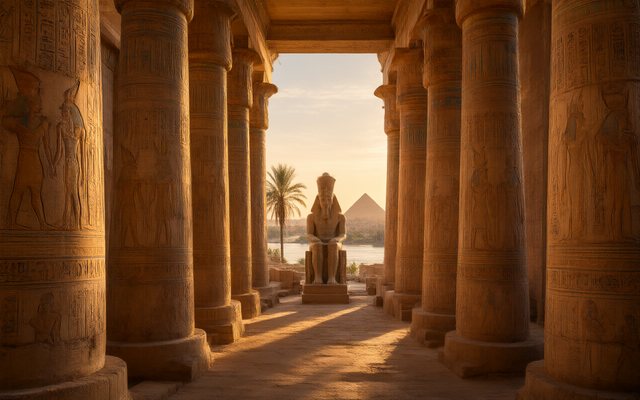
準確性存在於地點、服裝和物件裡,而這些正是 SceneMixer 只畫一次、重複使用的東西。在第 1 步設定世界——場景風格如 Ancient Egypt、Greco-Roman、Medieval Castle、Joseon Korea、Viking Fjord 或 WWII Front,並搭配相應的服裝風格——然後把細節寫進每一段描述:一盞燈的形狀、一件束腰外衣的剪裁、一只杯子的材質。寫進場景或道具設定圖的細節,在每個用到它的鏡頭裡呈現都一樣;在單一鏡頭文字中臨時發揮的細節,則每次都是一場賭博。
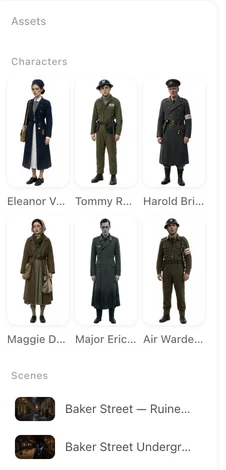
唯一明確的限制是人物。真實的歷史人物無法描繪,所以歷史影片要透過虛構的人物來講:碼頭上的書記、隊伍裡的士兵、人群中的孩子。最強的歷史小說也是這麼運作的——時代是真的,我們透過它來看的眼睛是編出來的。
Vlog 版本:對我們說話的嚮導
一種受歡迎的變體是歷史 vlog:讓現代的旁白者被丟進過去,一邊對鏡頭說話,一邊讓城市在他們周圍運轉。語料庫中有這類貼文自成一群——有 68 篇貼文在問如何做一支設定在古城的作品。結構上它是同一份清單,多了一個對著鏡頭說話的角色。把他們的台詞寫成對鏡頭的對白,讓他們待在畫面前景,並讓背景承載時代感。地點和人群仍需要具體;生動的旁白者身後若是含糊的市集,那仍是個含糊的市集。
解讀觀眾反應
歷史影片會招來一種特別的回覆:會去查證的觀眾。在 r/generativeAI 一部五分鐘歷史影片底下,真正重要的讚美是關於某個細節是對的:
至少登陸艇弄對了,就是普通的划艇。
這就是寫作的標準。整體的故事改編是對話的一大部分——有 7,300 篇貼文帶有該標籤——但歷史討論串才是一個錯誤物件就能決定留言區風向的地方。
限制:這個方法解決不了的事
- 鏡頭清單規劃的是要拍什麼;它不會替你做研究。時代細節仍需對照你信任的資料來源查證。
- 真實的歷史人物及其可辨識的重現,一律拒絕。依賴特定人物面孔的紀錄片用途,不在這裡能做的範圍內。
- 畫面上的地圖、日期和字幕要在剪輯器中加入;生成的影片無法穩定地拼出文字。
- 貼文數字是依規則從單一期間估算的近似值,並不衡量歷史影片究竟有多少。
常見問題
我可以貼上自己的鏡頭清單嗎?
可以。把它寫成劇本,或在劇本讀取後編輯分鏡腳本。每個鏡頭都保留其秒數、取景、動作、台詞和聲音,編輯文字不用花任何費用。
如何讓時代看起來準確?
在第 1 步選擇場景和服裝風格,然後把具體細節寫進場景、服裝和道具的描述中,它們只畫一次,並在每個鏡頭重複使用。
歷史人物可以出現在影片中嗎?
不行。真實的歷史人物無法描繪;請透過虛構的見證者與參與者來講述故事。
如何製作帶旁白者的歷史 vlog?
讓旁白者成為在前景對鏡頭說話的角色,並讓後方具體的地點與人群來承載時代感。
兩份指南涵蓋這門技藝:如何寫好一個鏡頭與製作歷史劇;鏡頭清單產生器展示由系統讀取劇本後清單的樣子,而關於撰寫運鏡的解答則談取景那一欄。數字依據方法說明。