Antworten · Stimmen
Wie mache ich ein Video mit KI-Stimme?
Aktualisiert 15. November 2026

Warum die Stimme am ehesten verrät, dass es KI ist
Frag Zuschauer, woran sie KI-Videos heute erkennen, und die Antwort hat sich von den Händen zum Ton verlagert. Unter einem Thread in r/aivideo darüber, KI-Videos im Jahr 2026 zu erkennen, brachte die oberste Antwort es in einem Satz auf den Punkt:
Das größte Verräterzeichen sind aber immer die Stimmen.
Das Publikum von KI-Dramen drückt es nachsichtiger aus, was genauso nützlich ist. Ein Zuschauer, der die Serien aufzählte, die er gesehen hatte, gestand:
manchmal stimmen Wörter und Stimmen nicht, aber das fällt über die Gesamtwirkung und die Handlung leicht nicht auf
Beides stimmt: Eine gute Geschichte trägt eine schwache Stimme, und eine starke Stimme lässt eine gute Geschichte echt wirken. Stimme ist eines der größten Themen im Community-Korpus, etwa 12.000 Beiträge, und allein Beschwerden über Lippen, die nicht zu den Worten passen, kommen auf etwa 520.
Stimme und Bild in einem Durchgang
Der übliche Weg, ein sprechendes KI-Video zu machen, besteht aus drei Werkzeugen: einen stummen Clip generieren, anderswo eine Tonspur erzeugen und dann darum kämpfen, dass der Mund zum Ton passt. Die Videomodelle auf SceneMixer erzeugen stattdessen Ton und Bild in einem Durchgang, sodass ein Segment schon mit seinem Klang herauskommt – die Zeile, der Raumton und die Lippen, die sie sprechen. Dadurch entfällt das Abgleichproblem, und es ändert sich, was eine „Stimmeinstellung“ ist: Du wählst, welche Stimme eine Figur hat, und die Betonung kommt aus dem Storyboard.
Gib jeder Figur einmal eine Stimme
Die Stimme einer Figur kommt aus einer von zwei Quellen. Eine passende Voreinstellung wird aus einer Bibliothek gesampelter Systemstimmen gewählt, jede mit einer kurzen Hörprobe; das Zuordnen ist ein kostenloser Modellaufruf und verbraucht keine Credits. Oder du lädst im bezahlten Tarif Audio für eine Figur hoch, und das wird ihre Referenz für jedes Segment, in dem sie spricht. Stimmen werden nicht mehr aus einer Liste von Adjektiven entworfen, denn eine aus Worten gebaute Stimme driftet zwischen den Takes genauso weg wie ein Gesicht, das nur in Worten beschrieben ist.
Welche Stimme an einer Figur hängt, wird auf Projektebene festgelegt und wandert in jedes Segment, in dem sie spricht. Die Stimme bleibt so über alle Episoden gleich, aus demselben Grund wie das Gesicht. SceneMixer klont eine Stimme nur aus dem, was du verwenden darfst: dem nachvertonten Clip (Redubs Originalstimme) oder einer Aufnahme, die du mit dem Nutzungsrecht hochlädst.
Die Betonung mit Worten steuern
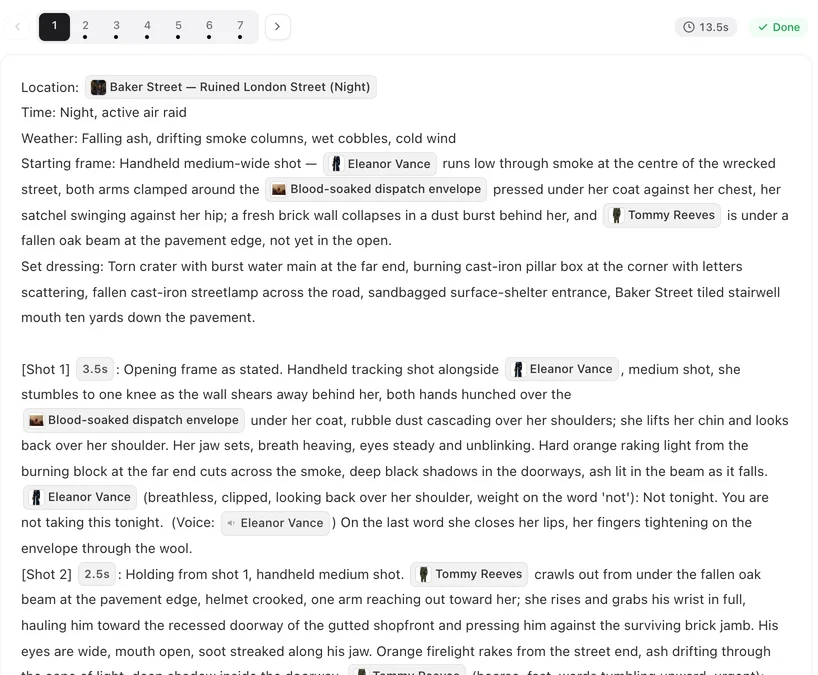
Die Darbietung wird über die geschriebene Notiz vor jeder Zeile im Storyboard gesteuert – atemlos, geflüstert, flach vor Wut –, nicht über einen Wellenform-Editor. Wenn eine Lesart nicht stimmt, ändere die Notiz und generiere das Segment neu. Deshalb heißt eine Zeile zu ändern auch, ihr Segment neu zu generieren, statt eine Audiospur neu zu schneiden: Stimme und Bild sind ein Take.
Bei der Sprache ist es genauso. Die Dialogsprache wird in Schritt 1 gewählt, und die Zeilen werden von Anfang an darin geschrieben, statt nachträglich synchronisiert zu werden; 15 Sprachen stehen zur Verfügung, und die Besetzungen auf der Seite sprachen 11 davon im Zeitraum von die 30 Tage bis zum 6. November 2026.
Eine Stimme nachträglich korrigieren
Wenn ein fertiger Clip das richtige Bild, aber die falsche Stimme hat, musst du ihn nicht neu generieren. Mit Redub wählst du für die Zeilen einer Figur in diesem Clip eine andere Stimme aus der Bibliothek, hörst vorab rein und vertonst in eine neue Version, ohne die Worte zu ändern; mit Lippensynchronisation kostet das 2 Credits pro Sekunde Clip. Die Stimmeinstellung der Figur selbst ändert sich dabei nicht. Soll eine Figur überall anders klingen, ändere die Stimme an der Figur selbst und generiere dann die gewünschten Segmente neu oder vertone sie neu.
Zu den Kosten allgemein: Für Sprache wird nichts extra berechnet. Der Ton ist Teil der Videogenerierung, die bei 10 Credits pro Sekunde Ausgabe beginnt. Die Seite zu den Figurenstimmen enthält alle Details, und eine Figurenstimme in einem fertigen Clip ändern erklärt Schritt für Schritt Redub.
Grenzen der KI-Stimmen hier
- Klone nur Stimmen, für die du die Rechte hast: deine eigene oder eine, zu der du die Erlaubnis hast.
- Redub bietet die eigene Stimme des Clips (Originalstimme, aus diesem Clip geklont) oder eine Stimme aus der Bibliothek der Seite an. Um die hochgeladene Stimme einer Figur neu zu hören, erzeuge das Segment stattdessen neu.
- Einen Clip, den du von anderswo hochlädst, bekommt neue Zeilen nur über Ersetzen bei einem Remake, das den geänderten Teil neu erzeugt.
- Die Betonung wird über Worte gesteuert. Eine sehr bestimmte Lesart braucht vielleicht ein paar Versuche, jeder davon eine Neugenerierung dieses Segments.
- Die Seitenzahl basiert auf einem Monat SceneMixer-Projekten und wird monatlich aktualisiert; die Community-Zahlen sind Stichwort-Näherungen.
FAQ
Kann ich meine eigene Stimme hochladen?
Mit einem bezahlten Tarif, ja. Lade für eine Figur eine Probeaufnahme hoch, und sie wird die Stimmreferenz dieser Figur für jedes Segment, in dem sie spricht. In SceneMixer dient eine hochgeladene Probe als Stimme dieser Figur in allen ihren Segmenten.
Bleibt die Stimme über Episoden hinweg gleich?
Ja. Die Stimme einer Figur hängt auf Projektebene und wandert in jedes Segment, in dem sie spricht.
Kann ich die Stimme eines Promis oder eines Freundes klonen?
Nur mit deren Erlaubnis. Auf SceneMixer kannst du als Mitglied eine Aufnahme hochladen, an deren Nutzung du die Rechte hast, etwa von einer befreundeten Person, die zugestimmt hat. Diese Figur spricht dann mit dieser Stimme. Die Stimme einer bekannten Person lässt sich nicht anhand des Namens abrufen.
Wie ändere ich, wie eine Zeile gesprochen wird?
Bearbeite die Notiz in Klammern vor der Zeile im Storyboard und generiere dann dieses Segment neu.
Verwandt: echte Emotionen und Schauspiel bei KI-Figuren geht tiefer auf die Darbietung ein, eine Stimme über Episoden hinweg gleich halten behandelt die Kontinuität, und die Community-Zahlen folgen der Erhebungsmethode.
Höre deine Besetzung sprechen
Ordne jeder Figur kostenlos eine Stimme zu und höre die erste Zeile in deiner eigenen Episode.
Kostenlos registrierenDie Preise pro Sekunde Video stehen mit denselben Zahlen auf der Preisseite.