Jawaban · Suara
Bagaimana Cara Membuat Video dengan Suara AI?
Diperbarui 15 November 2026

Mengapa suara menjadi tanda yang paling mudah dikenali
Coba tanyakan kepada penonton bagaimana mereka mengenali video AI sekarang, dan jawabannya sudah bergeser dari tangan ke suara. Dalam sebuah utas di r/aivideo tentang cara membedakan video AI pada 2026, balasan teratas merangkumnya dalam satu baris:
Tetapi tanda yang paling besar selalu ada pada suaranya.
Penonton drama AI berbicara dengan cara yang lebih pemaaf, dan itu sama bergunanya. Seorang penonton yang mendaftar seri yang pernah ditontonnya mengaku:
kadang kata-kata dan suaranya meleset, tapi mudah terabaikan karena daya tarik dan alur ceritanya secara keseluruhan
Keduanya benar: cerita yang bagus bisa menopang suara yang lemah, dan suara yang kuat membuat cerita yang bagus terasa nyata. Suara adalah salah satu topik terbesar dalam korpus komunitas, sekitar 12.000 postingan, dan keluhan soal bibir yang tidak sesuai dengan kata-kata saja mencapai sekitar 520.
Suara dan gambar dalam satu proses
Cara yang biasa untuk membuat video AI yang berbicara melibatkan tiga alat: membuat klip tanpa suara, membuat trek suara di tempat lain, lalu bersusah payah membuat mulut cocok dengan audionya. Model video yang dipakai di SceneMixer justru menghasilkan audio dan gambar dalam satu proses, sehingga satu segmen keluar dengan suaranya sudah menyatu: barisnya, suasana ruangannya, dan bibir yang mengucapkannya. Itu menghilangkan masalah pencocokan, dan mengubah arti “pengaturan suara”. Anda memilih suara apa yang dimiliki sebuah karakter, dan cara penyampaiannya datang dari storyboard.
Beri setiap karakter satu suara
Suara karakter berasal dari salah satu dari dua tempat. Suara preset yang cocok dipilih dari pustaka suara sistem yang sudah disampel, dan masing-masing punya sampel pendek yang bisa Anda dengarkan; pencocokan ini adalah panggilan model gratis dan tidak memakai kredit. Atau, pada paket berbayar, Anda mengunggah audio untuk sebuah karakter, dan audio itu menjadi referensinya untuk setiap segmen tempat ia berbicara. Suara tidak lagi dirancang dari daftar kata sifat, karena suara yang dibuat dari kata-kata akan melenceng dari satu pengambilan ke pengambilan lain, sama seperti wajah yang dideskripsikan dengan kata-kata.
Suara apa pun yang melekat pada karakter ditempelkan di tingkat proyek dan ikut ke setiap segmen tempat ia berbicara, sehingga suara tetap sama di setiap episode, dengan alasan yang sama seperti wajahnya. SceneMixer hanya mengkloning suara dari apa yang boleh Anda pakai: klip yang sedang dialihsuarakan (Suara asli di Alih Suara) atau rekaman yang Anda unggah dengan hak pemakaian.
Arahkan penyampaian dengan kata-kata
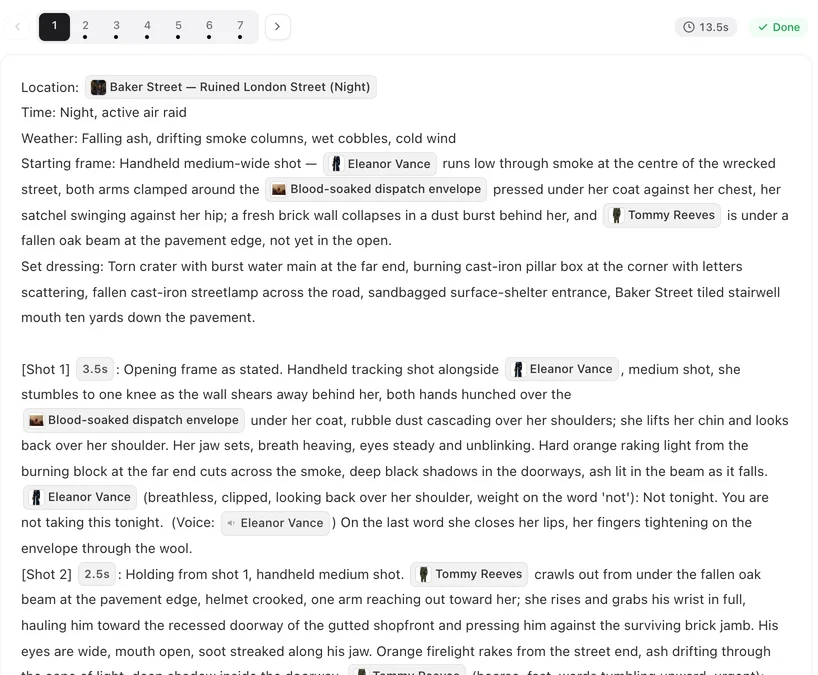
Penampilannya diarahkan oleh catatan tertulis di depan setiap baris dalam storyboard, seperti tersengal, berbisik, atau datar dengan amarah, bukan oleh editor gelombang suara. Jika pembacaannya salah, ubah catatannya dan buat ulang segmen itu. Itulah sebabnya mengubah sebuah baris berarti membuat ulang segmennya, bukan memotong ulang trek audio: suara dan gambarnya adalah satu pengambilan.
Bahasa bekerja dengan cara yang sama. Bahasa dialog dipilih di Langkah 1 dan barisnya ditulis dalam bahasa itu sejak awal, bukan di-dubbing setelahnya; ada 15 bahasa yang tersedia, dan pemeran di situs ini telah berbicara dalam 11 dari bahasa tersebut selama 30 hari hingga 6 November 2026.
Memperbaiki suara setelah jadi
Jika klip yang sudah jadi punya gambar yang benar tetapi suara yang salah, Anda tidak perlu membuatnya ulang. Redub memungkinkan Anda memilih suara lain dari pustaka untuk baris-baris seorang karakter di klip itu, mendengarkannya dulu, lalu meredub menjadi versi baru tanpa mengubah kata-katanya; dengan lip sync biayanya 2 kredit per detik klip. Pengaturan suara karakter itu sendiri tidak berubah, jadi untuk membuat seorang karakter terdengar berbeda di mana-mana, ubah suara pada karakternya sendiri lalu buat ulang atau redub segmen yang Anda inginkan.
Soal biaya secara umum, tidak ada tagihan terpisah untuk ucapan: audionya adalah bagian dari pembuatan video, yang mulai dari 10 kredit per detik keluaran. Halaman suara karakter memuat rinciannya lengkap, dan mengubah suara karakter dalam klip yang sudah jadi menjelaskan Redub langkah demi langkah.
Batasan suara AI di sini
- Kloning hanya suara yang boleh Anda pakai: unggah suara Anda sendiri, atau suara yang sudah Anda punya izinnya.
- Alih Suara menawarkan suara klip itu sendiri (Suara asli, dikloning dari klip itu) atau suara dari pustaka situs; untuk mendengar suara unggahan karakter dari awal, buat ulang segmen itu.
- Klip yang Anda unggah dari tempat lain hanya mendapat dialog baru melalui Ganti pada remake, yang membuat ulang bagian yang diubah.
- Penyampaian diarahkan lewat kata-kata. Pembacaan yang sangat spesifik mungkin butuh beberapa percobaan, masing-masing berupa pembuatan ulang segmen itu.
- Angka situs adalah satu bulan proyek SceneMixer, diperbarui setiap bulan; angka komunitas adalah perkiraan berdasarkan kata kunci.
FAQ
Bisakah saya mengunggah suara saya sendiri?
Di paket berbayar, bisa. Unggah contoh suara untuk sebuah karakter dan contoh itu menjadi referensi suara karakter tersebut untuk setiap segmen tempat dia berbicara. Di SceneMixer, contoh suara yang diunggah berfungsi sebagai suara karakter itu di semua segmennya.
Apakah suaranya tetap sama antar-episode?
Ya. Suara karakter ditetapkan di tingkat proyek dan ikut ke setiap segmen tempat ia berbicara.
Bisakah saya mengkloning suara seorang selebritas atau teman?
Hanya dengan izin mereka. Di SceneMixer, anggota dapat mengunggah rekaman yang berhak mereka gunakan, misalnya dari teman yang setuju, dan karakter tersebut berbicara dengan suara itu; tidak ada cara untuk mengambil suara selebritas berdasarkan nama.
Bagaimana cara mengubah cara sebuah baris diucapkan?
Edit catatan dalam kurung di depan baris dalam storyboard, lalu buat ulang segmen itu.
Terkait: mendapatkan emosi dan akting yang nyata dari karakter AI membahas penampilan lebih dalam, menjaga suara tetap sama di antar-episode membahas kesinambungan, dan angka komunitas mengikuti metode pengumpulan.
Dengarkan pemeran Anda berbicara
Cocokkan suara untuk setiap karakter secara gratis dan dengarkan baris pertama di episode Anda sendiri.
Daftar gratisTarif video per detik ada di halaman harga dengan angka yang sama.