回答 · ボイス
AIボイスで動画を作るにはどうすればいいですか?
2026年11月15日更新

声が見分けるポイントになる理由
今、視聴者にAI動画をどう見分けるか尋ねると、答えは手から音へと移っています。2026年にAI動画を見分ける方法について、r/aivideoのスレッドで、いちばん支持された返信は一行でこう書いていました:
それでも、いちばん大きな手がかりはいつも声です。
AIドラマの視聴者は、もっと寛容な言い方をします。これもまた同じくらい役に立つ見方です。視聴したシリーズを挙げていた一人の視聴者は、こう認めていました:
言葉と声がずれていることもあるけど、作品全体の魅力とストーリーで気にならなくなる
どちらも本当です。良い話は弱い声でも支えられますし、強い声は良い話をリアルに感じさせます。声はコミュニティのデータの中でも最も大きな話題のひとつで、投稿はおよそ12,000件あります。口の動きと言葉が合っていないという不満だけでも、およそ520件に上ります。
声と映像を一度の生成で
話すAI動画を作る一般的な方法は、ツールを3つ使うことです。無音のクリップを生成し、別の場所で音声トラックを作り、最後に口の動きと音声を合わせるのに苦労する。SceneMixerで使う動画モデルは、代わりに音声と映像を一度の生成で作ります。そのためセグメントは、セリフも部屋の環境音も、それを話す口の動きも、音が最初から入った状態で出てきます。これで合わせる問題がなくなり、「声の設定」の意味も変わります。キャラクターにどの声を割り当てるかを選ぶだけで、話し方は絵コンテから決まるのです。
キャラクターごとに声を一度決める
キャラクターの声は2つの方法のどちらかで決まります。ひとつは、マッチングしたプリセットを選ぶ方法です。サンプリングされたシステムボイスのライブラリから選び、それぞれに短いサンプルを聴けます。マッチングは無料のモデル呼び出しで、クレジットは使いません。もうひとつは、有料プランで、キャラクター用の音声をアップロードする方法です。その音声は、そのキャラクターが話すすべてのセグメントの参照になります。もう声を形容詞のリストから設計することはしていません。言葉で作った声は、言葉で描写した顔と同じように、テイクごとにずれてしまうからです。
キャラクターに付けた声は、プロジェクトの単位で設定され、そのキャラクターが話すすべてのセグメントに引き継がれます。そのため、顔と同じ理由で、声は話数をまたいでも同じままです。SceneMixerが声をクローンするのは、使用権のあるものだけです。再吹き替えするクリップ(Redubのオリジナル音声)か、使用権のある録音をアップロードした場合に限ります。
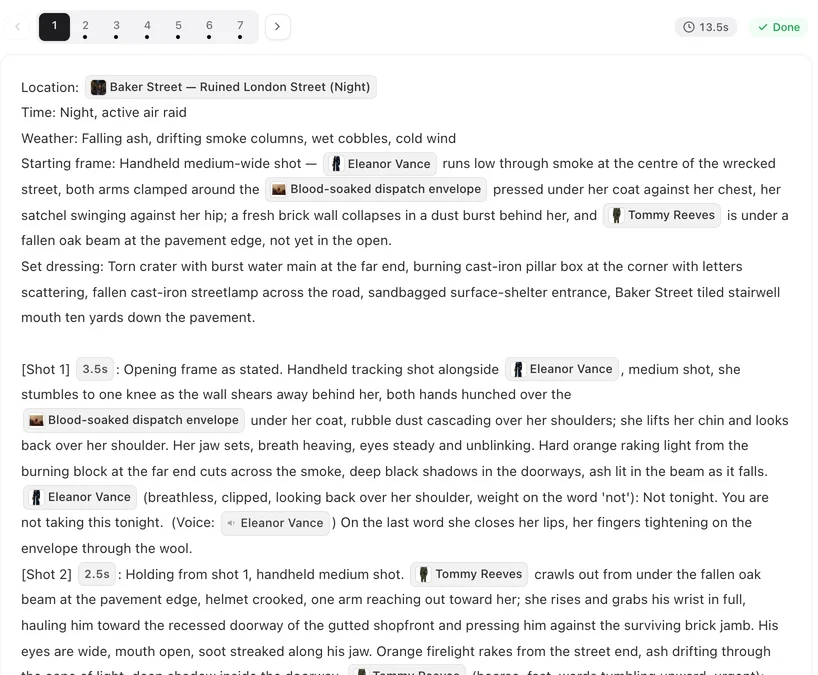
話し方は言葉で指示する
演技は、絵コンテの各セリフの前に書いたメモで指示します。息切れ気味に、ささやくように、怒りを抑えて平坦に、など。波形エディタで操作するわけではありません。読み方が違うと感じたら、メモを直してそのセグメントを生成し直してください。セリフを変えるとき、音声トラックを切り直すのではなくセグメントを生成し直すのも、同じ理由からです。声と映像は一つのテイクだからです。
言語も同じ仕組みです。セリフの言語はステップ1で選び、最初からその言語でセリフを書きます。後から吹き替えるわけではありません。利用できる言語は15言語で、サイト上のキャストは2026年11月6日までの30日間に、そのうち11言語で話していました。
後から声を直す
完成したクリップで映像は合っているのに声だけ違う場合、生成し直す必要はありません。リダブを使えば、そのクリップ内のキャラクターのセリフに、ライブラリから別の声を選べます。先に聴いてから、言葉を変えずに新しいバージョンとしてリダブできます。リップシンク付きの場合、1秒あたり2クレジットかかります。キャラクター自身の声の設定は変わりません。どこでもそのキャラクターの声を変えたいなら、キャラクターの声そのものを変更してから、必要なセグメントを生成し直すかリダブしてください。
料金については、音声に別料金はありません。音声は動画生成の一部で、出力1秒あたり10クレジットから始まります。詳細はキャラクターの声のページにあり、完成したクリップでキャラクターの声を変えるでは、リダブの手順を説明しています。
AIの声の制限事項
- 使用権のある声だけをクローンしてください。ご自身の声か、許可を得た声をアップロードしてください。
- 再吹き替えでは、クリップ自身の声(オリジナル音声、そのクリップからクローン)か、サイトのライブラリの声を提示します。キャラクターのアップロードした声を新たに聞くには、代わりにそのセグメントを生成し直してください。
- ほかの場所から取り込んだクリップに新しいセリフが入るのは、リメイクの置き換えを使ったときだけで、変えた部分は生成し直されます。
- 話し方は言葉で指示します。非常に具体的な読み方は、数回の試行が必要になることがあります。試行はそれぞれ、そのセグメントの生成し直しになります。
- サイトの数字はSceneMixerのプロジェクト1か月分で、毎月更新しています。コミュニティの件数はキーワードによる概算です。
よくある質問
自分の声をアップロードできますか?
有料プランなら可能です。キャラクターのサンプルをアップロードすると、そのキャラクターが話すすべてのセグメントで、その声の参照になります。SceneMixerでは、アップロードしたサンプルが、そのキャラクターが出るすべてのセグメントでの声になります。
声はエピソードをまたいでも同じままですか?
はい。キャラクターの声はプロジェクト単位で紐づけられ、そのキャラクターが話すすべてのセグメントに引き継がれます。
有名人や友人の声をクローンできますか?
本人の許可がある場合のみです。SceneMixerでは、使用権のある録音(たとえば了承してくれた友人の声など)をメンバーがアップロードでき、そのキャラクターはその声で話します。有名人の声を名前で取得する方法はありません。
セリフの言い方を変えるにはどうすればいいですか?
絵コンテでセリフの前にある括弧のメモを編集して、そのセグメントを生成し直してください。
関連記事:AIキャラクターにリアルな感情と演技を出すにはでは演技をさらに掘り下げ、声をエピソードをまたいで揃えるにはでは連続性を扱い、コミュニティの件数は集計方法に基づいています。