Respuestas · Voces
¿Cómo hago un video con voz de IA?
Actualizado el 15 de noviembre de 2026

Por qué las voces delatan el video
Si hoy le preguntas a la gente cómo detecta un video de IA, la respuesta ya no son las manos, sino el sonido. En un hilo de r/aivideo sobre cómo distinguir videos de IA en 2026, la respuesta más votada lo resumía en una línea:
Pero la pista más grande son siempre las voces.
El público de los dramas de IA dice algo más indulgente, y igual de útil. Un espectador que enumeraba las series que había visto admitió:
a veces las palabras y las voces no encajan, pero el atractivo general y la trama hacen que se pase por alto con facilidad
Ambas cosas son ciertas: una buena historia aguanta una voz floja, y una voz sólida hace que una buena historia se sienta real. La voz es uno de los temas más grandes del corpus de la comunidad, con unas 12.000 publicaciones, y solo las quejas por labios que no coinciden con las palabras suman unas 520.
Voz e imagen en una sola pasada
La forma habitual de hacer un video de IA con diálogo son tres herramientas: generar un clip sin sonido, generar la pista de voz en otro sitio y luego pelearse para que la boca coincida con el audio. Los modelos de video que usa SceneMixer generan audio e imagen en una sola pasada, así que cada segmento sale con su sonido ya dentro: la línea, el ambiente de la sala y los labios que la dicen. Eso elimina el problema de sincronizar y cambia lo que es un «ajuste de voz»: eliges qué voz tiene cada personaje, y la interpretación sale del storyboard.
Asigna una voz a cada personaje una sola vez
La voz de un personaje sale de uno de dos lugares. Una voz predefinida se elige de una biblioteca de voces del sistema muestreadas, cada una con una muestra corta que puedes escuchar; la búsqueda de coincidencia es una llamada gratuita al modelo y no gasta créditos. O bien, en un plan de pago, subes audio para un personaje, y se convierte en su referencia en cada segmento en el que hable. Las voces ya no se diseñan a partir de una lista de adjetivos, porque una voz hecha de palabras se desvía entre tomas igual que un rostro descrito con palabras.
Cualquier voz asignada a un personaje queda vinculada al proyecto y viaja a cada segmento en el que habla, así que la voz se mantiene igual en todos los episodios, igual que el rostro. SceneMixer solo clona una voz a partir de lo que puedes usar: el clip que se está redoblando (la Voz original de Redoblar) o una grabación que subas con derecho a usarla.
Guía la interpretación con palabras
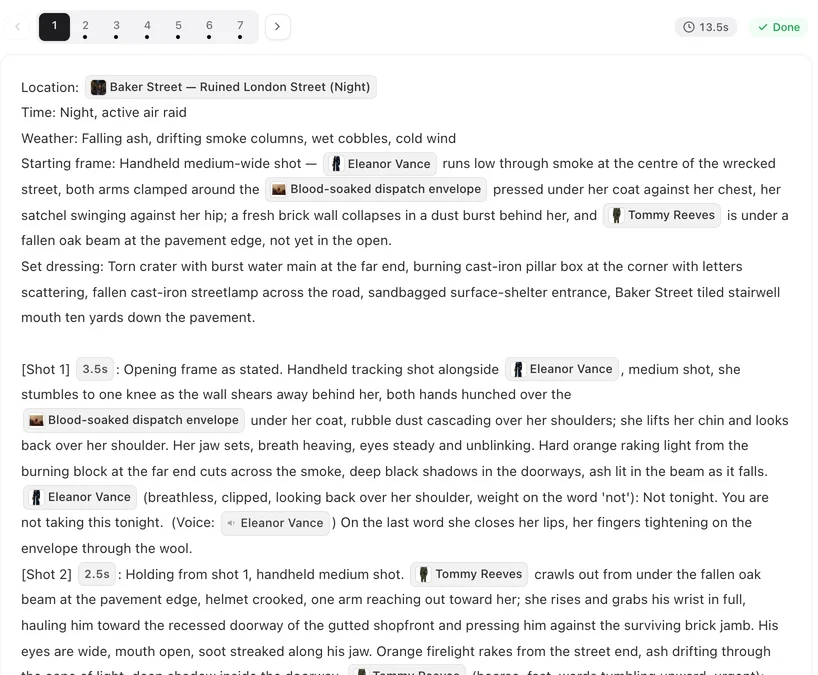
La interpretación se guía con la nota escrita delante de cada línea en el storyboard (entrecortada, susurrada, plana por la rabia) y no con un editor de ondas. Si una lectura sale mal, cambia la nota y regenera ese segmento. Por eso cambiar una línea significa regenerar su segmento en vez de volver a cortar una pista de audio: la voz y la imagen son una sola toma.
El idioma funciona igual. El idioma del diálogo se elige en el paso 1 y las líneas se escriben en él desde el principio, en lugar de doblarse después; hay 15 idiomas disponibles, y los repartos del sitio hablaron 11 de ellos durante los 30 días hasta el 6 de noviembre de 2026.
Corregir una voz después
Si un clip terminado tiene la imagen correcta pero la voz equivocada, no hace falta regenerarlo. Volver a doblar te deja elegir otra voz de la biblioteca para las líneas de un personaje en ese clip, escucharla antes y generar una versión nueva sin cambiar las palabras; con sincronización labial cuesta 2 créditos por segundo de clip. El ajuste de voz del personaje no cambia, así que para que un personaje suene distinto en todas partes, cambia la voz del personaje y luego regenera o vuelve a doblar los segmentos que quieras.
En cuanto al coste en general, la voz no tiene cobro aparte: el audio forma parte de la generación de video, que empieza en 10 créditos por segundo de salida. La página de voces de personaje tiene todos los detalles, y cómo cambiar la voz de un personaje en un clip terminado explica paso a paso cómo volver a doblar.
Límites de las voces de IA aquí
- Clona solo voces que tengas derecho a usar: sube tu propia voz, o una para la que tengas permiso.
- Redoblar ofrece la voz propia del clip (Voz original, clonada de ese clip) o una voz de la biblioteca del sitio; para oír de nuevo la voz subida de un personaje, regenera ese segmento.
- Un clip que subes desde otro lugar solo recibe líneas nuevas mediante el Reemplazar de un remake, que vuelve a generar la parte cambiada.
- La interpretación se guía con palabras. Una lectura muy concreta puede necesitar varios intentos, cada uno una regeneración de ese segmento.
- La cifra del sitio corresponde a un mes de proyectos de SceneMixer, actualizada cada mes; los recuentos de la comunidad son aproximaciones por palabras clave.
Preguntas frecuentes
¿Puedo subir mi propia voz?
Sí, con un plan de pago. Sube una muestra de un personaje y se convierte en la referencia de voz de ese personaje en cada segmento en el que hable. En SceneMixer, una muestra subida sirve como voz de ese personaje en todos sus segmentos.
¿La voz se mantiene igual en todos los episodios?
Sí. La voz de un personaje queda vinculada al proyecto y viaja a cada segmento en el que hable.
¿Puedo clonar la voz de un famoso o de un amigo?
Solo con su permiso. En SceneMixer, un miembro puede subir una grabación de la que tenga derecho de uso, como la de un amigo que haya dado su consentimiento, y ese personaje habla con esa voz; no hay forma de obtener la voz de una celebridad por nombre.
¿Cómo cambio la forma en que se dice una línea?
Edita la nota entre corchetes delante de la línea en el storyboard y regenera ese segmento.
Relacionados: cómo lograr emoción y actuación reales en personajes de IA profundiza en la interpretación, mantener una voz igual en todos los episodios trata la continuidad, y los recuentos de la comunidad siguen el método de recogida.
Escucha hablar a tu reparto
Asigna una voz a cada personaje gratis y escucha la primera línea en tu propio episodio.
Regístrate gratisLas tarifas de video por segundo están en la página de precios, con las mismas cifras.