解答 · 配音
要怎麼用 AI 配音製作影片?
更新於 2026 年 11 月 15 日

為什麼聲音最容易露餡?
現在問觀眾怎麼分辨 AI 影片,答案已經從手部移到聲音。在 r/aivideo 的一則討論串 裡,有關 2026 年怎麼分辨 AI 影片,最高票回覆只用一句話講清楚:
但最明顯的破綻,永遠是聲音。
AI 短劇的觀眾說法比較寬容,這點同樣有參考價值。一位列出自己看過哪些劇的觀眾承認:
有時台詞和配音會對不上,但很容易被整體的吸引力和劇情蓋過去
兩種說法都成立:好故事能撐住比較弱的配音,而好的配音會讓好故事更有真實感。聲音是社群語料裡最大的主題之一,約有 12,000 則貼文,光是抱怨嘴型跟不上台詞的就約有 520 則。
聲音與畫面一次生成
一般做會說話的 AI 影片,要靠三種工具:先生成無聲片段,再到別處生成配音,最後還得硬把嘴型對到音訊上。SceneMixer 使用的影片模型則是在一次生成中同時產出聲音和畫面,所以每個片段出來時聲音就已經在裡面了,包括台詞、空間的環境音,以及說話的嘴型。這樣就不必再對嘴,而「聲音設定」的意義也跟著改變:你只需選定角色的聲音,演出方式則來自分鏡。
每個角色只定一次聲音
角色的聲音有兩個來源。一是配對預設音色:從系統音色庫中挑選,每個音色都附有可試聽的短範本;配對是免費的模型呼叫,不會消耗積分。二是在付費方案下,為角色上傳音訊,它就會成為該角色每個有說話片段的參考。聲音不再靠一串形容詞來設計,因為用文字描述出來的聲音,跟用文字描述的臉一樣,每次生成都會飄移。
附加在角色上的任何聲音,都會附加在項目層級,並帶入他們說話的每一段,所以同一角色跨集的聲音保持一致,原因和臉一樣。SceneMixer 只從你有權使用的內容複製聲音:要改臺詞的那條片段(改臺詞的原聲),或你有權使用而上傳的錄音。
用文字引導演出
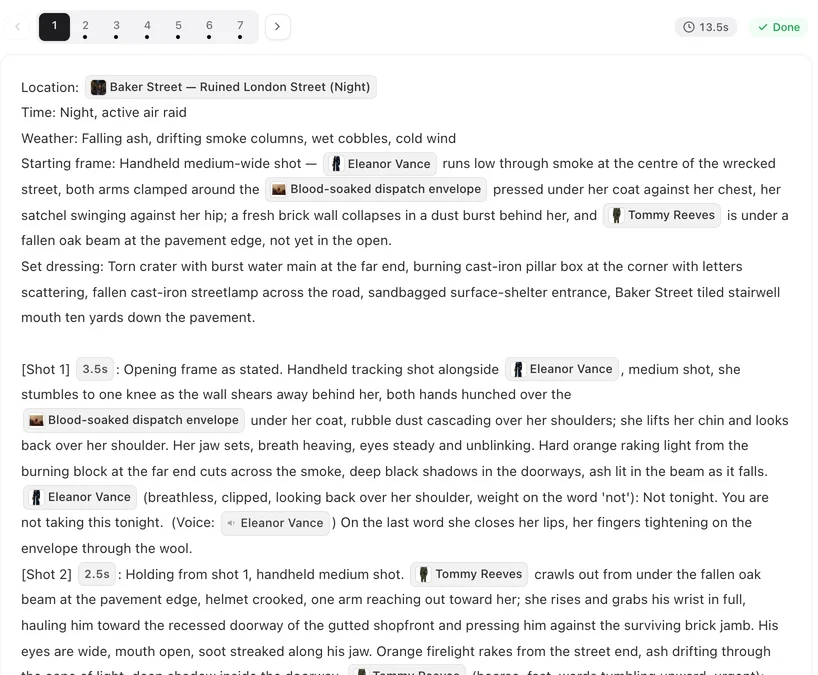
演出是靠分鏡裡每句台詞前面寫下的註記來引導,例如喘著氣、耳語、帶著怒氣的平淡,而不是靠波形編輯器。如果讀法不對,就改註記,再重新生成該片段。這也是為什麼改一句台詞,做法是重新生成它所在的片段,而不是重剪一段音軌:聲音和畫面是同一條。
語言的做法也一樣。對白語言在第一步就選定,台詞從一開始就用該語言寫成,而不是事後配音;目前可選 15 種語言,站上的演員陣容用了其中 11 種,統計期間為 截至 2026 年 11 月 6 日的 30 天。
事後修正聲音
如果成片的畫面對了、聲音不對,不必整段重新生成。重新配音功能可以為該片段中角色的台詞,從音色庫挑選另一個聲音,先試聽,再產出一個不改台詞的新版本;開啟對嘴時,每秒片長要 2 積分。角色本身的聲音設定不會因此改變,所以若要讓角色在所有地方都換聲音,就要改角色本身的聲音,再重新生成或重新配音你要的片段。
說到成本,語音沒有另外收費:音訊是影片生成的一部分,影片生成從每秒 10 積分 起算。角色音色頁面有完整說明,在成片中更換角色聲音則一步步介紹重新配音的做法。
這裡的 AI 配音有哪些限制
- 只複製你有權使用的聲音:上傳你自己的聲音,或你已獲得許可的聲音。
- 改臺詞提供片段自己的聲音(原聲,從該片段複製),或網站聲音庫裡的聲音;若要重新聽到角色上傳的聲音,請改為重新生成該段。
- 從別處上傳的片段,只有透過復刻的替換才能獲得新臺詞,它會重新生成有改動的部分。
- 演出靠文字引導。如果要非常特定的讀法,可能要試幾次,每次都要重新生成該片段。
- 站上的數字取自 SceneMixer 一個月的專案,每月更新;社群的數量則是關鍵字估算。
常見問題
我可以上傳自己的聲音嗎?
付費方案可以。為角色上傳一段範例,它就會成為該角色每一段有臺詞的片段的聲音參考。在 SceneMixer 裡,上傳的範例會作為該角色在所有片段中的聲音。
同一角色跨集的聲音會一致嗎?
會。角色聲音綁定在專案層級,會帶進該角色每個有說話的片段。
我可以複製名人或朋友的聲音嗎?
只能在本人同意的情況下使用。在 SceneMixer 上,會員可以上傳自己有權使用的錄音,例如獲得同意的朋友錄音,角色就會以該聲音說話;無法依名字取得名人的聲音。
要怎麼改一句台詞的說法?
在分鏡中修改台詞前面的括號註記,再重新生成該片段。
延伸閱讀:如何讓 AI 角色有真實的情緒與演技 更深入談演出,如何讓聲音跨集保持一致 談連戲,社群數量的計算方式則見統計方法。