Antwoorden · Stemmen
Hoe maak ik een video met AI-stem?
Bijgewerkt 15 november 2026

Waarom de stem het meest verraadt
Vraag kijkers hoe ze AI-video nu herkennen en het antwoord is verschoven van handen naar geluid. Onder een draad op r/aivideo over het herkennen van AI-video in 2026 zette het topantwoord het in één zin:
Maar het grootste verraad zijn altijd de stemmen.
Het publiek van AI-drama's zegt iets milder, wat even bruikbaar is. Een kijker die series opsomde die hij had bekeken, gaf toe:
soms kloppen de woorden en stemmen niet, maar dat valt makkelijk weg tegen de algehele aantrekkingskracht en het verhaal
Allebei waar: een goed verhaal draagt een zwakke stem, en een sterke stem laat een goed verhaal echt aanvoelen. Stem is een van de grootste onderwerpen in het communitycorpus, ongeveer 12.000 berichten, en klachten dat lippen niet bij de woorden passen komen alleen al op ongeveer 520.
Stem en beeld in één keer
De gebruikelijke manier om een sprekende AI-video te maken, gaat met drie tools: eerst een stille clip genereren, dan elders een stemspoor genereren, en daarna worstelen om de mond op het geluid te laten passen. De videomodellen op SceneMixer genereren geluid en beeld juist in één keer, zodat een segment al met zijn geluid komt: de regel, de kamertoon en de lippen die hem uitspreken. Dat haalt het passingsprobleem weg, en het verandert wat een „stem-instelling” is: je kiest welke stem een personage heeft, en de voordracht komt uit het storyboard.
Geef elk personage één keer een stem
De stem van een personage komt van een van twee plekken. Een gekozen voorinstelling wordt uit een bibliotheek met gesampelde systeemstemmen gekozen, elk met een korte voorbeeldopname die je kunt beluisteren; het koppelen is een gratis modelaanroep en gebruikt geen credits. Of, met een betaald abonnement, upload je audio voor een personage, en die wordt de referentie voor elk segment waarin het spreekt. Stemmen worden niet meer ontworpen aan de hand van een lijst bijvoeglijke naamwoorden, want een stem die met woorden is gemaakt, schuift tussen takes net zoals een gezicht dat met woorden is beschreven.
Welke stem er aan een personage hangt, wordt op projectniveau vastgelegd en gaat mee naar elk segment waarin het spreekt, zodat de stem hetzelfde blijft over afleveringen, net zoals het gezicht. SceneMixer kloont een stem alleen uit wat je mag gebruiken: het fragment dat wordt nagesynchroniseerd (Redub’s Originele stem) of een opname die je uploadt met het recht om die te gebruiken.
Stuur de voordracht met woorden
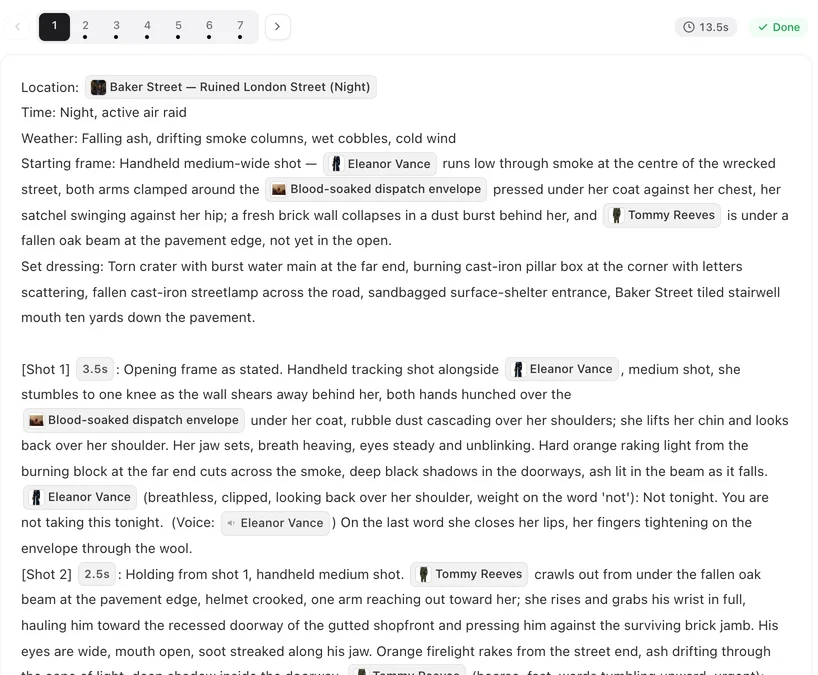
De uitvoering wordt gestuurd door de geschreven notitie voor elke regel in het storyboard: hijgerig, gefluisterd, vlak van woede. Niet door een golfvormeditor. Klopt een lezing niet, pas dan de notitie aan en genereer dat segment opnieuw. Daarom betekent een regel wijzigen ook het segment opnieuw genereren, in plaats van een audiospoor opnieuw snijden: de stem en het beeld zijn één take.
Taal werkt op dezelfde manier. De dialoogtaal kies je in stap 1 en de regels worden er vanaf het begin in geschreven, in plaats van achteraf nagesynchroniseerd; er zijn 15 talen beschikbaar, en de casts op de site spraken er 11 van over de 30 dagen tot 6 november 2026.
Een stem achteraf aanpassen
Als een afgewerkte clip het juiste beeld heeft maar de verkeerde stem, hoef je hem niet opnieuw te genereren. Met Redub kies je een andere stem uit de bibliotheek voor de regels van een personage in die clip, luister je eerst, en maak je een nieuwe versie zonder de woorden te veranderen; met lipsync kost dat 2 credits per seconde clip. De stem-instelling van het personage zelf verandert niet, dus wil je dat een personage overal anders klinkt, wijzig dan de stem op het personage zelf en genereer of redub daarna de segmenten die je wilt.
Wat de kosten betreft: spraak wordt niet apart gerekend; het geluid hoort bij de videogeneratie, die begint bij 10 credits per seconde output. De pagina over personagestemmen geeft alle details, en een personagestem wijzigen in een afgewerkte clip loopt Redub stap voor stap door.
Beperkingen van AI-stemmen
- Kloon alleen stemmen waarop je het recht hebt: upload je eigen stem, of een stem waarvoor je toestemming hebt.
- Redub biedt de eigen stem van het fragment aan (Originele stem, gekloond uit dat fragment) of een stem uit de bibliotheek van de site; om de geüploade stem van een personage opnieuw te horen, genereer je dat segment opnieuw.
- Een fragment dat je van elders uploadt, krijgt alleen nieuwe regels via de Vervangen van een remake, die het gewijzigde deel opnieuw genereert.
- De voordracht wordt gestuurd met woorden. Een heel specifieke lezing kan een paar pogingen vergen, elk een nieuwe generatie van dat segment.
- Het cijfer van de site is één maand SceneMixer-projecten, elke maand ververst; de communitytellingen zijn benaderingen op basis van zoekwoorden.
Veelgestelde vragen
Kan ik mijn eigen stem uploaden?
Op een betaald abonnement, ja. Upload een voorbeeld voor een personage en het wordt de stemreferentie van dat personage voor elk segment waarin het spreekt. In SceneMixer dient een geüpload voorbeeld als de stem voor dat personage in al zijn segmenten.
Blijft de stem gelijk over afleveringen heen?
Ja. De stem van een personage is op projectniveau vastgelegd en gaat mee naar elk segment waarin het spreekt.
Kan ik de stem van een beroemdheid of een vriend klonen?
Alleen met hun toestemming. Op SceneMixer kan een lid een opname uploaden waarvan het gebruiksrecht heeft, zoals van een vriend die heeft ingestemd, en dat personage spreekt er dan mee; er is geen manier om de stem van een bekende persoon op naam op te halen.
Hoe verander ik hoe een regel wordt gezegd?
Pas de notitie tussen haakjes voor de regel in het storyboard aan en genereer dat segment opnieuw.
Verwant: echte emotie en acteerwerk uit AI-personages gaat dieper in op de voordracht, een stem over afleveringen heen gelijk houden behandelt continuïteit, en de communitytellingen volgen de verzamelmethode.
Hoor je cast spreken
Koppel gratis een stem aan elk personage en hoor de eerste regel in je eigen aflevering.
Gratis aanmeldenDe tarieven per seconde video staan op de prijspagina met dezelfde cijfers.