الإجابات · الأصوات
كيف أصنع فيديو بصوت الذكاء الاصطناعي؟
تم التحديث في 15 نوفمبر 2026

لماذا تفضحك الأصوات؟
اسأل المشاهدين كيف يكتشفون فيديو الذكاء الاصطناعي اليوم، وستجد أن الجواب انتقل من الأيدي إلى الصوت. وتحت نقاش في r/aivideo عن التفريق بين فيديوهات الذكاء الاصطناعي في 2026، قالت أعلى إجابة في سطر واحد:
لكن أكبر دليل يبقى دائمًا الأصوات.
يقول جمهور الدراما المولّدة بالذكاء الاصطناعي كلامًا أكثر تسامحًا، وهو مفيد بالقدر نفسه. وأقرّ أحد المشاهدين، وهو يعدّد المسلسلات التي تابعها:
أحيانًا تكون الكلمات والأصوات غير متطابقة، لكنها تمرّ دون أن يلاحظ أحد ذلك بسبب جاذبية العمل ككل وحبكته
الأمران صحيحان: القصة الجيدة تحمل صوتًا ضعيفًا، والصوت القوي يجعل القصة الجيدة تبدو حقيقية. والصوت من أكبر المواضيع في مجتمع المستخدمين، إذ يبلغ عدد المنشورات حوله نحو 12,000 منشور، وتصل الشكاوى من أن الشفاه لا تطابق الكلام وحده إلى نحو 520.
الصوت والصورة في تمريرة واحدة
الطريقة المعتادة لصنع فيديو ناطق بالذكاء الاصطناعي تحتاج ثلاث أدوات: توليد مقطع صامت، ثم توليد مسار صوتي في مكان آخر، ثم الكفاح لجعل حركة الفم تطابق الصوت. أما نماذج الفيديو المستخدمة في SceneMixer فتولّد الصوت والصورة معًا في تمريرة واحدة، فيخرج المقطع وصوته مدمجًا فيه منذ البداية: السطر، وصدى المكان، والشفاه التي تنطقه. وبذلك تختفي مشكلة المطابقة، ويتغيّر معنى «إعداد الصوت»: تختار الصوت الذي تمتلكه الشخصية، أما طريقة الأداء فتأتي من المخطط المصوّر.
امنح كل شخصية صوتًا مرة واحدة
يأتي صوت الشخصية من أحد مصدرين. الأول صوت جاهز مطابَق يُختار من مكتبة أصوات نظام مُسجَّلة، ولكل صوت عيّنة قصيرة يمكنك الاستماع إليها؛ والمطابقة استدعاء نموذج مجاني لا يستهلك رصيدًا. أو، في الخطة المدفوعة، ترفع تسجيلًا صوتيًا للشخصية، فيصبح مرجعًا لها في كل مقطع تتكلم فيه. ولم تعد الأصوات تُصمَّم من قائمة صفات، لأن الصوت المصوغ بالكلمات ينجرف بين اللقطات بالطريقة نفسها التي ينجرف بها وجه يُوصف بالكلمات.
أي صوت يُرفق بشخصية يُرفق على مستوى المشروع ويُنقل إلى كل مقطع تتكلم فيه، فيبقى الصوت ثابتًا عبر الحلقات لنفس سبب ثبات الوجه. ولا يستنسخ SceneMixer صوتًا إلا من ما يحق لك استخدامه: المقطع الذي تُعاد دبلجته (الصوت الأصلي في إعادة الدبلجة) أو تسجيل ترفعه وتملك حق استخدامه.
وجّه الأداء بالكلمات
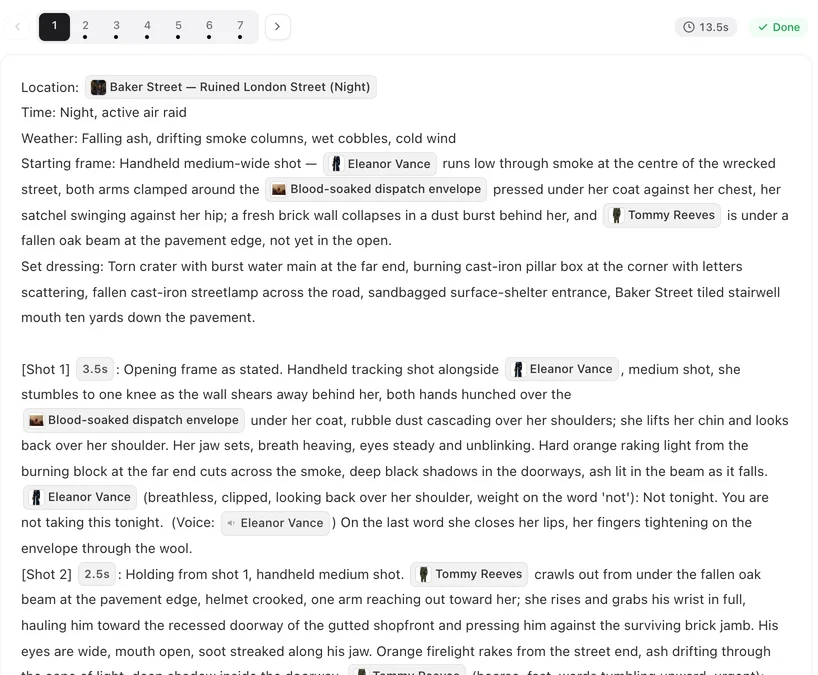
يُوجَّه الأداء بالملاحظة المكتوبة أمام كل سطر في المخطط المصوّر، لاهثًا أو همسًا أو بنبرة غضب جامدة، لا بمحرّر الموجات الصوتية. وإذا جاءت القراءة خاطئة، غيّر الملاحظة وأعد توليد ذلك المقطع. ولهذا أيضًا يعني تغيير سطر إعادة توليد مقطعه، لا إعادة قص مسار صوتي: فالصوت والصورة لقطة واحدة.
وتعمل اللغة بالطريقة نفسها. تُختار لغة الحوار في الخطوة 1 وتُكتب الأسطر بها من البداية، لا تُدبلج بعد ذلك؛ وتتوفر 15 لغة، وتحدّثت شخصيات الموقع بـ11 منها خلال الأيام الـ30 حتى 6 نوفمبر 2026.
تصحيح الصوت بعد التوليد
إذا كان المقطع المكتمل صورته صحيحة وصوته خاطئًا، فلا داعي لإعادة توليده. تتيح لك “إعادة الدبلجة” اختيار صوت آخر من المكتبة لأسطر شخصية في ذلك المقطع، والاستماع أولًا، ثم الدبلجة إلى نسخة جديدة دون تغيير الكلمات؛ ومع مزامنة الشفاه يكلّف 2 رصيد لكل ثانية من المقطع. ولا يتغيّر إعداد صوت الشخصية نفسه، لذا إن أردت أن تبدو الشخصية مختلفة في كل مكان، فغيّر الصوت على الشخصية ذاتها ثم أعد توليد المقاطع أو إعادة دبلجتها حسب الحاجة.
أما التكلفة عمومًا، فلا توجد رسوم منفصلة للكلام: الصوت جزء من توليد الفيديو، الذي يبدأ من 10 رصيد لكل ثانية من المخرجات. وتجد صفحة أصوات الشخصيات التفاصيل كاملة، ويشرح تغيير صوت شخصية في مقطع جاهز إعادة الدبلجة خطوة بخطوة.
حدود أصوات الذكاء الاصطناعي هنا
- استنسخ الأصوات التي يحق لك استخدامها فقط: ارفع صوتك أنت، أو صوتًا لديك إذن به.
- تعرض إعادة الدبلجة صوت المقطع نفسه (الصوت الأصلي، مستنسخًا من ذلك المقطع) أو صوتًا من مكتبة الموقع؛ ولسماع صوت شخصية مرفوع من جديد، أعد توليد ذلك المقطع بدلًا من ذلك.
- المقطع الذي ترفعه من مكان آخر لا يحصل على أسطر جديدة إلا عبر الاستبدال في إعادة الإنتاج، الذي يُعيد توليد الجزء المتغيّر.
- يُوجَّه الأداء بالكلمات. قد تحتاج القراءة الدقيقة جدًا إلى عدة محاولات، كل واحدة منها إعادة توليد لذلك المقطع.
- رقم الموقع يمثل شهرًا واحدًا من مشاريع SceneMixer ويُحدَّث شهريًا؛ أما أرقام المجتمع فهي تقديرات قائمة على الكلمات المفتاحية.
الأسئلة الشائعة
هل يمكنني رفع صوتي الخاص؟
في الباقة المدفوعة، نعم. ارفع عينة لشخصية، فتصبح مرجع صوتها في كل مقطع تتكلم فيه. في SceneMixer، تعمل العينة المرفوعة صوتًا لتلك الشخصية في كل مقاطعها.
هل يبقى الصوت نفسه عبر الحلقات؟
نعم. يُربط صوت الشخصية على مستوى المشروع وينتقل إلى كل مقطع تتكلم فيه.
هل يمكنني استنساخ صوت مشهور أو صديق؟
فقط بإذنه. على SceneMixer يمكن للعضو رفع تسجيل يملك حق استخدامه، مثل تسجيل لصديق وافق، ويتحدث الشخصية بذلك الصوت؛ ولا توجد طريقة لجلب صوت مشهور بالاسم.
كيف أغيّر طريقة قول سطر ما؟
عدّل الملاحظة بين القوسين أمام السطر في المخطط المصوّر، ثم أعد توليد ذلك المقطع.
ذو صلة: الحصول على مشاعر وأداء حقيقيين من شخصيات الذكاء الاصطناعي يتعمّق في الأداء، والحفاظ على الصوت نفسه عبر الحلقات يتناول الاستمرارية، وتتبع أرقام المجتمع طريقة الجمع.
استمع إلى شخصياتك وهي تتكلم
طابِق صوتًا لكل شخصية مجانًا، واستمع إلى السطر الأول في حلقتك أنت.
سجّل مجانًاأسعار الفيديو لكل ثانية موجودة في صفحة الأسعار بالأرقام نفسها.