Respuestas · Voz
¿Cómo mantengo la voz de un personaje constante en todos los episodios?
Actualizado el 14 de octubre de 2026

Las tres formas en que un personaje puede tener una voz
Los personajes se emparejan con una biblioteca de voces preestablecidas en lugar de diseñarse a partir de una descripción de texto, y también puedes subir tu propia muestra para un personaje. En concreto, un personaje puede estar en tres estados. El primero es una voz descrita con palabras: edad, peso y ritmo, extraídos de la lectura del guion e interpretados por el modelo de vídeo. Así empieza todo personaje a menos que hagas algo, y hace un trabajo razonable: la descripción es lo que el modelo escucha en lugar de una muestra.
El segundo es un ajuste preestablecido emparejado. Cada voz de la biblioteca incluye una muestra corta que puedes reproducir antes de elegirla; el sitio propone una coincidencia por personaje según el género, el idioma y la edad, y puedes reemparejarla o elegir otra manualmente desde el selector. El emparejamiento es una llamada al modelo gratuita: no consume créditos y no se ve afectado por tu límite de simultaneidad. El tercero es tu propia grabación: sube una muestra para un personaje y se convertirá en la referencia de voz de ese personaje para todos los segmentos en los que hable, y los emparejamientos posteriores no la sobrescribirán.
Un límite que debes respetar: la biblioteca de emparejamiento y la opción de subida existen para voces que te pertenecen o para las que tienes licencia de uso. La propia guía de cumplimiento del sitio considera que el parecido —tanto de rostro como de voz— es algo para lo que debes tener derecho de uso antes de publicar, y la interfaz no puede comprobar si una muestra es tuya: quien pulsa subir asume la responsabilidad. Así que sube tu propia voz, o una para la que tengas permiso, y trata cualquier otra cosa como una pregunta para un abogado, no como un truco de flujo de trabajo. Los términos le dan el mismo peso.
Por qué la misma voz se mantiene en toda la serie
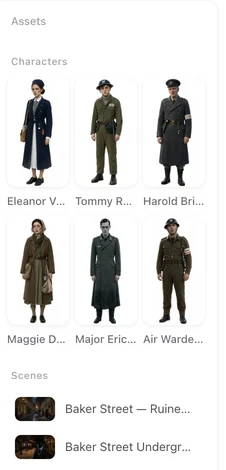
La voz, al igual que el rostro, es una propiedad del personaje en el proyecto. Cualquiera que sea la fuente adjunta, se usa de forma constante: el mismo personaje habla con la misma voz en todos los segmentos y todos los episodios —tanto el episodio uno como el doce— porque la referencia viaja con el personaje a cada plano en el que aparece. No hace falta volver a indicarlo en ninguna línea de plano, y regenerar un solo segmento no lo cambia.
Vale la pena conocer dos detalles. Asignar voces es un paso deliberado, no algo que ocurre automáticamente con todos los personajes, así que un personaje sin ajuste preestablecido adjunto sigue funcionando con la descripción escrita. Y asignar una es una decisión por personaje, no por proyecto: dos protagonistas pueden tener un ajuste preestablecido y una voz descrita, y la mezcla es estable en ambos casos.
La entonación es una capa distinta. Cómo se dice una frase —baja y constante, ronca, apenas audible— se escribe en la propia línea como nota de interpretación, porque un susurro es una dirección, no una segunda voz. Mantén las notas de interpretación en la línea a la que pertenecen y deja que la voz sea la del personaje.
Un proyecto, un idioma de diálogo
El idioma en el que habla el reparto se configura por proyecto, antes de analizar el guion, y es uno de los quince idiomas de la interfaz más el cantonés como opción solo para diálogos. La frase se interpreta en ese idioma mientras se renderiza el plano —la imagen y el habla salen de la misma generación— así que no hay paso de doblaje ni reajuste de tiempo después. Un guion escrito en un idioma puede interpretarse en otro; el idioma de la página en la que escribes, el idioma del guion y el idioma en el que habla el reparto son tres opciones independientes.
Donde la gente más se equivoca es con los acentos. La biblioteca está organizada por idioma —chino, inglés, cantonés— y la coincidencia se elige por género, rango de edad y manera, no por palabras de acento en una descripción; la descripción es el único lugar de donde proviene un acento. Así que un acento va en la descripción de la voz, y un idioma diferente va en la configuración del proyecto. Pedir ambas cosas en un mismo lugar hace que dos instrucciones se peleen por la misma frase.
Qué sigue cambiando una voz
Tres casos reales. Un personaje sin ajuste preestablecido: la descripción escrita hace el trabajo, lo que significa que dos tomas pueden leerse de forma ligeramente distinta; asocia un ajuste preestablecido cuando quieras la misma lectura siempre. Una frase que simplemente está mal: la voz no corrige la redacción; cambia la línea (o la nota de interpretación) y regenera. Y un clip terminado: la configuración del personaje decide los renderizados futuros, mientras que un clip que ya existe se modifica a través de Redoblar bajo el reproductor, que rehace las líneas con una voz elegida sin tocar la configuración propia del personaje —la guía para cambiar una voz lo explica paso a paso. Para los personajes que se escuchan pero nunca se ven, mantenlos marcados como fuera de plano y asígnale una voz: sus líneas siguen usándola y su rostro nunca se genera.
Qué dicen los hilos sobre voz
El tema de voz, música y sonido es uno de los más etiquetados del corpus, y la etiqueta más específica de diálogo y sincronización labial se sitúa en 2,600 — con 520 publicaciones que coinciden con las palabras clave de queja sobre labios que no encajan. La nota recurrente en los comentarios no es la tecnología; es la interpretación:
| Recuento por coincidencia de reglas | Publicaciones |
|---|---|
| Etiquetas de voz, música y sonido | 12,000 |
| Etiquetas de diálogo y sincronización labial | 2,600 |
| Palabras clave de queja sobre sincronización labial | 520 |
Dos comentarios del corpus lo ilustran bien. El primero es de un hilo sobre lo que aún le queda por avanzar a la creación cinematográfica con IA:
El doblaje con IA es el próximo gran obstáculo que debe superar.
El segundo es una reacción a una película terminada —la imagen se entiende, pero la interpretación es lo que rompe el hechizo:
Se ve hermoso, pero el diálogo es plano. Tiene una cadencia mecánica que lo arruina por completo. No hay entonación.
El primer comentario viene de una discusión en r/Filmmakers; el segundo viene de un hilo de remake en r/aivideos. La nota metodológica describe cómo se recopilaron los recuentos.
Limitaciones: casos en los que no aplica
- La coincidencia y la carga le ponen una voz a un personaje; no resuelven quién tiene permiso para usarla. Si tu producción necesita la voz de un actor específico, es un tema de licencias: la interfaz del sitio no tiene forma de comprobar que una muestra cargada sea tuya, así que la responsabilidad recae en quien la sube.
- Los acentos no están en la biblioteca. Si el acento es lo importante, escríbelo en la descripción de voz y espera que el modelo lo interprete como cualquier otra indicación.
- La coherencia de voz no garantiza la actuación. Una entrega plana es un problema del guion: reescribe la línea o su nota de interpretación en lugar de volver a coincidir la voz.
- Los datos del corpus son recuentos por reglas de palabras clave sobre la colección de 2026; muestran de qué se habla la conversación, no un ranking de resultados.
Preguntas frecuentes
¿La voz se mantiene igual entre episodios?
Sí, por la misma razón que la cara: una voz se asigna al personaje a nivel de proyecto y aparece en todos los segmentos en los que ese personaje hable, tanto en el episodio uno como en el doce.
¿Puedo subir mi propia voz?
Sí. Sube una grabación como referencia de voz de un personaje y se usará en todos los segmentos en los que hable; es una elección persistente y las coincidencias posteriores no la sobrescriben.
¿Puedo cambiar una voz después de hacer el video?
La configuración del personaje define los renders futuros. Para un clip que ya existe, está la opción Redoblar debajo del reproductor, que rehace las líneas con la voz que elijas; la configuración propia del personaje se mantiene igual.
¿El idioma del diálogo cambia la voz?
No directamente. La biblioteca de voces está organizada por idioma, y el idioma de diálogo del proyecto define en qué idioma se escriben e interpretan las líneas; el cantonés está disponible como opción solo de diálogo.
El recorrido práctico está en cómo funcionan las voces de los personajes —los tres modos, qué controla y qué no controla la voz— y personajes principales, secundarios y solo de voz cubre a los personajes que se escuchan pero nunca se dibujan. La respuesta para arreglar tomas únicas entra en acción cuando una interpretación entregada necesita cambios.
Asigna la voz una sola vez
Sube un guion, coincide o sube la voz de cada personaje y escucha una línea interpretada antes de gastar nada: el habla va incluida en el precio del video, sin cargo de audio separado.
Regístrate gratisEl habla está incluida en el precio del video: no hay cargo de audio separado. Las tarifas están en la página de precios con los mismos números.
Precios·Guías·Ejemplos·Alternativas·Respuestas·Soporte·Privacidad·Términos·Aviso legal·Contacto·Programa de afiliados·© 2026 SceneMixer