Antworten · Ablauf
Wie entstehen KI-Videos?
Aktualisiert 18. November 2026

Warum Leute immer wieder fragen
Ein überzeugendes KI-Video kann für jemanden, der nur erzeugte Standbilder kennt, unmöglich aussehen. Ein Zuschauer schrieb, nachdem man ihm gesagt hatte, ein Clip, den er bewunderte, sei KI:
Ich habe gesehen, dass manche sagen, es sei KI, aber ich kann mir nicht vorstellen, wie das mit den heutigen KI-Möglichkeiten gemacht wird
Das stammte aus einem Beitrag mit dieser Frage als Titel in r/generativeAI. Die handwerkliche Seite der Antwort ist ein großes Thema für sich: Prompts und Kameraführung machen rund 22.000 Beiträge im Korpus der Community aus. Die Kurzfassung: Es gibt zwei Ebenen – was das Modell tut und was drumherum getan wird.
Im Modell: vom Rauschen zu Bildern
Die meisten aktuellen Videomodelle lernen aus sehr großen Mengen Material, das mit Beschreibungen verknüpft ist. Zum Erzeugen beginnen sie mit zufälligem Rauschen und verfeinern es in vielen Schritten; jeder Schritt schiebt die Bilder ein Stück näher an etwas, das zur Beschreibung und zu allen gelieferten Referenzbildern passt. Das Ergebnis ist ein kurzer Clip, meist einige Sekunden bis fünfzehn oder dreißig, denn je länger der Clip, desto schwerer wird es, jedes Bild konsistent zu halten. Referenzbilder engen das Raten ein: Bei einem Bild einer Figur zeichnet das Modell genau diese Person, statt eine neue zu erfinden, die nur zu den Worten passt. Bei aktuellen Modellen werden Ton – Schritte, Regen, eine Figur, die eine Zeile spricht – im selben Durchgang erzeugt statt nachträglich hinzugefügt.
Deshalb hat ein Modell allein auch Mühe mit einer Geschichte. Es sieht jeweils eine Anfrage. Es erinnert sich nicht daran, dass der Ermittler im letzten Clip einen grauen Mantel trug, außer die nächste Anfrage zeigt ihm den Mantel.
Schritt eins: die Worte
Eine Geschichte beginnt als Skript, als Kapitel oder als eine Zeile. Auf SceneMixer wird der Text in Figuren, Orte, Requisiten und Folgen eingelesen, jede Folge mit einer Gliederung. Das ist der günstigste Schritt und der, der am meisten entscheidet.
Schritt zwei: die Referenzen
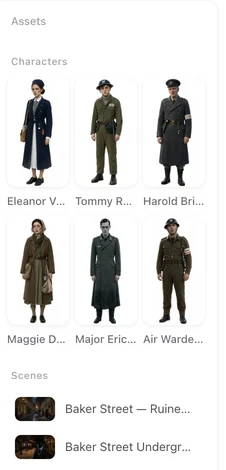
Jede Figur bekommt ein Ganzkörper-Referenzblatt und jeder Ort ein Bild, gezeichnet im visuellen Stil, der am Anfang gewählt wurde. Das ist das Gedächtnis, das dem Modell fehlt: Gesichts- und Körperausschnitte aus einem Blatt werden an jedes Segment angehängt, in dem diese Figur auftaucht.
Schritt drei: die Einstellungen im Text
Jede Folge wird als Storyboard geschrieben: Ort, Zeit, das Anfangsbild, dann nummerierte Einstellungen mit ihren Sekunden, der Kamera, der Handlung und der gesprochenen Zeile. Den Text zu bearbeiten ruft kein Modell auf und kostet nichts, deshalb passiert der größte Teil der Regie hier. Eine Einstellung, die klar lesbar ist – ein Ort, eine Handlung, eine Kamera, die eines tut –, ist eine Einstellung, die das Modell zeichnen kann. Wie man eine Einstellung schreibt zeigt die Gewohnheiten, die eine geschriebene Einstellung verlässlich machen, vom Anfangsbild bis zur Länge einer Zeile.
Schritt vier: Segmente mit Ton
Ein paar Einstellungen an einem Ort werden gemeinsam als Segment erzeugt, mit den passenden Referenzbildern angehängt, und das Segment kommt schon mit seinem Ton heraus. Das nächste Segment beginnt dort, wo das letzte endete, sodass sich eine Bewegung über den Schnitt fortsetzt. Ein misslungenes Segment korrigierst du, indem du die Wörter änderst und nur dieses neu erzeugst.
Schritt fünf: Zusammenfügen und Feinschliff
Segmente werden zu einer Folge zusammengefügt, zu 1 einem Guthaben pro Sekunde der fertigen Länge, mit einer automatischen Musik, die du abschalten kannst. Ein fertiger Clip lässt sich mit Verbessern Schritt für Schritt auf bis zu 2K hochskalieren; die Datei trägt bei kostenlosen Konten ein kleines KI-Badge und eine Metadaten-Kennzeichnung. Auf SceneMixer gemessen über die 30 Tage bis zum 6. November 2026, war eine ganze Folge typischerweise 24 Minuten nach Beginn ihres ersten Segments fertig.
Grenzen der Art, wie KI-Video entsteht
- Das Material ist erfunden, nicht aufgezeichnet; nichts darin ist tatsächlich passiert.
- Ergebnisse schwanken von einer Erzeugung zur nächsten, also plane gelegentliche Neuaufnahmen ein.
- Schrift im Bild ist unzuverlässig, deshalb werden Titel nachträglich hinzugefügt.
- Konsistenz hängt von den Referenzen ab; eine Einstellung, die von Null beschrieben wird, kann trotzdem abdriften.
- Die Folgenzeit ist ein Monatsmedian von einer Seite, und die Themenzahl ist eine regelbasierte Schätzung.
FAQ
Wie werden KI-Filme gemacht?
Auf die gleiche Weise, nur länger: ein Drehbuch, Referenzblätter für die Besetzung, ein Storyboard Einstellung für Einstellung, viele Segmente und ein Zusammenfügen. Der Typ Film auf SceneMixer hebt die Folgenobergrenze auf.
Verwenden KI-Videos echtes Material?
Nein. Erzeugtes Material ist neu; Referenzbilder lenken es, aber es existiert kein aufgezeichnetes Video der Szene.
Wie lange dauert es, ein KI-Video zu machen?
Das Rendern dauert pro Segment Minuten, und Segmente laufen nebeneinander; das Schreiben und Prüfen dauert länger als das Erzeugen.
Was brauche ich, um ein KI-Video zu machen?
Eine Idee oder ein Skript, einen Look und eine einmal gezeichnete Besetzung. Ein Computer und ein Browser reichen; keine Kamera und keine Grafikkarte.
Wie funktionieren KI-Videos?
Ein Videomodell macht aus einer Textbeschreibung, oft mit Referenzbildern, einige Sekunden bewegtes Bild. Längere Videos werden als viele solcher Shots geplant und zusammengesetzt; SceneMixer ergänzt das Modell um die Schritte Skript, Besetzung und Storyboard.
Verwandt: was KI-Video ist, was es heute kann und was nicht und die Sammelmethode hinter der Themenzahl.
Folge den Schritten mit deiner eigenen Geschichte
Worte, Referenzen, Einstellungen, Segmente, Zusammenfügen. Sieh jeden Schritt, bevor du für den nächsten zahlst.
Kostenlos registrierenDie Preise pro Videosekunde stehen auf der Preisseite mit denselben Zahlen.