Antwoorden · Proces
Hoe worden AI-video's gemaakt?
Bijgewerkt 18 november 2026

Waarom mensen dit blijven vragen
Een overtuigende AI-video kan er voor iemand die alleen gegenereerde stilstaande beelden heeft gezien, onmogelijk uitzien. Een kijker schreef, nadat hem was verteld dat een clip die hij bewonderde AI was:
Ik zag dat sommige mensen zeiden dat het AI is, maar ik kan niet begrijpen hoe dit met de huidige AI-mogelijkheden is gemaakt
Dat kwam uit een bericht met die vraag als titel in r/generativeAI. De ambachtelijke kant van het antwoord is op zichzelf al een groot onderwerp: prompts en cameraregie zijn goed voor ongeveer 22.000 berichten in het communitycorpus. In het kort zijn er twee lagen: wat het model doet, en wat er omheen wordt gedaan.
Binnen het model: van ruis naar beelden
De meeste huidige videomodellen leren van zeer grote hoeveelheden beeldmateriaal met beschrijvingen. Om te genereren beginnen ze met willekeurige ruis en verfijnen die in veel stappen, waarbij elke stap de beelden dichter bij iets brengt dat past bij de beschrijving en eventuele referentiebeelden. De uitvoer is een korte clip, meestal enkele seconden tot vijftien of dertig, omdat het moeilijker wordt alle beelden consistent te houden naarmate de clip langer wordt. Referentiebeelden beperken het gissen: met een beeld van een personage tekent het model die persoon, in plaats van een nieuwe te verzinnen die alleen bij de woorden past. Bij huidige modellen wordt geluid, zoals voetstappen, regen of een personage dat een regel uitspreekt, in dezelfde ronde gegenereerd in plaats van er achteraf aan toegevoegd.
Daarom heeft een model alleen al moeite met een verhaal. Het ziet één verzoek tegelijk. Het onthoudt niet dat de rechercheur in de vorige clip een grijze jas droeg, tenzij het volgende verzoek de jas laat zien.
Stap één: de woorden
Een verhaal begint als script, hoofdstuk of één regel. Op SceneMixer wordt de tekst ingelezen tot personages, plekken, rekwisieten en afleveringen, elke aflevering met een overzicht. Dit is de goedkoopste stap en degene die het meeste beslist.
Stap twee: de referenties
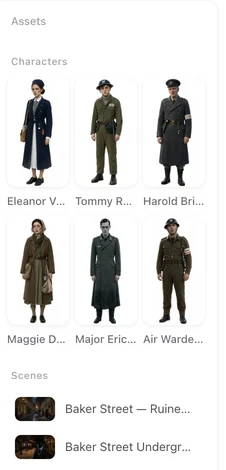
Elk personage krijgt een referentiekaart van het hele lichaam en elke plek een beeld, getekend in de visuele stijl die aan het begin is gekozen. Dit is het geheugen dat het model mist: gezichts- en lichaamsuitsnedes van een kaart worden gekoppeld aan elk segment waarin dat personage voorkomt.
Stap drie: de shots in tekst
Elke aflevering wordt geschreven als storyboard: locatie, tijd, het startbeeld, daarna genummerde shots met hun seconden, de camera, de actie en de gesproken regel. Deze tekst bewerken roept geen model aan en kost niets, dus het meeste regisseren gebeurt hier. Een shot dat helder leest (één plek, één actie, een camera die één ding doet) is een shot dat het model kan tekenen. Hoe je één shot schrijft laat de gewoonten zien die een geschreven shot betrouwbaar maken, van het startbeeld tot de lengte van een regel.
Stap vier: segmenten met geluid
Enkele shots op één plek worden samen als segment gegenereerd, met de juiste referentiebeelden erbij, en het segment komt uit met het geluid al erin. Het volgende segment begint waar het vorige eindigde, zodat een beweging over de snede heen doorloopt. Een segment dat mislukt, wordt hersteld door de woorden te veranderen en het alleen opnieuw te genereren.
Stap vijf: de samenvoeging en de afwerking
Segmenten worden samengevoegd tot één aflevering, tegen 1 credit per seconde van de afgewerkte lengte, met een automatische score die je kunt uitzetten. Een afgewerkte clip kan met Enhance stap voor stap worden verhoogd, tot 2K, en het bestand draagt op gratis accounts een klein AI-label en een metadatatag. Gemeten op SceneMixer over de 30 dagen tot 6 november 2026 was een hele aflevering meestal 24 minuten klaar nadat het eerste segment was gestart.
Beperkingen van hoe AI-video wordt gemaakt
- Het beeldmateriaal is verzonnen, niet opgenomen; er is niets in gebeurd.
- Resultaten verschillen van de ene generatie tot de volgende, dus reken op af en toe een hername.
- Letters in het beeld zijn onbetrouwbaar, dus titels komen er achteraf op.
- Consistentie hangt af van de referenties; een shot dat vanaf nul wordt beschreven, kan nog steeds verschuiven.
- De aflevertijd is een mediaan van één maand op één site, en het onderwerpgetal is een regelgebaseerde schatting.
Veelgestelde vragen
Hoe worden AI-films gemaakt?
Op dezelfde manier, maar groter: een scenario, referentiekaarten voor de cast, een shot-voor-shot-storyboard, veel segmenten en een samenvoeging. Het type Film van SceneMixer haalt de limiet op afleveringen weg.
Gebruikt AI-video echte beelden?
Nee. Gegenereerd beeldmateriaal is nieuw; referentiebeelden sturen het, maar er bestaat geen opgenomen video van de scène.
Hoe lang duurt het om een AI-video te maken?
Renderen duurt minuten per segment, en segmenten lopen naast elkaar; het schrijven en controleren duurt langer dan het genereren.
Wat heb ik nodig om een AI-video te maken?
Een idee of een script, een look, en een cast die één keer is getekend. Een computer en een browser zijn genoeg; geen camera of videokaart.
Hoe werkt AI-video?
Een videomodel zet een tekstbeschrijving, vaak met referentiebeelden, om in een paar seconden bewegend beeld. Langere video's worden gepland als veel zulke shots die aan elkaar worden gezet; SceneMixer voegt de stappen script, rolverdeling en storyboard rond het model toe.
Gerelateerd: wat AI-video is, wat het nu wel en niet kan, en de verzamelmethode achter het onderwerpgetal.
Volg de stappen met je eigen verhaal
Woorden, referenties, shots, segmenten, samenvoegen. Bekijk elke stap voordat je voor de volgende betaalt.
Gratis aanmeldenDe prijzen per seconde video staan op de prijspagina, met dezelfde cijfers.