Answers · 製作流程
AI 影片是怎麼製作的?
更新於 2026 年 11 月 18 日

人們為什麼一直在問
一段令人信服的 AI 影片,對只看過生成靜態圖的人來說,可能看起來不可思議。有位觀眾在被告知他欣賞的片段是 AI 製作後寫道:
我看到有人說這是 ai,但我無法理解用我們目前的 ai 能力要怎麼做出來
這來自 r/generativeAI 中一則以這個問題為標題的貼文。答案的技藝面本身就是一個大題目:提示詞與攝影機調度在社群語料中約佔 22,000 則貼文。簡短的說法是,有兩個層次:模型做了什麼,以及模型外圍做了什麼。
模型之內:從雜訊到畫面
目前大多數的影片模型,是從大量配有描述的影片素材中學習的。要生成時,它們從隨機雜訊開始,經過許多步驟逐步修正,每一步都把畫面推向更符合描述與所提供參考圖的樣子。輸出是一段短片,通常是數秒到十五或三十秒,因為片段愈長,要讓每一格都保持一致就愈困難。參考圖能縮小猜測的範圍:給它一張角色的圖,模型就會畫那個人,而不是憑空想出一個只是符合文字的新人物。在目前的模型中,聲音(腳步聲、雨聲、角色說出的台詞)是在同一個過程中一併生成的,而不是事後再加上去。
這也是為什麼只靠模型本身很難撐起一個故事。它一次只看一個請求。除非下一個請求把外套展示給它看,否則它不會記得偵探在上一段片段中穿的是灰色外套。
第一步:文字
故事從劇本、一個章節或一行字開始。在 SceneMixer 上,文字會被讀成角色、場景、道具與集數,每一集都有大綱。這是成本最低的一步,卻決定了最多的事。
第二步:參考
每個角色都會有一張全身參考設定圖,每個場景則有一張圖,它們都以一開始選定的視覺風格繪製。這些就是模型缺少的記憶:從設定圖切下的臉部與身體局部,會附在該角色出現的每一段上。
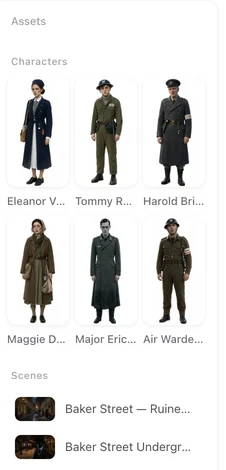
第三步:文字中的鏡頭
每一集都寫成一份分鏡:地點、時間、起始畫面,然後是編號的鏡頭,附上秒數、鏡頭、動作與台詞。編輯這些文字不會呼叫模型,也不花錢,所以大部分的導演工作都在這裡完成。一個寫得清楚的鏡頭(一個地點、一個動作、一個只做一件事的攝影機)是模型畫得出來的鏡頭;如何寫一個鏡頭 說明了讓文字鏡頭可靠的習慣,從起始畫面到台詞的長度。
第四步:帶聲音的各段
同一個地點的幾個鏡頭會被一起生成為一段,附上正確的參考圖,而生成的段落已經包含它的聲音。下一段從上一段結束的地方開始,所以動作會跨越剪接點延續下去。沒有成功的段落,只要改它的文字並單獨重新生成即可修正。
第五步:合併與完成
各段會合併成一集,成品長度依每秒 1 積分 計費,並附上一段可以關閉的自動配樂。完成的片段可以用強化一次提升一個解析度級距,最高到 2K;在免費帳號上,檔案會帶有一個小小的 AI 角標與中繼資料標籤。根據在 截至 2026 年 11 月 6 日的 30 天 期間於 SceneMixer 上的實測,一整集通常在第一段開始生成後 24 分鐘內就緒。
AI 影片製作方式的限制
- 畫面是虛構生成的,不是錄製的;其中沒有任何東西真的發生過。
- 每次生成的結果都不同,所以要預留偶爾重拍的時間。
- 畫面中的文字不可靠,所以片名要之後再加。
- 一致性取決於參考圖;從頭描述的鏡頭仍然可能走樣。
- 集數時間是來自單一網站、一個月的中位數,而主題數量則是依規則估算的。
常見問題
AI 電影是怎麼製作的?
方法相同,只是規模更大:一份劇本、演員陣容的參考設定圖、逐鏡頭的分鏡、許多段落,最後合併。SceneMixer 的電影類型取消了集數上限。
AI 影片用的是真實的影像嗎?
不是。生成的畫面是新的;參考圖會引導它,但該場景並不存在任何錄製的影片。
製作一支 AI 影片要花多久?
渲染每段大約需要幾分鐘,各段可以同時進行;寫作與檢查所花的時間,比生成還長。
製作 AI 影片需要什麼?
一個點子或一份劇本、一種風格,以及只畫一次的演員陣容。一台電腦和一個瀏覽器就夠了,不需要攝影機或顯示卡。
AI 視頻是怎麼運作的?
視頻模型會把文字描述(常常搭配參考圖)轉換成幾秒鐘的動態畫面。較長的視頻則會規劃成許多這樣的鏡頭再拼接起來;SceneMixer 則在模型前後加上劇本、角色陣容與分鏡等步驟。
相關:AI 影片是什麼、它現在能做什麼、不能做什麼,以及這個主題數字背後的收集方法。