Réponses · Fonctionnement
Comment sont fabriquées les vidéos IA ?
Mis à jour le 18 novembre 2026

Pourquoi les gens continuent de poser la question
Une vidéo IA convaincante peut paraître impossible à qui n'a vu que des images fixes générées. Un spectateur a écrit, après qu'on lui a dit qu'un clip qu'il admirait était de l'IA :
J'ai vu des gens dire que c'est de l'IA, mais je n'arrive pas à comprendre comment on fait cela avec les capacités actuelles de l'IA
Cela venait d'un message intitulé avec cette question dans r/generativeAI. Le côté savoir-faire de la réponse est un grand sujet à part entière : prompts et direction de caméra représentent environ 22 000 publications du corpus communautaire. La version courte : il y a deux couches — ce que fait le modèle, et ce qui est fait autour de lui.
À l'intérieur du modèle : du bruit aux images
La plupart des modèles vidéo actuels apprennent à partir de très grandes quantités de séquences associées à des descriptions. Pour générer, ils partent d'un bruit aléatoire et l'affinent sur de nombreuses étapes, chaque étape rapprochant les images de ce qui correspond à la description et aux images de référence fournies. Le résultat est un court clip, en général de quelques secondes à quinze ou trente, car maintenir chaque image cohérente devient plus difficile à mesure que le clip s'allonge. Les images de référence réduisent le hasard : avec une image de personnage, le modèle dessine cette personne plutôt que d'en inventer une nouvelle qui ne fait que correspondre aux mots. Sur les modèles actuels, le son — des pas, la pluie, un personnage qui dit une réplique — est généré dans le même passage plutôt qu'ajouté après coup.
C'est aussi pourquoi un modèle seul peine avec une histoire. Il voit une demande à la fois. Il ne se souvient pas que le détective portait un manteau gris dans le clip précédent, à moins que la demande suivante ne le lui montre.
Étape un : les mots
Une histoire commence par un scénario, un chapitre ou une seule ligne. Sur SceneMixer, le texte est lu en personnages, lieux, accessoires et épisodes, chaque épisode avec un plan. C'est l'étape la moins chère, et celle qui décide le plus.
Étape deux : les références
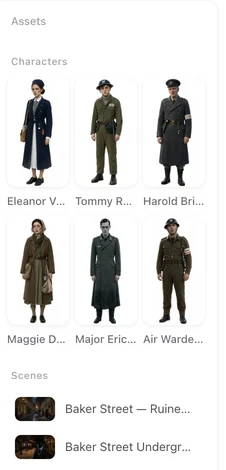
Chaque personnage reçoit une feuille de référence en pied, et chaque lieu une image, dans le style visuel choisi au départ. Ce sont la mémoire qui manque au modèle : des recadrages du visage et du corps d'une feuille sont rattachés à chaque segment où le personnage apparaît.
Étape trois : les plans en texte
Chaque épisode s'écrit comme un découpage : lieu, moment, image de départ, puis des plans numérotés avec leurs secondes, la caméra, l'action et la réplique parlée. Modifier ce texte n'appelle aucun modèle et ne coûte rien ; c'est donc là que se fait l'essentiel de la mise en scène. Un plan lisible — un lieu, une action, une caméra qui fait une seule chose — est un plan que le modèle peut dessiner ; Comment écrire un plan présente les habitudes qui rendent un plan écrit fiable, de l'image de départ à la longueur d'une réplique.
Étape quatre : des segments avec le son
Quelques plans dans un même lieu sont générés ensemble comme un segment, avec les bonnes images de référence rattachées, et le segment sort avec son son déjà intégré. Le segment suivant commence là où le précédent s'est arrêté, si bien qu'un mouvement traverse la coupe. Un segment raté se corrige en changeant ses mots et en le régénérant seul.
Étape cinq : l'assemblage et la finition
Les segments sont assemblés en un seul épisode, au prix de 1 crédit par seconde de la durée finale, avec une musique automatique qu'on peut désactiver. Un clip fini peut être relevé d'un cran de résolution à la fois avec Améliorer, jusqu'à 2K, et le fichier porte un petit badge IA et une étiquette de métadonnées sur les comptes gratuits. Mesuré sur SceneMixer sur les 30 jours jusqu'au 6 novembre 2026, un épisode complet était généralement prêt 24 minutes après le début de son premier segment.
Limites de la façon dont la vidéo IA est fabriquée
- Les images sont inventées, non enregistrées ; rien de ce qu'on y voit ne s'est produit.
- Les résultats varient d'une génération à l'autre ; prévoyez donc une reprise de temps en temps.
- Le texte dans l'image n'est pas fiable ; les titres s'ajoutent donc après coup.
- La cohérence dépend des références ; un plan décrit de zéro peut encore dériver.
- La durée d'un épisode est une médiane d'un mois sur un seul site, et le décompte par sujet est une estimation par règles.
FAQ
Comment sont fabriqués les films IA ?
De la même façon, sur une plus grande longueur : un scénario, des feuilles de référence pour le casting, un découpage plan par plan, de nombreux segments et un assemblage. Le type Film de SceneMixer lève le plafond d'épisode.
Les vidéos IA utilisent-elles de vraies images ?
Non. Les images générées sont nouvelles ; des images de référence les guident, mais aucune vidéo enregistrée de la scène n'existe.
Combien de temps faut-il pour faire une vidéo IA ?
Le rendu prend quelques minutes par segment, et les segments tournent en parallèle ; l'écriture et la vérification prennent plus de temps que la génération.
De quoi ai-je besoin pour faire une vidéo IA ?
Une idée ou un scénario, un style et un casting dessiné une fois. Un ordinateur et un navigateur suffisent ; ni caméra ni carte graphique.
Comment fonctionne la vidéo IA ?
Un modèle vidéo transforme une description textuelle, souvent accompagnée d'images de référence, en quelques secondes d'images animées. Les vidéos plus longues sont planifiées comme une succession de tels plans, puis assemblées ; SceneMixer ajoute les étapes de scénario, de casting et de storyboard autour du modèle.
À lire aussi : ce qu'est la vidéo IA, ce qu'elle peut et ne peut pas encore faire, et la méthode de collecte derrière le décompte par sujet.
Suivez les étapes sur votre propre histoire
Mots, références, plans, segments, assemblage. Voyez chaque étape avant de payer la suivante.
Inscription gratuiteLes tarifs par seconde de vidéo sont sur la page tarifs, avec les mêmes chiffres.