回答 · 制作の流れ
AI動画はどのように作られるか?
2026年11月18日更新

人々がなぜ尋ね続けるのか
生成された静止画しか見たことがない人には、説得力のあるAI動画は不可能に見えることがあります。ある視聴者は、自分が感心していたクリップがAIだと聞かされた後にこう書きました:
AIだと言っている人を見かけたけど、現在のAIの能力でこれがどう作られているのか、まったく理解できない
これはr/generativeAIで、この質問をタイトルにした投稿から来たものです。答えの技術面は、それ自体で大きなテーマです。プロンプトとカメラの指示だけで、コミュニティの投稿の約22,000件を占めます。要点を言えば、二つの層があります。モデルが何をするか、そして、モデルの周りで何がされるか。
モデルの内側:ノイズからフレームへ
現在の多くの動画モデルは、説明と組になった非常に大量の映像から学習しています。生成するときは、ランダムなノイズから始め、多くのステップで磨き上げます。各ステップは、フレームを説明と与えられた参考画像に合うものへ少しずつ近づけます。出力は短いクリップで、通常は数秒から15秒か30秒です。クリップが長くなるほど、すべてのフレームを一貫させることが難しくなるからです。参考画像は推測の幅を狭めます。キャラクターの画像が与えられると、モデルは言葉に合うだけの新しい人物を作るのではなく、その人物を描きます。現在のモデルでは、音、たとえば足音、雨、台詞を話すキャラクターの声は、後から足されるのではなく、同じ生成の中で作られます。
だからこそ、モデル単独では物語に苦労します。モデルは一度に一つの要望しか見ません。次の要望が、探偵が灰色のコートを着ていたことを示さない限り、前のクリップでそのコートを着ていたことは覚えていません。
ステップ1:言葉
物語は、脚本、章、または一行として始まります。SceneMixerでは、テキストがキャラクター、場所、小道具、そしてエピソードに読み込まれ、各エピソードには概要が付きます。これは最も安いステップであり、最も多くを決めるステップです。
ステップ2:参照
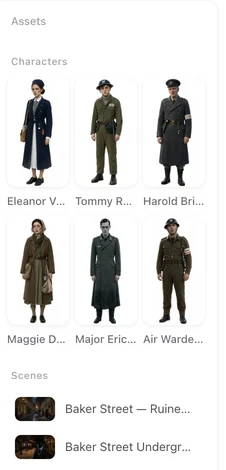
各キャラクターには全身の参照シートが、各場所には画像が与えられ、どちらも開始時に選んだビジュアルスタイルで描かれます。これらはモデルに欠けている記憶です。シートから切り出した顔と体が、そのキャラクターが登場するすべてのセグメントに添付されます。
ステップ3:テキストでのカット
すべてのエピソードは絵コンテとして書かれます。場所、時間、開始フレーム、そして番号付きのカットに、その秒数、カメラ、アクション、台詞が続きます。この文章の編集はモデルを呼び出さず、費用もかからないので、演出の大部分はここで行われます。はっきりと読めるカット(一つの場所、一つのアクション、一つのことだけをするカメラ)は、モデルが描けるカットです。一つのカットの書き方では、開始フレームから台詞の長さまで、書かれたカットを確実にする習慣を示しています。
ステップ4:音付きのセグメント
一つの場所の数カットが、適切な参照画像を添えて一緒にセグメントとして生成され、そのセグメントは音が入った状態で出てきます。次のセグメントは前のセグメントが終わったところから始まるので、動きはカットをまたいで続きます。外れたセグメントは、文章を変えてそのセグメントだけを再生成することで直します。
ステップ5:結合と仕上げ
セグメントは一つのエピソードに結合されます。完成した長さの1秒ごとに1クレジットで、オフにできる自動のスコアが付きます。完成したクリップは、エンハンスで2Kまで一段ずつ鮮明さを上げられ、無料アカウントのファイルには、小さなAIバッジとメタデータタグが付きます。SceneMixerで2026年11月6日までの30日間の期間を計測したところ、エピソード全体は、最初のセグメントが始まってから通常24分で準備できました。
AI動画の作られ方の制限
- 映像は録画されたものではなく、創作されたものです。映っている出来事は起きていません。
- 結果は生成ごとに変わるので、たまに撮り直しが必要になることを見込みましょう。
- 画面内の文字は確実には描かれないので、タイトルは後から付けます。
- 一貫性は参照に依存します。ゼロから説明されたカットは、それでも外れることがあります。
- エピソードの時間は一つのサイトでの一か月の中央値で、トピック数はルールに基づく推計です。
よくある質問
AIの映画はどのように作られますか?
同じ方法を、より長く行います。脚本、キャストの参照シート、カットごとの絵コンテ、多数のセグメント、そして結合です。SceneMixerの映画タイプは、エピソードの上限をなくします。
AI動画は実写の映像を使っていますか?
いいえ。生成された映像は新しいものです。参照画像が導きますが、そのシーンの録画された映像は存在しません。
AI動画を作るのにどのくらい時間がかかりますか?
レンダリングはセグメントごとに数分で、セグメントは並行して進みます。執筆と確認には、生成よりも時間がかかります。
AI動画を作るには何が必要ですか?
アイデアか脚本、見た目、一度描いたキャスト。パソコンとブラウザがあれば十分で、カメラもグラフィックボードも必要ありません。
AI動画はどのように作られますか?
動画モデルは、テキストによる説明を、参照画像を添えることも多いですが、数秒分の動く映像に変換します。長い動画は、そのようなカットを多数計画してつなぎ合わせて作られます。SceneMixerは、そのモデルの前後に台本、キャスト、絵コンテの工程を加えます。
関連:AI動画とは何か、今できること、できないこと、そしてトピック数の背景にある収集方法。