Jawaban · Proses
Bagaimana Video AI Dibuat?
Diperbarui 18 November 2026

Mengapa orang terus bertanya
Video AI yang meyakinkan bisa tampak mustahil bagi seseorang yang hanya pernah melihat gambar diam hasil generasi. Seorang penonton menulis, setelah diberi tahu bahwa klip yang ia kagumi adalah AI:
Saya melihat beberapa orang bilang ini AI, tetapi saya tidak bisa memahami bagaimana ini dibuat dengan kemampuan AI yang ada sekarang
Itu berasal dari sebuah postingan berjudul pertanyaan itu di r/generativeAI. Sisi kerajinan dari jawabannya adalah topik besar tersendiri: prompt dan arahan kamera menyumbang sekitar 22.000 postingan di korpus komunitas. Versi singkatnya adalah ada dua lapisan: apa yang dilakukan model, dan apa yang dilakukan di sekitarnya.
Di dalam model: dari derau ke bingkai
Sebagian besar model video saat ini belajar dari footage dalam jumlah sangat besar yang dipasangkan dengan deskripsi. Untuk menghasilkan, mereka mulai dari derau acak dan memperhalusnya selama banyak langkah, dengan setiap langkah mendorong bingkai agar lebih mendekati sesuatu yang cocok dengan deskripsi dan gambar referensi yang diberikan. Hasilnya adalah klip pendek, biasanya beberapa detik hingga lima belas atau tiga puluh, karena menjaga setiap bingkai tetap konsisten menjadi lebih sulit seiring klip makin panjang. Gambar referensi mempersempit tebakan: dengan gambar karakter, model menggambar orang itu alih-alih menciptakan yang baru yang sekadar cocok dengan kata-katanya. Pada model saat ini, suara, seperti langkah kaki, hujan, atau karakter yang mengucapkan baris, dihasilkan dalam proses yang sama, bukan ditambahkan setelahnya.
Itulah juga sebabnya model saja kesulitan dengan sebuah cerita. Ia melihat satu permintaan dalam satu waktu. Ia tidak ingat bahwa detektif itu memakai mantel abu-abu di klip terakhir kecuali permintaan berikutnya menunjukkan mantelnya kepadanya.
Langkah satu: kata-katanya
Sebuah cerita dimulai sebagai naskah, bab, atau satu baris. Di SceneMixer teks dibaca menjadi karakter, tempat, properti, dan episode, dengan setiap episode punya kerangka. Ini langkah termurah dan langkah yang paling banyak menentukan.
Langkah dua: referensinya
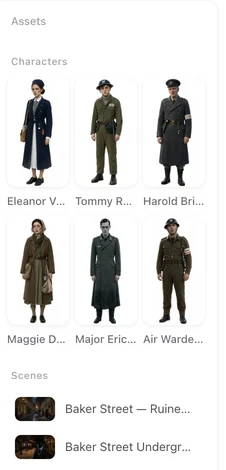
Setiap karakter mendapat lembar referensi seluruh badan dan setiap tempat mendapat gambar, digambar dalam gaya visual yang dipilih di awal. Inilah memori yang tidak dimiliki model: potongan wajah dan tubuh dari sebuah lembar dilampirkan ke setiap segmen tempat karakter itu muncul.
Langkah tiga: shot dalam teks
Setiap episode ditulis sebagai storyboard: lokasi, waktu, bingkai awal, lalu shot bernomor beserta detiknya, kameranya, aksinya, dan baris yang diucapkan. Menyunting teks ini tidak memanggil model dan tidak memakan biaya, jadi sebagian besar pengarahan terjadi di sini. Shot yang terbaca jelas, yaitu satu tempat, satu aksi, dan kamera yang melakukan satu hal, adalah shot yang bisa digambar model; Cara menulis satu shot menunjukkan kebiasaan yang membuat shot tertulis bisa diandalkan, dari bingkai awal sampai panjang sebuah baris.
Langkah empat: segmen dengan suara
Beberapa shot di satu tempat dihasilkan bersama sebagai satu segmen, dengan gambar referensi yang tepat terlampir, dan segmen itu keluar dengan suaranya sudah ada di dalamnya. Segmen berikutnya dimulai di tempat segmen terakhir berakhir, sehingga gerakan terbawa melewati potongan. Segmen yang meleset diperbaiki dengan mengubah katanya dan meregenerasinya sendiri.
Langkah lima: penyambungan dan penyelesaian
Segmen disambung menjadi satu episode, dengan biaya 1 kredit per detik dari panjang jadinya, dengan musik otomatis yang bisa dimatikan. Klip jadi bisa dinaikkan satu langkah resolusi sekali jalan dengan Enhance, hingga 2K, dan filenya membawa lencana AI kecil serta tag metadata pada akun gratis. Diukur di SceneMixer selama 30 hari hingga 6 November 2026, satu episode utuh biasanya siap 24 menit setelah segmen pertamanya dimulai.
Batasan cara video AI dibuat
- Footage-nya rekaan, bukan hasil rekaman; tidak ada yang di dalamnya benar-benar terjadi.
- Hasil berbeda dari satu generasi ke generasi berikutnya, jadi rencanakan render ulang sesekali.
- Tulisan di dalam gambar tidak andal, jadi judul ditambahkan setelahnya.
- Konsistensi bergantung pada referensi; shot yang dideskripsikan dari nol tetap bisa melenceng.
- Waktu episode adalah median satu bulan dari satu situs, dan hitungan topik adalah perkiraan berbasis aturan.
FAQ
Bagaimana film AI dibuat?
Dengan cara yang sama, hanya lebih panjang: naskah, lembar referensi untuk pemeran, storyboard shot demi shot, banyak segmen, dan penyambungan. Tipe Film di SceneMixer menghapus batas episode.
Apakah video AI memakai footage sungguhan?
Tidak. Footage yang dihasilkan itu baru; gambar referensi memandunya, tetapi tidak ada video rekaman dari adegan itu.
Berapa lama membuat video AI?
Merender memakan menit per segmen, dan segmen dijalankan berdampingan; menulis dan memeriksa lebih lama daripada menghasilkan.
Apa yang saya butuhkan untuk membuat video AI?
Sebuah ide atau naskah, sebuah tampilan, dan pemeran yang digambar sekali. Komputer dan browser sudah cukup; tidak perlu kamera atau kartu grafis.
Bagaimana cara kerja video AI?
Model video mengubah deskripsi teks, sering kali dengan gambar referensi, menjadi beberapa detik gambar bergerak. Video yang lebih panjang direncanakan sebagai banyak shot seperti ini lalu digabungkan; SceneMixer menambahkan langkah naskah, pemeran, dan storyboard di sekitar model.
Terkait: apa itu video AI, apa yang bisa dan belum bisa dilakukannya, dan metode pengumpulan di balik hitungan topik itu.
Ikuti langkah-langkahnya dengan cerita Anda sendiri
Kata-kata, referensi, shot, segmen, sambungan. Lihat setiap langkah sebelum membayar yang berikutnya.
Daftar gratisTarif video per detik ada di halaman harga dengan angka yang sama.