답변 · 제작 과정
AI 영상은 어떻게 만들어질까요?
2026년 11월 18일 업데이트

사람들이 계속 묻는 이유
그럴듯한 AI 영상은 정지 이미지만 봐 온 사람에게는 불가능해 보일 수 있습니다. 한 시청자는 자기가 감탄한 클립이 AI로 만들어졌다는 말을 듣고 이렇게 썼습니다:
어떤 사람들은 이게 AI라고 하던데, 지금의 AI 기술로 이게 어떻게 만들어지는지 도무지 이해가 안 돼요
이 글은 r/generativeAI에 질문을 제목으로 올린 글에서 나왔습니다. 답의 제작 측면은 그 자체로 큰 주제입니다. 프롬프트와 카메라 연출 관련 글만 커뮤니티 자료에서 약 22,000개입니다. 짧게 말하면 두 층이 있습니다. 모델이 하는 일, 그리고 모델 바깥에서 하는 일입니다.
모델 안에서: 노이즈에서 프레임으로
요즘 대부분의 영상 모델은 설명이 붙은 아주 많은 영상 자료로 학습합니다. 생성할 때는 무작위 노이즈에서 시작해 여러 단계에 걸쳐 다듬습니다. 각 단계마다 프레임이 설명과 제공된 참조 이미지에 맞는 쪽으로 조금씩 움직입니다. 결과물은 보통 몇 초에서 15~30초 정도의 짧은 클립입니다. 클립이 길어질수록 모든 프레임을 일관되게 유지하기가 어려워지기 때문입니다. 참조 이미지는 추측의 폭을 좁힙니다. 캐릭터 그림을 주면 모델은 말에 어울리기만 하는 새 인물을 지어내지 않고 그 사람을 그립니다. 최신 모델에서는 발소리, 빗소리, 대사를 하는 캐릭터의 목소리 같은 소리도 나중에 덧붙이는 것이 아니라 같은 과정에서 함께 생성됩니다.
그래서 모델만으로는 이야기를 만들기 어렵습니다. 모델은 한 번에 요청 하나만 봅니다. 다음 요청에서 코트를 보여 주지 않는 한, 지난 클립에서 형사가 회색 코트를 입었다는 것을 기억하지 못합니다.
1단계: 말
이야기는 대본, 한 챕터, 혹은 한 줄에서 시작합니다. SceneMixer에서는 이 텍스트를 읽어 캐릭터, 장소, 소품, 에피소드로 나누고, 각 에피소드에 개요를 붙입니다. 이 단계가 가장 저렴하고 가장 많은 것을 결정하는 단계입니다.
2단계: 참조
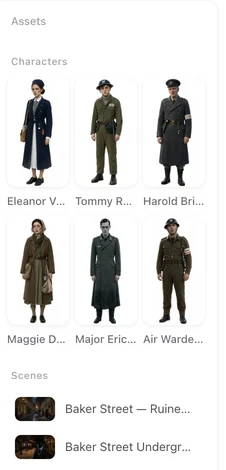
각 캐릭터에는 전신 참조 시트가, 각 장소에는 이미지가 생깁니다. 처음에 고른 시각 스타일로 그려집니다. 이것이 모델에 없는 기억입니다. 시트에서 잘라낸 얼굴과 몸의 일부가 그 캐릭터가 나오는 모든 세그먼트에 첨부됩니다.
3단계: 텍스트로 된 컷
모든 에피소드는 콘티로 씁니다. 장소, 시간, 시작 프레임, 그다음 번호가 붙은 컷과 각 컷의 초, 카메라, 행동, 대사가 들어갑니다. 이 텍스트를 고치는 데는 모델을 호출하지 않으니 비용이 들지 않습니다. 그래서 연출의 대부분이 여기서 일어납니다. 한 장소, 한 행동, 한 가지 일만 하는 카메라처럼 읽기 분명한 컷은 모델이 그릴 수 있는 컷입니다. 컷 하나를 쓰는 법에서는 시작 프레임부터 대사 길이까지, 쓴 컷을 믿을 만하게 만드는 습관을 보여 줍니다.
4단계: 소리가 들어간 세그먼트
한 장소의 컷 몇 개를 세그먼트 하나로 함께 생성하며, 맞는 참조 이미지를 첨부합니다. 세그먼트는 소리가 이미 들어간 상태로 나옵니다. 다음 세그먼트는 앞 세그먼트가 끝난 지점에서 시작하므로, 움직임이 컷을 넘어 이어집니다. 실패한 세그먼트는 말을 고쳐 그 세그먼트만 다시 생성해 고칩니다.
5단계: 이어붙이기와 마무리
세그먼트는 한 에피소드로 이어 붙여지며, 완성된 길이 1초당 1 크레딧이 듭니다. 자동 배경음악은 끌 수 있습니다. 완성된 클립은 Enhance로 한 번에 한 단계씩 2K까지 올릴 수 있습니다. 무료 계정의 파일에는 작은 AI 배지와 메타데이터 태그가 붙습니다. SceneMixer에서 2026년 11월 6일까지의 30일에 걸쳐 측정한 결과, 에피소드 전체는 보통 첫 세그먼트가 시작되고 24분 뒤에 준비되었습니다.
AI 영상 제작 방식의 한계
- 영상은 녹화된 것이 아니라 지어낸 것입니다. 그 안에서 실제로 일어난 일은 없습니다.
- 생성할 때마다 결과가 달라지므로, 가끔 다시 찍는 것을 계획에 넣으세요.
- 화면 안의 글자는 믿을 만하게 나오지 않으므로, 제목은 나중에 넣습니다.
- 일관성은 참조에 달려 있습니다. 처음부터 설명한 컷은 여전히 흔들릴 수 있습니다.
- 에피소드 시간은 한 사이트의 한 달 중앙값이고, 주제 개수는 규칙 기반 추정치입니다.
자주 묻는 질문
AI 영화는 어떻게 만들까요?
같은 방식이지만 더 길게 만듭니다. 시나리오, 출연진의 참조 시트, 컷별 콘티, 많은 세그먼트, 이어붙이기입니다. SceneMixer의 영화 유형은 에피소드 길이 제한을 없앱니다.
AI 영상은 실제 영상을 쓰나요?
아니요. 생성된 영상은 새로 만들어진 것입니다. 참조 이미지가 방향을 잡아 주지만, 그 장면을 실제로 녹화한 영상은 존재하지 않습니다.
AI 영상을 만드는 데 얼마나 걸리나요?
렌더링은 세그먼트당 몇 분이 걸리고, 세그먼트는 나란히 동시에 처리됩니다. 글쓰기와 확인에 드는 시간이 생성 시간보다 더 깁니다.
AI 영상을 만들려면 무엇이 필요한가요?
아이디어 또는 대본, 화풍, 한 번 그린 출연진이면 됩니다. 컴퓨터와 브라우저면 충분하며, 카메라나 그래픽카드는 필요 없습니다.
AI 영상은 어떻게 작동하나요?
영상 모델은 텍스트 설명을, 종종 참조 이미지와 함께, 몇 초짜리 움직이는 화면으로 바꿉니다. 더 긴 영상은 이런 컷 여러 개를 계획해 이어 붙입니다. SceneMixer는 그 모델 주변에 대본, 출연진, 스토리보드 단계를 더합니다.
관련 글: AI 영상이란 무엇인지, 지금 할 수 있는 것과 할 수 없는 것, 그리고 주제 개수 뒤의 수집 방법.