Respuestas · Proceso
¿Cómo se hacen los vídeos de IA?
Actualizado el 18 de noviembre de 2026

Por qué la gente sigue preguntando
Un vídeo de IA convincente puede parecer imposible a quien solo ha visto imágenes fijas generadas. Un espectador escribió, tras saber que un clip que admiraba era de IA:
Vi a algunas personas decir que es ai, pero no logro entender cómo se hace esto con las capacidades de IA actuales
Eso salió de una publicación con esa pregunta en r/generativeAI. La parte artesanal de la respuesta es un tema amplio por sí mismo: los prompts y la dirección de cámara suman unas 22.000 publicaciones del corpus de la comunidad. La versión corta es que hay dos capas: lo que hace el modelo y lo que se hace alrededor.
Dentro del modelo: del ruido a los fotogramas
La mayoría de los modelos de vídeo actuales aprenden de grandes cantidades de metraje emparejado con descripciones. Para generar, parten de ruido aleatorio y lo refinan en muchos pasos, empujando cada vez los fotogramas hacia algo que encaje con la descripción y con las imágenes de referencia que se aporten. El resultado es un clip corto, normalmente de unos segundos a quince o treinta, porque mantener todos los fotogramas coherentes se hace más difícil cuanto más dura el clip. Las imágenes de referencia reducen las conjeturas: dada la imagen de un personaje, el modelo dibuja a esa persona en lugar de inventar una nueva que solo encaje con las palabras. En los modelos actuales, el sonido (pasos, lluvia, un personaje que dice una frase) se genera en la misma pasada en lugar de añadirse después.
Por eso un modelo solo tiene dificultades con una historia. Ve una petición cada vez. No recuerda que el detective llevaba un abrigo gris en el clip anterior, a menos que la siguiente petición se lo muestre de nuevo.
Paso uno: las palabras
Una historia empieza como un guion, un capítulo o una sola línea. En SceneMixer el texto se convierte en personajes, lugares, objetos y episodios, cada episodio con un esquema. Es el paso más barato y el que más decide.
Paso dos: las referencias
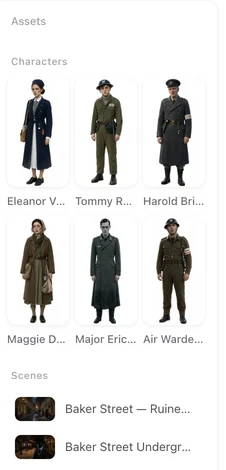
Cada personaje recibe una ficha de referencia de cuerpo entero y cada lugar una imagen, dibujadas en el estilo visual elegido al principio. Esta es la memoria que el modelo no tiene: recortes de cara y cuerpo de una ficha se adjuntan a cada segmento en el que aparece ese personaje.
Paso tres: los planos en texto
Cada episodio se escribe como un storyboard: lugar, hora, el fotograma inicial y después los planos numerados con sus segundos, la cámara, la acción y la línea hablada. Editar este texto no llama a ningún modelo y no cuesta nada, así que buena parte de la dirección ocurre aquí. Un plano que se lee con claridad (un lugar, una acción, una cámara que hace una sola cosa) es un plano que el modelo puede dibujar; Cómo escribir un plano muestra los hábitos que hacen fiable un plano escrito, desde el fotograma inicial hasta la duración de una línea.
Paso cuatro: segmentos con sonido
Unos cuantos planos en un mismo lugar se generan juntos como un segmento, con las imágenes de referencia adecuadas adjuntas, y el segmento sale con su sonido ya incluido. El siguiente segmento empieza donde terminó el anterior, así que un movimiento atraviesa el corte. Un segmento que falla se corrige cambiando sus palabras y regenerándolo solo.
Paso cinco: la unión y el acabado
Los segmentos se unen en un episodio, a 1 crédito por segundo de la duración final, con una banda sonora automática que puedes desactivar. Un clip terminado puede subir un nivel de resolución cada vez con Enhance, hasta 2K, y el archivo lleva una pequeña insignia de IA y una etiqueta de metadatos en las cuentas gratuitas. Medido en SceneMixer durante los 30 días hasta el 6 de noviembre de 2026, un episodio completo estaba listo, por lo general, 24 minutos después de que empezara su primer segmento.
Límites de cómo se hace el vídeo de IA
- El material es inventado, no grabado; nada de lo que aparece ha ocurrido.
- Los resultados varían de una generación a otra, así que prevé alguna repetición ocasional.
- Las letras dentro de la imagen no son fiables, así que los títulos se añaden después.
- La coherencia depende de las referencias; un plano descrito desde cero aún puede desviarse.
- El tiempo de episodio es una mediana de un mes de un solo sitio, y el recuento de temas es una estimación basada en reglas.
Preguntas frecuentes
¿Cómo se hacen las películas de IA?
Igual, pero a mayor escala: un guion, fichas de referencia para el reparto, un storyboard plano a plano, muchos segmentos y una unión. El tipo Film de SceneMixer quita el límite de episodios.
¿Los vídeos de IA usan metraje real?
No. El material generado es nuevo; las imágenes de referencia lo guían, pero no existe ningún vídeo grabado de la escena.
¿Cuánto tarda hacer un vídeo de IA?
El renderizado tarda minutos por segmento, y los segmentos se procesan en paralelo; la escritura y la revisión llevan más tiempo que la generación.
¿Qué necesito para hacer un vídeo de IA?
Una idea o un guion, un estilo y un reparto dibujado una vez. Basta con un ordenador y un navegador; no hace falta cámara ni tarjeta gráfica.
¿Cómo funciona el vídeo de IA?
Un modelo de vídeo convierte una descripción de texto, a menudo con imágenes de referencia, en unos segundos de imagen en movimiento. Los vídeos más largos se planifican como muchos de esos planos y se unen; SceneMixer añade en torno al modelo los pasos de guion, reparto y storyboard.
Relacionado: qué es el vídeo de IA, qué puede y qué no puede hacer todavía, y el método de recogida detrás del recuento de temas.
Sigue los pasos con tu propia historia
Palabras, referencias, planos, segmentos, unión. Mira cada paso antes de pagar el siguiente.
Regístrate gratisLas tarifas por segundo de vídeo están en la página de precios con las mismas cifras.