Respostas · Processo
Como são feitos os vídeos com IA?
Atualizado em 18 de novembro de 2026

Por que as pessoas continuam perguntando
Um vídeo convincente com IA pode parecer impossível para quem só viu imagens estáticas geradas. Um espectador escreveu, depois de saber que um clipe que ele admirava era de IA:
Vi algumas pessoas dizendo que é IA, mas não consigo entender como isso é feito com as capacidades atuais de IA
Isso veio de um post com a pergunta como título no r/generativeAI. O lado prático da resposta é um assunto grande por si só: prompts e direção de câmera respondem por cerca de 22.000 posts no acervo da comunidade. A versão curta é que há duas camadas: o que o modelo faz e o que é feito em volta dele.
Dentro do modelo: do ruído aos quadros
A maioria dos modelos de vídeo atuais aprende com grandes quantidades de filmagens pareadas com descrições. Para gerar, eles começam com ruído aleatório e o refinam ao longo de muitos passos; cada passo aproxima os quadros de algo que se encaixe na descrição e nas imagens de referência fornecidas. O resultado é um clipe curto, normalmente de poucos segundos a quinze ou trinta, porque manter todos os quadros consistentes fica mais difícil quanto mais longo é o clipe. As imagens de referência reduzem o chute: dada a imagem de um personagem, o modelo desenha aquela pessoa, em vez de inventar outra que apenas combine com as palavras. Nos modelos atuais, o som (passos, chuva, um personagem falando uma fala) é gerado na mesma passagem, em vez de acrescentado depois.
É também por isso que um modelo sozinho tem dificuldade com uma história. Ele vê um pedido de cada vez. Não lembra que a detetive usava um casaco cinza no clipe anterior, a menos que o pedido seguinte lhe mostre o casaco.
Primeiro passo: as palavras
Uma história começa como roteiro, capítulo ou uma linha. No SceneMixer, o texto é lido em personagens, lugares, objetos e episódios, cada episódio com um esboço. Esta é a etapa mais barata e a que mais decide.
Segundo passo: as referências
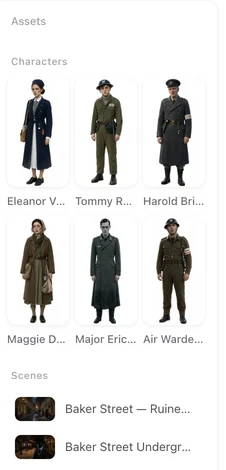
Cada personagem recebe uma ficha de referência de corpo inteiro, e cada lugar, uma imagem, desenhadas no estilo visual escolhido no início. Essa é a memória que o modelo não tem: recortes de rosto e corpo de uma ficha são anexados a todo segmento em que aquele personagem aparece.
Terceiro passo: os planos em texto
Cada episódio é escrito como um storyboard: local, hora, o quadro inicial e então planos numerados com seus segundos, a câmera, a ação e a fala. Editar esse texto não chama nenhum modelo e não custa nada, então boa parte da direção acontece aqui. Um plano que se lê com clareza (um lugar, uma ação, uma câmera que faz uma coisa) é um plano que o modelo consegue desenhar; Como escrever um plano mostra os hábitos que tornam um plano escrito confiável, do quadro inicial ao tamanho de cada fala.
Quarto passo: segmentos com som
Alguns planos num mesmo lugar são gerados juntos como um segmento, com as imagens de referência certas anexadas, e o segmento sai com o som já incluído. O segmento seguinte começa onde o anterior terminou, então um movimento atravessa o corte. Um segmento que erra é corrigido mudando as palavras dele e regenerando-o sozinho.
Quinto passo: a união e o acabamento
Os segmentos são unidos em um episódio, a 1 crédito por segundo da duração final, com uma trilha automática que pode ser desligada. Um clipe pronto pode ser elevado um passo de resolução por vez com o Enhance, até 2K, e o arquivo traz um pequeno selo de IA e uma etiqueta de metadados nas contas gratuitas. Medido no SceneMixer ao longo de os 30 dias até 6 de novembro de 2026, um episódio inteiro ficou pronto, tipicamente, 24 minutos depois do início do seu primeiro segmento.
Limitações de como o vídeo com IA é feito
- As imagens são inventadas, não gravadas; nada do que aparece aconteceu.
- Os resultados variam de uma geração para a outra, então conte com uma refilmagem ocasional.
- Letreiros dentro da imagem são pouco confiáveis, então os títulos entram depois.
- A consistência depende das referências; um plano descrito do zero ainda pode se desviar.
- O tempo de episódio é uma mediana de um mês de um só site, e a contagem de temas é uma estimativa baseada em regras.
Perguntas frequentes
Como são feitos os filmes com IA?
Do mesmo jeito, só que em maior escala: um roteiro, fichas de referência para o elenco, um storyboard plano a plano, muitos segmentos e uma união. O tipo Film do SceneMixer remove o limite de episódio.
Vídeos com IA usam imagens reais?
Não. As imagens geradas são novas; as imagens de referência orientam a geração, mas não existe vídeo gravado da cena.
Quanto tempo leva para fazer um vídeo com IA?
A renderização leva minutos por segmento, e os segmentos rodam lado a lado; a escrita e a conferência demoram mais do que a geração.
O que eu preciso para fazer um vídeo com IA?
Uma ideia ou um roteiro, um visual e um elenco desenhado uma vez. Um computador e um navegador bastam; não é preciso câmera nem placa de vídeo.
Como funciona o vídeo com IA?
Um modelo de vídeo transforma uma descrição em texto, muitas vezes com imagens de referência, em alguns segundos de imagem em movimento. Vídeos mais longos são planejados como vários desses planos e unidos; o SceneMixer acrescenta as etapas de roteiro, elenco e storyboard em torno do modelo.
Relacionados: o que é um vídeo com IA, o que ele já consegue e não consegue fazer, e o método de coleta por trás da contagem de temas.
Siga os passos com a sua própria história
Palavras, referências, planos, segmentos, união. Veja cada passo antes de pagar pelo próximo.
Cadastre-se grátisOs valores por segundo de vídeo estão na página de preços, com os mesmos números.