Schreibe Richtungsangaben, keine Namen: So verweist du auf Personen außerhalb des Bildes bei Ein-Personen-Aufnahmen

Öffne ein Segment, suche eine Aufnahme mit nur einer Person im Bild und lies ihren Text: Jeder Name einer anderen Figur darin ist ein Risiko; ersetze ihn durch eine Richtungsangabe und generiere neu.
Warum es riskant ist, eine Person außerhalb des Bildes beim Namen zu nennen
Die Modelle zeichnen, was benannt wird. Ein Name im Text wird mit dem Charakterbogen dieser Figur abgeglichen, und dieser Bogen übt einen starken Sog aus; bei einer Ein-Personen-Aufnahme wirkt dieser Sog auf die einzige verfügbare Person, sodass Gesichtszüge verschmelzen oder eine zweite Figur erfunden wird. Richtungsangaben transportieren die gleiche Inszenierungsinformation ohne diesen Sog. Wer in der Aufnahme zu sehen ist, bestimmt die Liste der Personen im Bild – der Text sollte damit übereinstimmen: Wer ist im Bild.
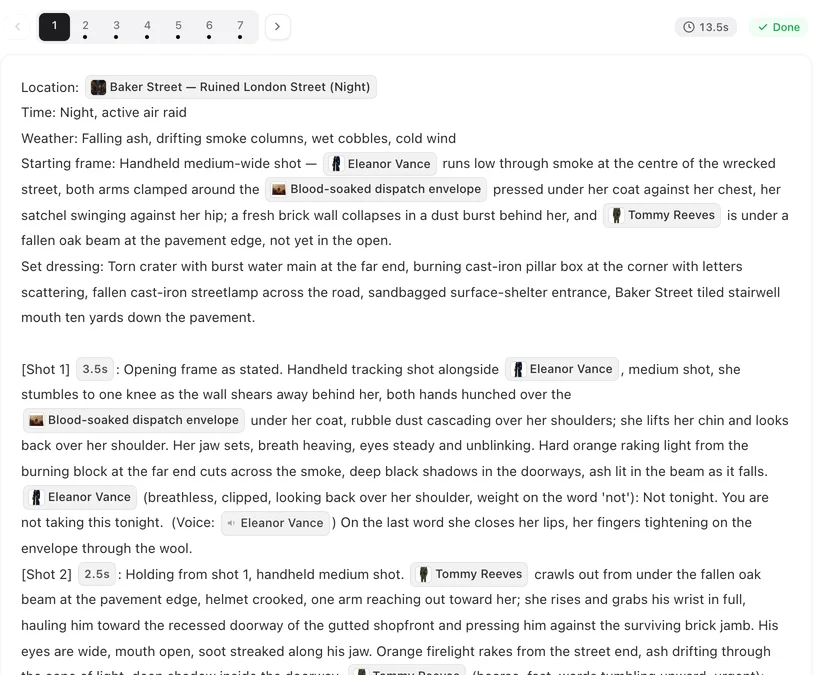
So schreibst du es
Blick: Blick nach rechts aus dem Bild, blickt direkt in die Linse, blickt nach unten und links. Ansprache: spricht in Richtung der Tür außerhalb des Bildes. Reaktion: zuckt zurück vor etwas links im Bild. Bewegung: geht nach rechts aus dem Bild. Links und rechts beziehen sich auf das Bild aus Sicht des Publikums. Hebe den Namen der anderen Person für die Aufnahmen auf, in denen sie tatsächlich zu sehen ist. So schreibst du eine einzelne Aufnahme.
Was die Seite für dich übernimmt
Bevor ein Clip generiert wird, werden Namen von Figuren, die nicht in der Aufnahme zu sehen sind, durch Richtungswörter ersetzt, und ihre Charakterbögen werden nicht eingebunden. Das Gleiche gilt für eine Figur, die in dieser Aufnahme nur als Leiche oder Körper existiert. Das ist ein Sicherheitsnetz: Eine Aufnahme, die mit Namen geschrieben und später bearbeitet wurde, kann daran vorbeischlüpfen – selbst verfasste Richtungsangaben lesen sich zudem besser.
Zwei Personen, die gemeinsam im Bild stehen müssen
Seitliche Zwei-Personen-Aufnahme: Beide im Profil oder Dreiviertelprofil, einander über das Bild hinweg zugewandt. Über-die-Schulter-Aufnahme: Die Schulter einer Person in der nahen Bildecke, das Gesicht der anderen dahinter. Das sind die zwei Möglichkeiten, mit denen eine Kamera zwei einander zugewandte Personen zeigen kann. „A steht B gegenüber, B im Hintergrund, unscharf“ verlangt, dass A gleichzeitig von B wegschaut und zu B hinschaut; das Modell wählt eine der beiden Optionen, und die Inszenierung bricht zusammen. Tiefenangaben (im Hintergrund, hinter) beschreiben Kamerapositionen; nutze sie nur, wenn die Geometrie passt. Räumliche Konsistenz.
Seiten konsistent halten
Sobald A in einer Aufnahme nach links aus dem Bild zu B blickt, blickt B in der Gegeneinstellung nach rechts aus dem Bild zu A. Halte das über das gesamte Segment hinweg ein; ein Seitenwechsel zwischen Aufnahmen wirkt so, als hätten die beiden die Plätze getauscht. Die Achsenregel des Storyboards ist genau dafür gedacht.
| Statt | Schreibe |
|---|---|
| Mei starrt Jun an (Jun nicht im Bild) | Mei starrt nach links aus dem Bild |
| Er antwortet Vater am Telefon | Er antwortet, Blick nach unten, Telefon am Ohr |
| Sie sieht Jun gehen | Sie sieht etwas nach rechts aus dem Bild gehen |
| A steht B gegenüber, B im Hintergrund | Über As Schulter: Bs Gesicht dahinter |
| Die Leiche von Wei zu ihren Füßen | Ein Körper zu ihren Füßen, mit dem Gesicht nach unten |
FAQ
Wenn die Seite Namen ohnehin korrigiert, warum muss ich darauf achten?
Die Korrektur ist ein Sicherheitsnetz, keine Garantie; außerdem sagt eine Richtungsangabe dem Modell, wohin es blicken soll – das tut ein entfernter Name nicht.
Darf ich eine Person außerhalb des Bildes nennen, die gerade spricht?
Markiere die Zeile als außerhalb des Bildes; der Name des Sprechers bleibt in der Dialogzeile, nicht im Bildtext.
Welches links ist mit „links im Bild“ gemeint?
Die linke Seite aus Sicht des Publikums, wenn es das Bild betrachtet.
Warum ist in einer Nahaufnahme ein zweites Gesicht aufgetaucht?
Fast immer wegen einer genannten Person außerhalb des Bildes. Ersetze den Namen durch eine Richtungsangabe.
Wie zeige ich zwei Personen im Gespräch?
Seitliche Zwei-Personen-Aufnahme oder Über-die-Schulter-Aufnahme; nichts anderes.
Zeige, benenne nicht
Richtungsangaben inszenieren die Aufnahme, ohne zusätzliche Personen ins Bild zu holen.
Aktualisiert am 27. September 2026
Preise·Anleitungen·Beispiele·Support·Datenschutz·AGB·Rechtliches·Kontakt·© 2026 SceneMixer