الجميع يبقى في مكانه

افتح حلقة منتهية، وابحث عن مشهد يضم شخصين أو أكثر على طاولة أو في سيارة، ثم شاهد القطع بينهم.
المشكلة التي يحلها هذا
تتكون المحادثة من ثلاث أو أربع لقطات: لها، له، للاثنين معًا، لها مرة أخرى. في غرفة حقيقية، تتوافق هذه اللقطات مع بعضها البعض. هي على يسار الطاولة في اللقطة الواسعة، لذا في لقطتها القريبة تكون النافذة خلفها، وعندما ننتقل بالقطع إليه يكون الباب على جانبه. هذا التوافق هو ما يجعل القطع غير مرئي.
عند توليد اللقطات واحدة تلو الأخرى دون ما يربطها ببعضها، تبتكر كل لقطة من تلك اللقطات الأربع غرفتها الخاصة. يشعر المشاهد بذلك قبل أن يستطيع تحديد ما هو الخطأ.
ما يفعله SceneMixer حيال ذلك
لكل مشهد، يبني SceneMixer نموذجًا ثلاثي الأبعادًا تلقائيًا بالذكاء الاصطناعي: المساحة، الأثاث المهم (الطاولة، السرير، المقاعد الأمامية للسيارة)، ومكانًا لكل شخصية موجودة. ثم يتم توليد كل لقطة في المشهد بناءً على ذلك النموذج الواحد. اللقطة الواسعة، اللقطات القريبة، واللقطة العكسية كلها تصف نفس الغرفة من مواضع مختلفة.
لن ترى النموذج أبدًا ولن تلمسه. يتم بناؤه من لوحة القصص التي لديك بالفعل ومن صورة المشهد.
ما يظل ثابتًا عبر القطع
المقاعد والمواضع. من جلس على رأس الطاولة يظل هناك في اللقطة التالية. الشخص في مقعد الراكب لا ينتقل إلى الخلف.
الجدران، النوافذ، الأبواب. النافذة التي كانت خلفها تظل خلفها. تُظهر اللقطة العكسية ما هو موجود فعليًا على الجانب الآخر من الغرفة، وليس غرفة جديدة.
من بجانب من. اليسار يظل يسارًا واليمين يظل يمينًا. عندما تذكر لوحة القصص أنها تواجهه، يتم وضع الكاميرا في المكان الذي يتحقق فيه ذلك.
من في الصورة. اللقطة المؤطرة لشخصين تُظهر هذين الشخصين، والشخص الواقف خلفهما يظهر حيث سيظهر فعليًا — أو لا يظهر على الإطلاق إذا كان خارج الإطار.
ماذا يعني ذلك لطريقة كتابتك
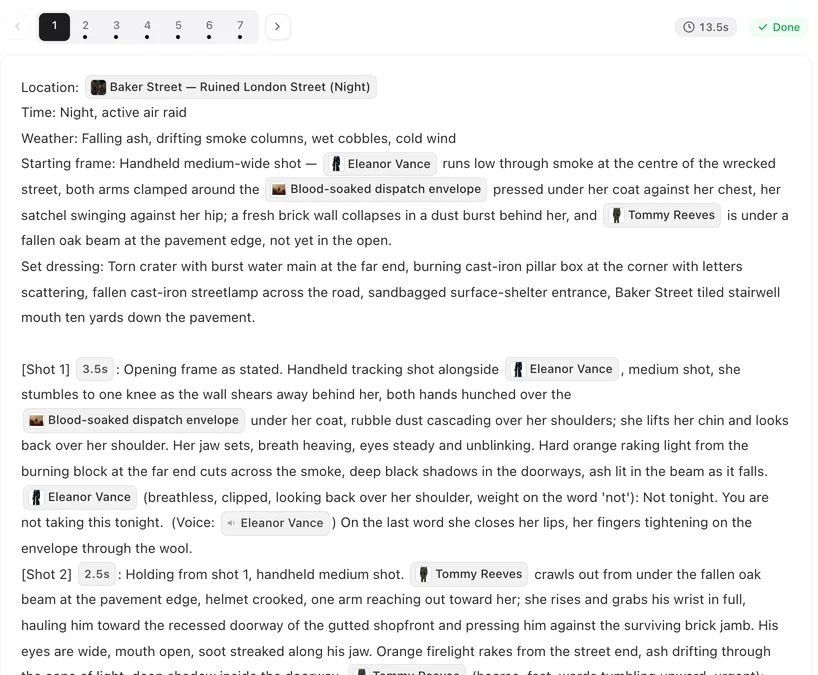
اكتب لوحة القصص بالطريقة التي تصف بها غرفة حقيقية. «تجلس مارا على رأس الطاولة، وجول على يمينها». «الباب خلفه». تُقرأ هذه الجمل، ويتبعها التمثيل المكاني. عندما لا تذكر شيئًا، يتم ترتيب المشهد بشكل منطقي لك ويُحافظ على ذلك الترتيب.
ليس عليك كتابة مواضع الكاميرا. إذا فعلت ذلك — «من فوق كتفها»، «من نافذة الراكب» — فسيتم احترامها حيث تسمح الغرفة بذلك. كيف تكتب لقطة واحدة.
أين ينطبق هذا
الغرف، المركبات، الطاولات، الممرات، السلالم، القاعات: أي مشهد يكون للأشخاص فيه مواضع محددة. المساحات الخارجية الواسعة التي يمشي فيها الأشخاص بحرية تستفيد منه بشكل أقل، لأن هناك أقل ما يمكن الحفاظ عليه. هذا المفعّل في كل مشروع؛ لا يوجد مفتاح تشغيل ولا تكلفة إضافية.
| بدون نموذج مشترك | مع التمثيل المكاني ثلاثي الأبعاد التلقائي بالذكاء الاصطناعي من SceneMixer |
|---|---|
| تتبادل الشخصيات الجوانب بين القطع | اليسار يظل يسارًا واليمين يظل يمينًا |
| تختلق اللقطة العكسية جدارًا جديدًا | تُظهر اللقطة العكسية الجانب الآخر الحقيقي للغرفة |
| شخص ما على الطاولة يختفي أو يتكرر | كل شخص موجود يظل موجودًا في مقعده |
| مشهد سيارة: السائق والراكب يتبادلان الأماكن | السائق يقود، والراكب يركب، والمقعد الخلفي يظل في الخلف |
| كل لقطة تحتاج وصفًا خاصًا بها للغرفة | تصف الغرفة مرة واحدة؛ وتتوافق اللقطات مع بعضها |
الأسئلة الشائعة
هل يجب عليّ إعداد المشهد ثلاثي الأبعاد بنفسي؟
لا. يتم بناؤه تلقائيًا من لوحة القصص وصورة المشهد. لن تراه أبدًا ولن تعدّله.
هل يكلف هذا كريديتس إضافية؟
لا. هو جزء من توليد اللقطة.
هل يمكنني التحكم في مكان جلوس الأشخاص؟
نعم، بكتابة ذلك في لوحة القصص: من على رأس الطاولة، من على يمين من، من في مقعد الراكب. يتبع التمثيل المكاني ما تكتبه.
هل يعمل هذا في الأماكن الخارجية؟
يعمل في أي مكان يكون للأشخاص فيه مواضع نسبية لبعضهم البعض وللأشياء الثابتة. الشارع المزدحم الذي يتحرك فيه الناس بحرية يوفر له ما يمكن التمسك به أقل من المطبخ أو السيارة.
ماذا لو ظهرت لقطة ما وشخص ما في الجانب الخطأ؟
أعد توليد تلك القطعة. تحقق من أن لوحة القصص تذكر كل شخص في اللقطة ولا تتناقض مع نفسها حول من هو أين.
تم التحديث في 26 سبتمبر 2026
الأسعار·الأدلة·العينات·الدعم·الخصوصية·الشروط·معلومات قانونية·تواصل معنا·© 2026 SceneMixer