Panduan prompt MiniMax H3: shot, potongan, dan referensi
Apa yang berbeda dari penulisan untuk keluarga ini
Anda tidak menulis prompt untuk model video di kotak terpisah. Anda menulis shot-shot sebuah segmen di storyboard, dalam format yang sama untuk semua tingkatan — penanda dan durasi detik, komposisi dan kamera, siapa yang ada di gambar, apa yang terjadi, baris dialog, apa yang kita dengar — dan situs mengubah segmen tersebut menjadi satu permintaan. Yang diubah oleh MiniMax H3 adalah ukuran permintaan tersebut. Satu segmen maksimal 15 detik, selalu dirender dengan suara, dan beberapa potongan bisa ada di dalamnya, sehingga percakapan singkat beserta reaksinya dihasilkan sebagai satu bagian alih-alih disambung dari render terpisah.
Hal ini membuat keluarga ini cocok untuk adegan singkat yang padat: konfrontasi yang berbalik arah, pengungkapan rahasia beserta reaksinya, pertukaran dua baris dialog. Kurang cocok untuk adegan yang membutuhkan satu take panjang tanpa potongan atau pemeran banyak, dan bagian di bawah ini menjelaskan apa yang harus dilakukan untuk masing-masing kasus.
Tulis shot-nya, lalu durasi detiknya

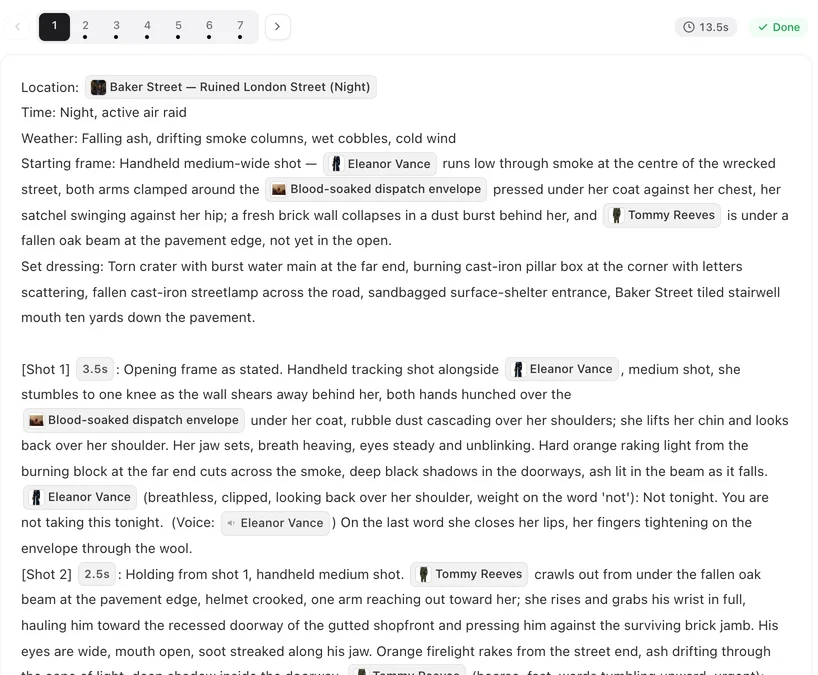
Gambar diam di atas berasal dari Rocket Pup, sebuah episode yang dikerjakan situs ini dari naskah hingga komposit di Wan 3.0 · 720P; tata bahasa shot yang digunakan sama dengan yang dipakai segmen MiniMax H3, hanya ukuran take-nya yang berbeda.
Setiap shot dimulai dengan penanda dan durasi detiknya. Durasi detik bukan hiasan: sebuah segmen adalah satu generasi dan panjangnya adalah jumlah total shot-nya, jadi perhitungannya harus pas sebelum Anda merender. Shot dengan dialog butuh ruang untuk mengucapkannya — sekitar tiga kata bahasa Inggris per detik — dan shot yang hanya berupa tatapan bisa singkat. Berikut adalah segmen empat shot dengan sisa waktu, ditulis sesuai cara penulisan segmen di sini:
[Shot 1] 4s: Shot medium, kamera diam. @Mara di ujung meja, @Jules di kanannya. Dia menggeser @Surat tersegel ke seberang. @Mara (pelan, tenang): Baca dulu sebelum kamu menolak. (suara: 🔊Mara) Hujan di jendela.
[Shot 2] 3s: Potong ke close-up. Hanya di bingkai: @Jules. Dia menunduk melihat surat, rahang mengeras. Tidak ada dialog.
[Shot 3] 5s: Potong ke shot medium, kamera genggam. @Jules mendorong kursinya dan berdiri. @Jules (geram): Kamu tidak punya hak. (suara: 🔊Jules)
[Shot 4] 3s: Potong ke close-up. Hanya di bingkai: @Mara. Dia tidak memalingkan pandangan. Tidak ada dialog. Suara ambient: jam di lorong.
Perhatikan apa yang tidak dilakukan setiap shot: tidak ada yang mengubah komposisi di tengah jalan, tidak ada yang menampung dua aksi, dan shot tanpa suara menyatakannya dengan jelas, jadi tidak ada karakter yang dipaksa bicara. Kebiasaan ini lebih penting di sini daripada pada take yang tidak pernah dipotong, karena potongan adalah struktur dari render tersebut.
Tulis potongannya ke dalam daftar shot
Karena shot-shot sebuah segmen dirender bersama, potongan di antara keduanya dibuat di dalam render dan bukan oleh Anda di editor. Perlakukan setiap shot baru sebagai potongan ke komposisi baru dan tuliskan demikian — Potong ke close-up:, Potong ke wide shot: — dan ketika orang yang sama ada di dua shot berturut-turut, ubah komposisi atau sudutnya di antara keduanya. Tanpa itu, sambungannya akan terlihat seperti lompatan.
Kebalikannya juga berlaku. Jika Anda ingin kamera tetap mengikuti satu objek, tulislah sebagai satu shot panjang dan berikan durasi detik yang dibutuhkan; jangan potong-potong menjadi beberapa shot hanya karena keluarga ini bisa memotong. Satu shot yang dipertahankan juga cara Anda menjaga aksi tetap utuh, itulah alasan untuk memindahkan adegan ke keluarga dengan batas durasi lebih panjang ketika seluruh adegan tidak muat dalam 15 detik.
Jaga baris dialog tetap singkat dan satu pembicara per shot
Dialog dan suara ambient adalah bagian dari setiap generasi di keluarga ini; tidak ada mode senyap, jadi shot tanpa suara harus ditulis Tidak ada dialog alih-alih membiarkan model menebak. Berikan setiap baris dialog shot-nya sendiri ketika dua orang berbicara dan biarkan reaksinya menjadi shot berikutnya, alih-alih memadatkan percakapan ke dalam satu baris teks panjang. Kalimat pendek juga mengurangi risiko kesalahan.
Rencanakan referensi sebelum Anda menulis
Di sinilah segmen H3 paling sering mengecewakan, dan ini soal perhitungan bukan soal prompt. Satu segmen menerima hingga sembilan gambar dan tiga klip suara, dengan total durasi suara sekitar empat belas detik, dan klip suara hanya berfungsi jika ada gambar yang dilampirkan bersamanya. Ketika sebuah segmen meminta lebih dari itu, situs akan menghilangkan referensi yang paling tidak penting terlebih dahulu, jadi gejala yang biasa muncul bukanlah kesalahan, melainkan suara yang berubah atau properti yang kehilangan lembar referensinya.
Jadi tulislah segmen sesuai dengan anggaran referensi. Sebutkan hanya orang-orang yang ada di gambar. Adegan dengan empat pembicara memiliki satu suara tambahan yang berlebih — bagi menjadi dua segmen atau terima bahwa pembicara tambahan tersebut disuarakan dari deskripsi tertulis di catatan pengiriman. Kerumunan tidak butuh lembar referensi untuk setiap wajah; deskripsikan kerumunan dengan kata-kata dan gunakan gambar untuk orang-orang yang akan difokuskan kamera. Tabel referensi keluarga ini ada di halaman tingkatan masing-masing, dan MiniMax H3 dan aturannya sendiri mencantumkannya secara lengkap.
Kapan harus menulis adegan ini untuk keluarga yang berbeda
Jika satu aksi harus berjalan utuh lebih lama dari 15 detik, atau pemerannya cukup banyak sehingga setiap wajah butuh lembar referensinya sendiri, shot-shot yang sama sebaiknya diletakkan di keluarga dengan batas durasi lebih panjang dan anggaran referensi lebih luas: langkah Wan dan tingkatan Seedance 2.5 menerima hingga 30 detik per generasi dengan hingga sepuluh gambar dan lima klip suara. Perbandingannya ada di kapan memilih MiniMax H3 daripada Wan; tingkatan yang bersebelahan ada di Seedance 2.5 dibanding MiniMax H3.
FAQ
Bagaimana cara menulis prompt untuk MiniMax H3 di situs ini?
Anda menulis shot di storyboard, bukan prompt bebas: penanda dan durasi dalam detik, framing serta kamera, siapa yang ada di gambar, apa yang terjadi, dialog, dan suasana. Total durasi semua shot menjadi satu hasil generasi, yang bisa mencapai 15 detik pada MiniMax H3 dan MiniMax H3 Fast.
Bisakah satu segmen MiniMax H3 memuat beberapa shot?
Bisa. Semua shot dalam satu segmen digabung dalam satu generasi, sehingga dialog dan reaksinya bisa keluar sebagai satu hasil render. Tulis setiap shot sebagai potongan ke framing baru, dan pastikan total durasinya sesuai.
Mengapa suara saya berubah antar segmen pada family ini?
Biasanya karena batas referensi: satu segmen menggunakan maksimal sembilan gambar dan tiga klip suara, dan jika butuh lebih banyak, referensi yang paling tidak penting akan diabaikan terlebih dahulu. Kurangi jumlah orang yang disebut di segmen tersebut, atau bagi menjadi beberapa segmen.
Apakah MiniMax H3 Fast menggunakan format shot yang sama dengan MiniMax H3?
Ya. MiniMax H3 Fast adalah versi dengan resolusi lebih rendah dan harga lebih murah, dengan batas maksimal segmen, suara, dan referensi yang sama, seharga 16 kredit per detik dibandingkan 25 pada MiniMax H3, sehingga daftar shot yang disusun untuk satu versi bisa dirender tanpa perubahan di versi lainnya.
Kapan saya harus menulis untuk take yang lebih panjang?
Ketika satu aksi berkelanjutan membutuhkan lebih dari 15 detik, atau ketika pemeran membutuhkan lebih dari sembilan gambar. Keduanya adalah alasan untuk memindahkan adegan tersebut ke family dengan batas durasi yang lebih panjang.
Tulis segmen pertama dan lihat total durasinya
Tempel naskah, buka segmen di storyboard, dan render di tier draf sebelum Anda memutuskan untuk menyelesaikannya.
Diperbarui 14 Oktober 2026
Harga·Panduan·Contoh·Alternatif·Tanya Jawab·Dukungan·Privasi·Ketentuan·Informasi hukum·Hubungi kami·Program afiliasi·© 2026 SceneMixer