Kling 3.0 多鏡頭與原生音訊:這個模型做了什麼

Kling 3.0 公布了什麼
上面的劇照來自在本站製作的 Crimson Vow;下方的分鏡截圖,就是決定它各個鏡頭的那一頁。
Kling 3.0 與 3.0 Omni 在 2026 年 2 月公布(一份日期為 2026 年 2 月 6 日的新聞稿,以及 Kling 自己部落格上的資料)。最主要的功能是多鏡頭生成:一次生成就產出多個鏡頭,鏡頭之間有剪接,而不是單一不間斷的運鏡。
依公布內容:一個鏡次為 3–15 秒;一次生成可以包含最多 6 次鏡頭切換;每個鏡頭都可以有自己的時長、構圖、角度、內容和運鏡。Kling 的部落格描述了一個 AI Director,可處理鏡次內的正反打對話與交叉剪接。第三方對同一次發布的報導,則把這項功能稱為 Smart Storyboard 和 Custom Storyboard。
使用權限在 Kling 那邊是分檔的:官方頁面表示,要解鎖 3.0 需要 Pro、Premier 或 Ultra 會員。
原生音訊:公布內容的另一半
Kling 3.0 一次生成影片與音訊,而不是事後再配音。公布的語言有英文、中文、日文、韓文和西班牙文,並含各種口音(包括美式、英式和印度英文,以及多種中文方言)。在多人說話的場景中,公布的行為是把台詞分配給正確的說話者。
實際的影響在於時間掌控。當台詞是渲染的一部分,嘴型動作、停頓和鏡頭長度會一起決定;如果台詞是事後才加,就得有人去調整其中一方來遷就另一方。原生生成對白背後的道理,在 原生對白 vs 後期配音中有更深入的說明。
參考模式與 Character Identity 3.0
公布的模式有文字生影片、圖片生影片、首尾幀、多圖參考、元素參考(主體 — 人物、物件、地點),以及影片元素參考。
Character Identity 3.0 是一致性的那一層:可以用參考影片或多張圖片來定義角色。依 Kling 的建議,最強的一致性來自約 3–8 秒的角色影片。元素(Element)也可以綁定聲音(Element Voice Control),讓同一個主體出場時聲音也一致。
最後一項值得一提的公布功能是畫面文字:招牌、字幕和標誌在動態中仍保持清晰可讀,這對任何靠招牌傳達劇情資訊的鏡頭來說都很重要。
一個鏡次六個鏡頭:寫法會有什麼改變
能在內部剪接的生成,改變了一個鏡次的用途。你寫的不再是單一運鏡,而是一段短序列:定場鏡頭、反應鏡頭、雙人鏡頭、插入鏡頭 — 剪接點已經在片段裡了。
隨之而來有兩個後果,都關乎剪輯紀律,而不是模型:
- 鏡次內鏡頭之間的剪接,在生成時就決定了。是你寫出來的,不是之後在剪輯裡才找到的。這更接近分鏡,而不是提示詞。
- 鏡次內的每個鏡頭仍然需要各自的資訊 — 誰在畫面內、持續多久、說了什麼。一個六鏡頭的鏡次,就是六個共用同一個鏡次編號的小場景。
分鏡的概念,往上一層
Kling 3.0 要求寫作者提供的一切 — 鏡頭邊界、逐鏡頭時長、構圖、誰在畫面內、說了什麼 — 本來就是分鏡的內容。模型只是把紙上的這一步變成了輸入的一部分。
這與本站處理系列作品的結構相同。劇本會被讀成一集一集;每一集有一份由片段組成的分鏡;每個片段包含編號鏡頭,每個鏡頭都帶有它的秒數、入鏡人物和要說的台詞。片段再逐一渲染,合成每集一個檔案。如何製作 AI 短劇會帶你從頭到尾走完整個流程。
所以如果你是從 Kling 3.0 過來的,可以這樣對照:模型所說的一次多鏡頭生成,就是分鏡頁所說的一個片段;模型所說的有時長和構圖的鏡頭,就是分鏡所說的附有秒數的編號鏡頭。用語不同,紀律相同,而這正是可以帶著走的部分。
這裡的分鏡長什麼樣
本編輯器中的片段簡短而具體。開頭先寫地點與時間(場景、時段、天氣),再列出編號鏡頭。每一行鏡頭都帶有以秒為單位的時長、實際入鏡的角色,以及任何台詞,聲音則另外註記。編輯這些文字是免費的;重新生成片段才會花錢。
有兩個習慣,讓六鏡頭的寫法不論在哪一邊都行得通:
- 每個鏡頭一個節拍。如果一個鏡頭裡同時發生兩件事,那就是兩個鏡頭。鏡次內的剪接仍然是剪接。
- 如實寫出入鏡名單。點名一個鏡頭裡看不見的人,是畫面偏離計畫最常見的原因之一。如何寫好一個鏡頭說明哪些內容該放進那一行、哪些不該。
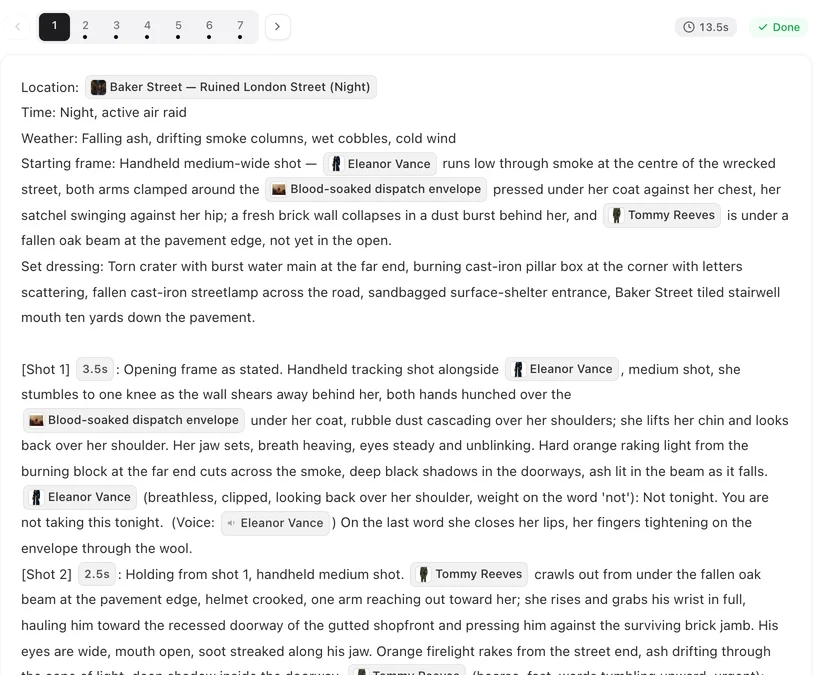
兩種做法的差異
多鏡頭生成在生成當下就決定剪接點,全都在同一個鏡次內。本站則是在 片段之間剪接:每個片段各自渲染成一個鏡次,再由整集合成把它們接起來。取捨很直接 — 內部剪接換來場景內的連貫,代價是事後無法重剪;分開的片段則讓每個接合處都能單獨檢視、單獨重新渲染。
做系列作品時,不論哪種做法,實務模式都一樣:先在劇本裡定好故事,在分鏡裡定好鏡頭清單,然後才花渲染的時間。只改一個鏡頭而不必重做整集就是這套紀律在本站的實踐。
關於這次公布,要記住幾件事
- 3.0 的數字只屬於 3.0。3–15 秒和 6 個鏡頭說的是 3.0;之後公布的 4.0 又把數字往上調了。請拿同一個版本來比較。
- 需要會員資格。官方頁面把 3.0 的使用權限綁在 Kling 的付費會員檔位上;免費檔位用不到。
- 第三方的名稱是行銷用語。“Smart Storyboard” 和 “Custom Storyboard” 來自這次發布的媒體報導;Kling 自己的部落格把同樣的功能描述為搭配 AI Director 的多鏡頭生成。
- 角色影片的長度範圍。要獲得最強角色一致性的 3–8 秒建議,是 Kling 自己的建議,並非限制你能嘗試的素材格式。
資料來源
- Kling:Video 3.0 Omni 多鏡頭與原生音訊指南(kling.ai 部落格,2026 年 6 月) — 鏡頭數量、時長、音訊語言、參考模式與 Character Identity 3.0。
- Bernama:Kling 3.0 新聞稿(2026 年 2 月 6 日) — 發表資訊與模型清單(Video 3.0、Video 3.0 Omni、Image 3.0、Image 3.0 Omni)。
Kling 是其所有人的商標,此處僅用於標示產品;SceneMixer 與其無任何關聯。規格依公布內容引述,之後可能變動。
| Kling 3.0 公布的內容 | 項目 |
|---|---|
| 鏡次長度 | 3–15 秒 |
| 每次生成的鏡頭數 | 最多 6 次鏡頭切換 |
| 逐鏡頭設定 | 時長、構圖、角度、內容、運鏡 |
| 原生音訊語言 | 英文、中文、日文、韓文、西班牙文 |
| 角色參考 | Character Identity 3.0;3–8 秒的角色影片可帶來最強的一致性 |
常見問題
什麼是多鏡頭生成?
一次生成就包含多個鏡頭、鏡頭之間有剪接,而不是單一不間斷的運鏡。Kling 3.0 公布每次生成最多可切換 6 個鏡頭,每個鏡頭各有自己的時長、構圖、角度、內容和運鏡。
Kling 3.0 的一個鏡次有多長?
依公布內容為 3 到 15 秒。後來公布的 Kling 4.0 把上限提高到 30 秒,所以請確認頁面談的是哪個版本。
Kling 3.0 會生成聲音嗎?
會,音訊與影片在同一次生成中產出,公布的對白語言有英文、中文、日文、韓文和西班牙文,含各種口音與中文方言,多人場景中也會把台詞分配給正確的說話者。
什麼是 Character Identity 3.0?
Kling 的角色一致性功能:用參考影片或多張圖片定義角色,並重複使用該角色身分。依 Kling 的建議,3-8 秒的角色影片能帶來最強的一致性。
角色能保持自己的聲音嗎?
公布內容包含 Element Voice Control,可將聲音綁定到被參考的主體上,讓同一個角色出場時聲音也一致。
使用 Kling 3.0 需要付費會員嗎?
Kling 官方頁面表示,要解鎖 3.0 需要 Pro、Premier 或 Ultra 會員。
這和分鏡有什麼關係?
多鏡頭生成是一個鏡頭一個鏡頭寫出來的:時長、構圖、畫面內有誰、說了什麼。這正是分鏡頁所記錄的內容,也是本站撰寫每一集的方式,由編號鏡頭組成的片段,附上秒數、入鏡角色和台詞。
本站的創作工具是用 Kling 3.0 渲染的嗎?
不是。本頁描述的是 Kling 公布的內容。本站可用的影片檔位及其價格與限制,列在價格頁上,其中沒有 Kling。
我可以在哪裡讀到原始資料?
Kling 自己關於 Video 3.0 Omni 多鏡頭與原生音訊的部落格文章,以及 2026 年 2 月的新聞稿。兩者都列在本頁最後的資料來源一節。
更新於 2026 年 10 月 15 日
價格方案·使用指南·作品範例·替代方案·常見問題·支援服務·隱私權政策·服務條款·法律資訊·聯絡我們·推廣夥伴計劃·© 2026 SceneMixer